
سلام. من امیر داعی هستم و با قسمت ششم از مجموعه هوش مصنوعی برای همه در خدمتتونم. تو قسمت قبل تا حد خوبی با کانسپت شبکه های عصبی آشنا شدیم. البته هنوز خیلی چیزا باید روشن بشه، مثلا چجوری با over-fit کنار بیایم، دیتا چجوری باید پیش پردازش بشن و ... ولی مهم تر از همه اینه که شبکه چجوری آموزش داده میشه!
تو قسمت قبل گفتیم که پروسه یادگیری تو شبکه های عصبی در واقع پیدا کردن وزن های مناسب سیناپس هاست، جوری که خطای متناظر خروجی شبکه عصبی به ازای ورودی هامون کمترین مقدار بشه و با توجه به اینکه در اکثر شرایط تعداد وزن هامون خیلی بیشتر از data point های آموزشه پس یک جواب یکتا هم براشون نداریم (همون داستان over-fit و ...) و معادله ای که باید بهینه سازی (تا ازش وزن ها بدست بیان) بشه خیلی پیچیده اس، پس حل جبری و دقیق کلا دردسترس نیست. متد های بهینه سازی عددی اینجا به کار میان (مثل ژنتیک الگوریتم یا ژاکوب و ...) ولی از همه پر کاربرد تر متدیه به اسم Stochastic Gradient Descent یا به اختصار SGD. احتمالا همینجا برای حرفه ای ها سوال پیش بیاد که مثلا الگوریتم ژنتیک خیلی روش خوبیه و به جوابای نسبتا دقیقی میرسه در اکثر شرایط، پس چرا از SGD استفاده میشه. بله از ژنتیک هم گاها استفاده میشه (برای مثال متدی به نام NEAT برای بهینه سازی شبکه از همین الگوریتم استفاده میکنه) ولی به توجه به زیاد بودن تعداد وزن ها این الگوریتم ها خیلی خیلی خیلی طول میکشه که به جواب برسن و در عمل خیلی کاربردی نیستن.
متد SGD به زبون ساده اول میاد بررسی میکنه هر کدوم از وزن ها در کدوم جهت تغییر کنن (زیاد یا کم شدن مقدارشون) موجب کم شدن خطای مدل میشن و هرکدوم رو در اون جهت به اندازه مشخصی (Learning Rate یا LR) تغییر میدن.
اول از همه نیاز به یه مکانیزم (یا به اصطلاح دقیق تر تابع)ی داریم که بهمون مقدار خطا رو نشون بده. توابع خطا (Loss Function یا Fitness Function) های مختلفی برای ANN استفاده میشه ولی در اکثر قریب به اتفاق موارد از توابع زیر استفاده میشه:
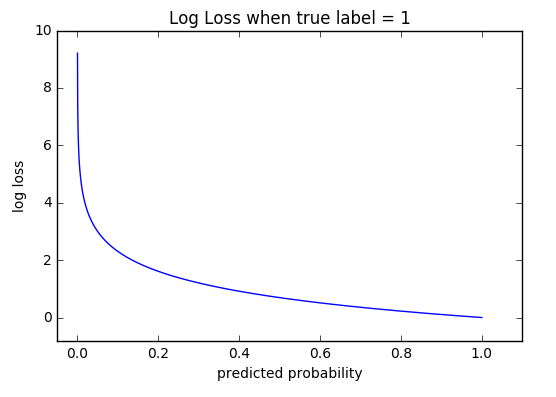
برای شروع پروسه آموزش با SGD اول مقدار همه وزن ها رو به صورت رندوم میذاریم (البته متد هایی امروزه استفاده میشه که ذاتا رندوم هستن ولی یه سری قواعدی دارن که یادگیری رو راحت تر و سریعتر میکنن مثل lecun یا glorot).
حالا اینکه چجوری باید بفهمیم به ازای تغییر در چه جهتی روی وزن ها مقدار خطای مدل کمتر میشه، وارد مبحث جبر خطی میشه. گرادیان در واقع بیانگر مقدار تغییر تابع به ازای هرکدوم از ابعاد تابع هست و این گرادیان رو به ازای وزن ها به صورت عددی در پروسه یادگیری محاسبه میکنیم. جهتی که گرادیان بیشترین مقدار منفی رو داره، جهتی هست که تابع خطا رو به بیشترین مقدار کم میکنه. اینکه این گرادیان چجوری باید محاسبه بشه هم طولانیه و هم اینجا نمیشه راحت ریاضی نوشت (مثل لاتکس) و واقعا معذورم از توضیح ریاضیاتیش؛ ولی یه مقاله اینجا هست که میتونید خودتون بخونید (راحت توضیح داده)?.
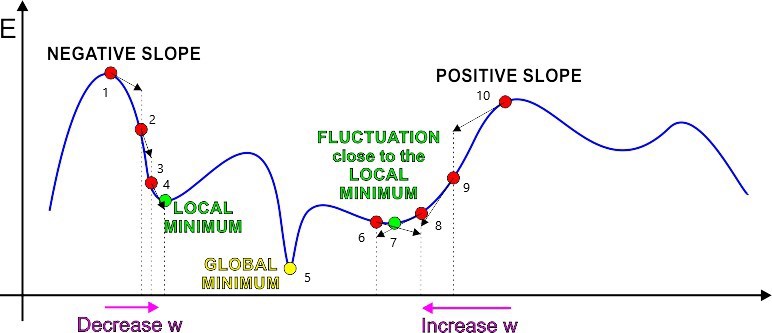
حالا میدونیم تغییر هر وزن در کدوم جهت، چقد در مقدار خطا موثره و مقدار وزن ها رو به مقدار ثابتی به اسم LR که بالاتر گفتم تغییر میدیم و کل این پروسه رو اینقد تکرار میکنیم که تغییرات در وزن تاثیری در کاهش خطا نشون ندن یا گرادیان وزن ها غیر منفی بشه کلا.
سوالی که پیش میاد اینه که ممکنه در local minima گیر کنیم. مثلا در شکل بالا هدف ایده آلمون رسیدن به اون نقطه طلاییه اس، ولی میبینید وقتی به اون نقاط سبز میرسیم رسما گرادیان صفر یا حداقل غیر منفی میشه و در هر جهتی حرکت کنیم دوباره برمیگردیم به همون نقاط سبز.اولا چون تعداد متغیر هامون خیلی بیشتره از تعداد data-point ها، پس رسیدن به اون نقطه طلاییه واقعا غیر ممکنه چون فضای بهینه سازیمون ابعادش خیلییی بالاس و خیلی هم local minima داره (که local minima هم میتونه تو over-fit خودشو نشون بده و هم کلا خطای دیتا آموزش هم اونقدری که میخوایم کم نشه)، ولی تلاش میکنیم که حداقل در local minimaیی گیر کنیم که مقدار خطاش زیاد نباشه و بتونه بخوبی هم تعمیم بده.
چیکار کنیم که local minima کمتر توی حاصل مدلمون تاثیر بذاره؟ چجوری از over-fit جلوگیری کنیم؟ این دیگه باشه برای هفته آینده :)
برای نوشتن بخش بعدی نیاز دارم بدونم این مطلب چقدر برای مخاطبان قابل فهم بوده و چه جاهایی گنگ بوده. خوشحال میشم به من فیدبک بدید (اعم از خوب و بد). آی دی تلگرام: @amir_daaee
منتظر مطالب بعدی من باشید...

