
تصور کنید یک مهندس بسیار سریع را در اختیار دارید که میتواند در هر ثانیه هزاران محاسبه انجام دهد؛ اما برای انجام هر محاسبه باید منتظر بماند تا اطلاعات موردنیازش از یک انبار دوردست به دستش برسد.
هرچقدر هم این مهندس سریعتر شود، اگر اطلاعات با سرعت کافی به او نرسند، بخش زیادی از تواناییاش بلااستفاده باقی میماند.
این اتفاق در دنیای پردازندهها هم رخ میدهد.
پردازندههای امروزی قادرند میلیاردها چرخه پردازشی در هر ثانیه اجرا کنند و در هر چرخه، بسته به معماری، چندین دستور را پردازش کنند. اما حافظه اصلی سیستم، یعنی RAM، نمیتواند همیشه دادهها را با همان سرعت در اختیار پردازنده قرار دهد.
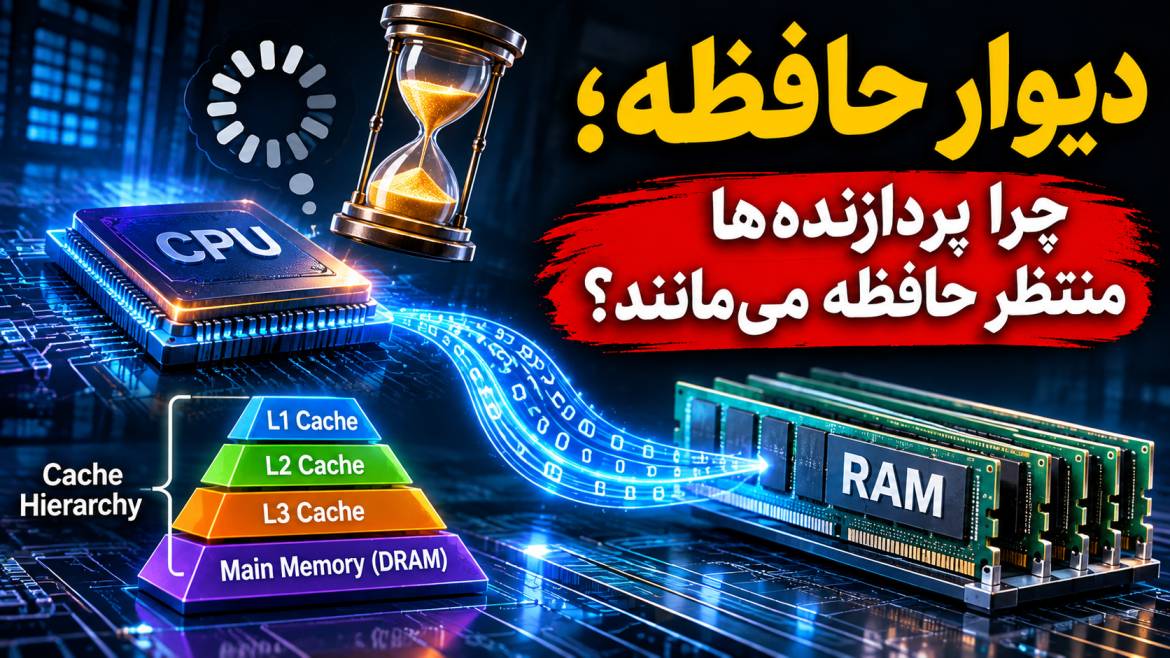
این فاصله میان سرعت پردازنده و عملکرد حافظه، یکی از مسائل اساسی در طراحی سیستمهای کامپیوتری است که با نام Memory Wall شناخته میشود.
اما چرا چنین فاصلهای به وجود آمده است؟ چرا نمیتوانیم حافظهای بسازیم که بهاندازه پردازنده سریع باشد؟ و Cache دقیقاً چگونه به حل این مشکل کمک میکند؟
برای پاسخ به این پرسشها، باید ابتدا نحوه ارتباط پردازنده و حافظه را بشناسیم.
پردازنده یا CPU مسئول اجرای دستورالعملها و انجام عملیات محاسباتی است.
برای مثال، هنگام اجرای یک برنامه ممکن است پردازنده نیاز داشته باشد:
مقدار یک متغیر را از حافظه بخواند.
دو عدد را با یکدیگر جمع کند.
نتیجه را در یک متغیر دیگر ذخیره کند.
دستور بعدی برنامه را اجرا کند.
عملیات محاسباتی ممکن است بسیار سریع انجام شود؛ اما خواندن داده از حافظه اصلی میتواند زمان بیشتری نیاز داشته باشد.
این موضوع اهمیت زیادی دارد؛ زیرا پردازنده برای انجام بسیاری از عملیاتها به دادههایی وابسته است که باید از حافظه دریافت شوند.
اگر داده موردنیاز هنوز آماده نباشد، دستور وابسته به آن نمیتواند کامل شود.
در معماری کامپیوتر، به این وضعیت معمولاً Memory Stall گفته میشود.
به بیان ساده، پردازنده ممکن است از نظر توان محاسباتی آماده باشد، اما به دلیل آماده نبودن دادهها نتواند از تمام ظرفیت خود استفاده کند.
البته این به معنای توقف کامل CPU نیست. پردازندههای مدرن میتوانند در بسیاری از شرایط، دستورهای مستقل دیگری را اجرا کنند تا بخشی از زمان انتظار پنهان شود. بااینحال، وابستگیهای دادهای و محدودیت منابع سختافزاری همیشه اجازه چنین کاری را نمیدهند.
Memory Wall به شکاف عملکردی میان پردازنده و حافظه اشاره دارد؛ شکافی که در طول سالها با افزایش سرعت پردازندهها و رشد نیازهای محاسباتی اهمیت بیشتری پیدا کرده است.
مسئله فقط این نیست که RAM کندتر از CPU است. مسئله این است که سرعت افزایش توان پردازشی و سرعت بهبود تأخیر دسترسی به حافظه، الزاماً با یکدیگر هماهنگ نیستند.
برای درک بهتر، دو مفهوم مهم را باید از هم جدا کنیم:
Memory Latency — تأخیر حافظه
مدتزمانی است که طول میکشد تا پس از درخواست دسترسی، داده موردنیاز در اختیار درخواستکننده قرار بگیرد.
برای مثال، اگر پردازنده درخواست خواندن یک مقدار از RAM را ارسال کند، Latency نشان میدهد چه مدت باید تا دریافت داده منتظر بماند.
Memory Bandwidth — پهنای باند حافظه
میزان دادهای است که حافظه میتواند در یک بازه زمانی منتقل کند.
برای مثال، حافظهای با پهنای باند بالاتر میتواند در هر ثانیه حجم بیشتری از اطلاعات را منتقل کند.
این دو مفهوم یکسان نیستند.
ممکن است حافظهای پهنای باند بالایی داشته باشد، اما برای دریافت اولین داده همچنان تأخیر قابلتوجهی وجود داشته باشد.
به همین دلیل، افزایش Bandwidth همیشه به معنای کاهش Latency نیست.
شاید سؤال طبیعی این باشد:
اگر سرعت حافظه چنین محدودیتی ایجاد میکند، چرا تمام حافظه را با فناوری بسیار سریعتری نمیسازیم؟
پاسخ به چند محدودیت مهندسی مربوط است:
۱. هزینه ساخت
حافظههای بسیار سریع معمولاً هزینه بیشتری به ازای هر بیت ظرفیت دارند. بنابراین ساخت حافظهای بسیار بزرگ با سرعتی مشابه حافظههای کوچک و سریع، از نظر اقتصادی و طراحی تراشه دشوار است.
۲. مصرف انرژی
دسترسی به حافظه، انتقال داده و نگهداری حجم زیادی از اطلاعات، انرژی مصرف میکند. افزایش سرعت و پهنای باند نیز میتواند با هزینه انرژی و حرارت همراه باشد.
۳. محدودیت فیزیکی و معماری
فاصله فیزیکی، سیمکشی، ارتباطات داخلی تراشه و محدودیتهای رابط حافظه، همگی بر زمان انتقال داده اثر میگذارند.
۴. چگالی و ظرفیت
حافظهای که برای سرعت بسیار بالا طراحی شده، الزاماً نمیتواند با همان هزینه و فضای فیزیکی، ظرفیت زیادی فراهم کند.
در نتیجه، طراحان کامپیوتر بهجای استفاده از یک نوع حافظه برای تمام نیازها، از ساختاری چندلایه استفاده میکنند.
این ساختار همان Memory Hierarchy است.
در یک سیستم کامپیوتری مدرن، دادهها در سطوح مختلفی از حافظه نگهداری میشوند.
هرچه به هسته پردازنده نزدیکتر شویم، معمولاً حافظه کوچکتر و سریعتر میشود. هرچه از پردازنده دورتر شویم، امکان استفاده از ظرفیتهای بزرگتر با هزینه کمتر فراهم میشود، اما دسترسی به دادهها زمان بیشتری میبرد.
یک نمای ساده از سلسلهمراتب حافظه:
Registers
L1 Cache
L2 Cache
L3 Cache
Main Memory (DRAM)
Storage (SSD / HDD)
این ترتیب یک نمای مفهومی است؛ جزئیات دقیق ساختار Cache و ارتباط آن با هستهها در معماریهای مختلف متفاوت است.
Registerها حافظههای بسیار کوچکی هستند که داخل هسته پردازنده قرار دارند.
دادههایی که مستقیماً در عملیات پردازشی استفاده میشوند، میتوانند در Registerها قرار بگیرند.
برای مثال، هنگام جمع دو عدد، ممکن است مقادیر ورودی در Registerها قرار داشته باشند و واحد محاسباتی ALU عملیات جمع را انجام دهد.
Registerها بسیار سریعاند، اما ظرفیت آنها محدود است.
Cache نوعی حافظه سریع است که برای نگهداری نسخهای از دادهها و دستورالعملهای موردنیاز پردازنده استفاده میشود.
ایده اصلی ساده است:
اگر پردازنده احتمالاً دوباره به دادهای نیاز پیدا میکند، بهتر است آن داده را در حافظهای نزدیکتر و سریعتر نگهداری کنیم.
Cache معمولاً در چند سطح طراحی میشود:
L1 Cache
بسیار کوچک و سریع
نزدیک به هسته پردازنده
معمولاً به Cache دستورالعمل و Cache داده تقسیم میشود.
L2 Cache
معمولاً بزرگتر از L1
دسترسی به آن معمولاً کمی کندتر است.
میتواند بخشی از دادههایی را نگهداری کند که در L1 وجود ندارند.
L3 Cache
معمولاً از L1 و L2 بزرگتر است.
در بسیاری از پردازندهها میان چند هسته مشترک است.
میتواند تعداد بیشتری از دسترسیها را بدون مراجعه به RAM پاسخ دهد.
این ویژگیها به معماری پردازنده وابستهاند و در همه CPUها یکسان نیستند.
فرض کنید پردازنده به دادهای نیاز دارد.
ابتدا Cache مربوطه بررسی میشود.
اگر داده موردنیاز در Cache موجود باشد، اتفاقی به نام Cache Hit رخ میدهد.
در این حالت، داده از Cache دریافت میشود و پردازنده معمولاً سریعتر از زمانی که باید به RAM مراجعه کند، به آن دسترسی پیدا میکند.
اما اگر داده در Cache موجود نباشد، با Cache Miss مواجه میشویم.
در این شرایط، سیستم باید داده را از سطح دیگری از سلسلهمراتب حافظه دریافت کند؛ برای مثال از L2، L3 یا در نهایت حافظه اصلی.
این فرایند میتواند تأخیر قابلتوجهی ایجاد کند.
نکته مهم این است که Cache Miss همیشه به معنای مراجعه مستقیم به RAM نیست؛ ممکن است داده در سطح دیگری از Cache موجود باشد.
بنابراین، عملکرد سیستم تا حد زیادی به این بستگی دارد که برنامهها و دادههای موردنیازشان چگونه از Cache استفاده میکنند.
شاید سؤال مهمتری وجود داشته باشد:
پردازنده از کجا میداند کدام دادهها را باید در Cache نگه دارد؟
یکی از دلایل موفقیت Cache، ویژگیای در نحوه اجرای برنامههاست که Locality of Reference نام دارد.
برنامهها معمولاً به شکل کاملاً تصادفی به حافظه دسترسی پیدا نمیکنند. در بسیاری از موارد، الگوهایی در دسترسی به دادهها وجود دارد.
دو نوع مهم Locality عبارتاند از:
اگر برنامهای در یک بازه زمانی به یک داده دسترسی پیدا کند، احتمال دارد در آینده نزدیک دوباره به همان داده نیاز داشته باشد.
مثلاً در یک حلقه، ممکن است یک متغیر بارها استفاده شود.
در چنین شرایطی نگهداری آن داده در Cache میتواند دسترسیهای بعدی را سریعتر کند.
اگر برنامه به یک آدرس حافظه دسترسی پیدا کند، احتمال دارد به آدرسهای نزدیک به آن نیز نیاز داشته باشد.
برای مثال، هنگام پیمایش یک آرایه، معمولاً عناصر پشت سر هم خوانده میشوند.
به همین دلیل، پردازندهها معمولاً دادهها را در قالب بلوکهایی به نام Cache Line جابهجا میکنند، نه صرفاً یک بایت منفرد.
در بسیاری از معماریهای رایج، اندازه Cache Line برابر ۶۴ بایت است؛ البته این مقدار یک قانون همگانی برای تمام پردازندهها نیست.
Cache با بهرهگیری از Temporal و Spatial Locality میتواند احتمال Cache Hit را افزایش دهد.
فرض کنید یک آرایه دوبعدی بزرگ داریم.
در بسیاری از زبانهای برنامهنویسی، آرایههای دوبعدی به شکلی در حافظه قرار میگیرند که عناصر هر سطر پشت سر هم ذخیره میشوند.
اگر برنامه عناصر آرایه را به ترتیب سطری بخواند، معمولاً از Spatial Locality بهخوبی استفاده میکند.
اما اگر برنامه بهجای آن، عناصر را بهصورت ستونی و با پرشهای بزرگ در حافظه بخواند، ممکن است Cache Missهای بیشتری ایجاد شود.
در نتیجه، دو برنامه که دقیقاً یک مجموعه داده را پردازش میکنند و حتی محاسبات ریاضی یکسانی انجام میدهند، ممکن است عملکرد متفاوتی داشته باشند.
این موضوع نشان میدهد که عملکرد نرمافزار فقط به تعداد عملیات محاسباتی وابسته نیست؛ نحوه دسترسی به حافظه نیز اهمیت بسیار زیادی دارد.
Cache تنها راهکار مقابله با Memory Wall نیست.
معماری پردازندههای مدرن از چند تکنیک دیگر نیز استفاده میکند.
پردازنده میتواند الگوهای دسترسی به حافظه را بررسی کند و دادههایی را که احتمالاً در آینده نزدیک موردنیاز هستند، پیش از درخواست مستقیم برنامه به Cache منتقل کند.
برای مثال، اگر پردازنده متوجه شود برنامه در حال خواندن عناصر متوالی یک آرایه است، میتواند دادههای بعدی را زودتر دریافت کند.
به این روش Hardware Prefetching گفته میشود.
پردازندههای مدرن الزاماً دستورها را به همان ترتیب اولیه اجرا نمیکنند.
اگر یک دستور به دادهای وابسته باشد که هنوز از حافظه دریافت نشده است، ممکن است پردازنده دستورهای مستقل دیگری را اجرا کند.
این روش کمک میکند بخشی از زمان انتظار حافظه پنهان شود.
پردازنده میتواند چندین درخواست دسترسی به حافظه را بهصورت همزمان یا همپوشان مدیریت کند.
به این قابلیت Memory-Level Parallelism گفته میشود.
با افزایش تعداد درخواستهای مستقل، سیستم میتواند از پهنای باند حافظه بهتر استفاده کند و بخشی از تأخیرها را پنهان کند.
البته میزان موفقیت این روش به معماری پردازنده، الگوی دسترسی برنامه و وابستگی میان دادهها بستگی دارد.
مدلهای هوش مصنوعی مدرن، بهویژه مدلهای بزرگ، حجم بسیار زیادی از دادهها و پارامترها را پردازش میکنند.
در بسیاری از این کاربردها، انتقال داده میان حافظه و واحدهای محاسباتی به یک محدودیت جدی تبدیل میشود.
برای مثال، GPUها به تعداد زیادی واحد محاسباتی مجهز هستند. اما برای استفاده مؤثر از این واحدها باید دادهها با سرعت کافی در اختیارشان قرار بگیرند.
اگر واحدهای محاسباتی سریع باشند، اما حافظه نتواند دادههای موردنیاز را با پهنای باند کافی تأمین کند، بخشی از توان محاسباتی GPU بلااستفاده میماند.
به همین دلیل، فناوریهایی مانند High Bandwidth Memory (HBM) اهمیت زیادی پیدا کردهاند.
HBM از ساختار حافظههای DRAM انباشتهشده و ارتباطات بسیار عریض استفاده میکند تا پهنای باند بالایی فراهم کند.
این فناوری بهخصوص در شتابدهندههای هوش مصنوعی و پردازندههای گرافیکی پیشرفته اهمیت دارد.
البته HBM تمام مشکلات حافظه را حل نمیکند. افزایش Bandwidth لزوماً به معنای حذف Latency یا تمام محدودیتهای انتقال داده نیست.
یکی از مسیرهای مهم تحقیق و توسعه، کاهش فاصله میان محل ذخیره داده و محل انجام محاسبات است.
در معماری سنتی، دادهها از حافظه به سمت واحدهای محاسباتی منتقل میشوند.
اما در رویکردهایی مانند Processing-in-Memory (PIM) تلاش میشود بخشی از عملیات محاسباتی در نزدیکی حافظه یا داخل ساختار حافظه انجام شود.
منطق این ایده ساده است:
بهجای انتقال حجم بزرگی از دادهها به پردازنده، چرا بعضی عملیات را همانجایی انجام ندهیم که دادهها قرار دارند؟
این رویکرد میتواند برای برخی کاربردهای دادهمحور، پهنای باند موردنیاز برای انتقال داده و مصرف انرژی را کاهش دهد.
البته PIM هنوز با چالشهای مهمی مانند پیچیدگی طراحی، برنامهنویسی، سازگاری با معماریهای موجود و محدودیت نوع عملیات قابل اجرا روبهرو است.
بنابراین، نباید آن را جایگزینی کامل و عمومی برای معماریهای سنتی حافظه در نظر گرفت.
احتمالاً نه به شکل کامل.
با هر نسل جدید پردازنده، توان محاسباتی افزایش پیدا میکند و برنامهها نیز به دادههای بیشتری نیاز پیدا میکنند.
در مقابل، حافظه با محدودیتهای فیزیکی، اقتصادی، انرژی و ارتباطی مواجه است.
به همین دلیل، Memory Wall بیشتر از آنکه یک مشکل با یک راهحل مشخص باشد، یک چالش دائمی در معماری کامپیوتر است.
راهکارهای مختلفی برای کاهش اثر آن وجود دارند:
طراحی Cacheهای سریعتر و هوشمندتر
بهبود Locality در الگوریتمها
استفاده از Prefetching
افزایش Memory-Level Parallelism
توسعه فناوریهایی مانند HBM
نزدیکتر کردن حافظه و پردازنده
بررسی معماریهایی مانند Processing-in-Memory
هیچکدام از این راهکارها بهتنهایی پاسخ تمام نیازهای سیستمهای مدرن نیستند. ترکیب آنهاست که میتواند عملکرد کلی سیستم را بهبود دهد.
در نگاه اول، ممکن است تصور کنیم برای ساخت یک کامپیوتر سریعتر فقط باید پردازندهای با فرکانس بالاتر یا تعداد هستههای بیشتر داشته باشیم.
اما واقعیت پیچیدهتر است.
پردازنده برای اجرای محاسبات به داده نیاز دارد و اگر حافظه نتواند این دادهها را در زمان مناسب تأمین کند، افزایش توان محاسباتی لزوماً به افزایش متناسب عملکرد منجر نمیشود.
Memory Wall به ما یادآوری میکند که معماری کامپیوتر فقط درباره سرعت محاسبه نیست؛ درباره سرعت جابهجایی دادهها نیز هست.
شاید یکی از مهمترین پرسشهای آینده صنعت سختافزار دیگر این نباشد که:
«چگونه پردازندهای سریعتر بسازیم؟»
بلکه این باشد:
«چگونه دادهها را سریعتر، هوشمندانهتر و با انرژی کمتر به محل انجام محاسبات برسانیم؟»
و دقیقاً همین پرسش است که مسیر توسعه Cacheهای پیشرفته، حافظههای HBM، معماریهای سهبعدی و Processing-in-Memory را شکل میدهد.

