
دنیای توسعه نرمافزار در سالهای اخیر فقط به نوشتن کد محدود نشده و مفاهیم جدیدی وارد معماری و طراحی سیستمها شدهاند که شناخت آنها برای هر مهندس نرمافزار، توسعه دهنده یا حتی علاقهمند به تکنولوژی اهمیت زیادی دارد. از معماریهای Event-Driven و Serverless گرفته تا مفاهیمی مثل MLOps، CQRS، Service Mesh و Kubernetes، هرکدام بخشی از چالشهای سیستمهای مدرن را حل میکنند و باعث میشوند نرمافزارها مقیاسپذیرتر، منعطفتر و قابل نگهداریتر شوند. در این مطلب سعی میکنم 20 تا از مهمترین مفاهیم و ترندهای معماری نرمافزار مدرن را راجبش صحبت کنم تا دید بهتری نسبت به دنیای سیستمهای امروزی پیدا کنیم✌️
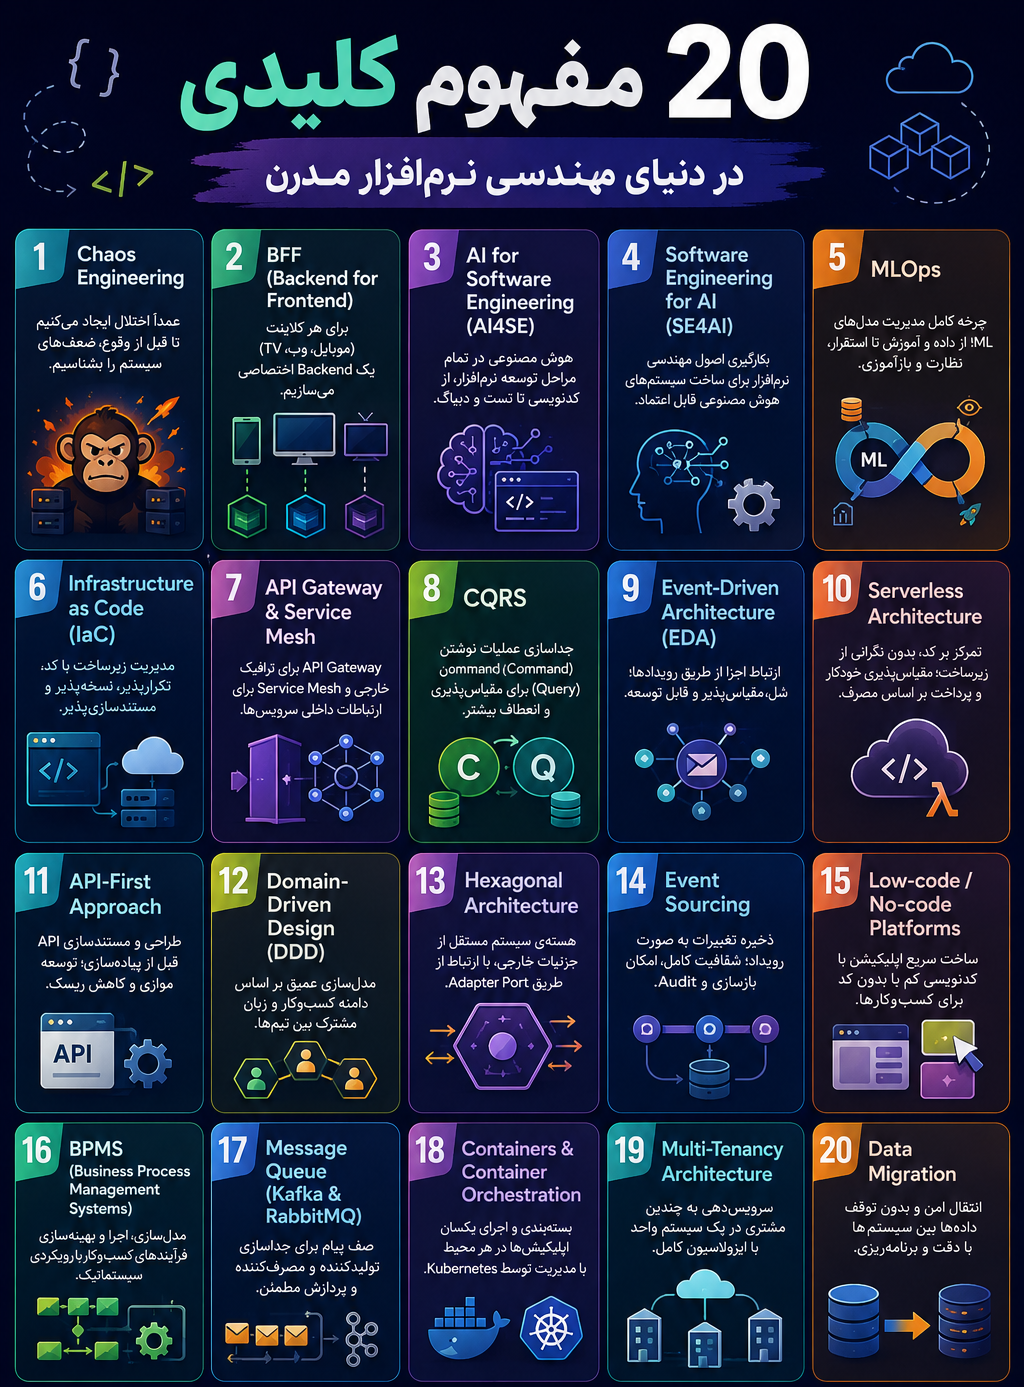
وقتی اولین بار با عبارت مهندسی آشوب روبرو شدم، کمی عجیب به نظر رسید🤔
چرا باید عمدا به سیستمهایمان آسیب بزنیم؟ اما وقتی عمیقتر رفتم، متوجه شدم این رویکرد یکی از هوشمندانهترین استراتژیهایی است که در دنیای معماری نرمافزار مدرن وجود دارد.
Chaos Engineering یعنی عمداً و بهصورت کنترلشده، خرابی و اختلال را در یک سیستم وارد کردن تا ببینیم آیا آن سیستم میتواند در برابر شرایط واقعی و غیرمنتظره دوام بیاورد یا نه. ایده اصلی میگه بهتر است ما یک خرابی را در محیطی کنترلشده شبیهسازی کنیم، تا اینکه خرابی ناخواسته در محیط واقعی و زمانی که کاربران از سرویس استفاده میکنند اتفاق بیفتد.
Netflix یکی از پیشگامان این حوزه است. آنها ابزاری به نام Chaos Monkey ساختند که بهصورت تصادفی سرورهای تولیدی را خاموش میکرد تا ببینند سیستم چطور واکنش نشان میدهد. در ابتدا این ایده دیوانهوار به نظر میرسید، اما نتیجه آن شد که Netflix یکی از مقاومترین سیستمهای توزیعشده دنیا را ساخت.
مراحل اجرای یک آزمایش Chaos Engineering معمولا به این شکل است که ابتدا وضعیت عادی سیستم را تعریف میکنیم (Steady State)، سپس یک فرضیه میسازیم مثل اگر یک سرور از دسترس خارج شود، سیستم همچنان پاسخگو خواهد بود، بعد آزمایش را در محیطی کنترل شده اجرا میکنیم، نتایج را مشاهده میکنیم، و در نهایت یاد میگیریم و سیستم را بهبود میدهیم.
چیزی که این رویکرد را متمایز میکند این است که از امیدواریم مشکلی پیش نیاید خارج میشویم و وارد بیایید مشکلات را قبل از رخ دادن پیدا کنیم، میشویم. این تغییر نگرش در سیستمهای بزرگ و توزیعشده بسیار ارزشمند است.
[1] “اصول مهندسی آشوب” (Principles of Chaos Engineering), وبسایت رسمی (Persian translation) https://principlesofchaos.org/fa.
[2] A. Basiri, Chaos Engineering – Gremlin, بلاگ شرکت Gremlin (2022) https://www.gremlin.com/chaos-engineering/
تصور کنید یک API دارید که باید هم به اپلیکیشن موبایل، هم به وباپلیکیشن، و هم به یک Smart TV پاسخ دهد. مشکل اینجاست که هر یک از این کلاینتها نیازهای کاملاً متفاوتی دارند؛ موبایل به دادههای سبکتر نیاز دارد، وب به دادههای غنیتر، و Smart TV ممکن است ساختار کاملاً دیگری بخواهد. Pattern مشهور به BFF یا Backend for Frontend دقیقاً برای حل این چالش به وجود آمده است.
ایده اصلی BFF ساده است، یعنی به جای اینکه یک Backend عمومی برای همه کلاینتها داشته باشیم، برای هر نوع کلاینت یک Backend جداگانه و اختصاصی میسازیم. یعنی یک BFF برای موبایل، یک BFF برای وب، و یک BFF برای Smart TV. هر BFF دقیقا همان دادههایی را که کلاینت متناظرش نیاز دارد فراهم میکند. نه بیشتر، نه کمتر.
این Pattern اولین بار توسط Sam Newman در کتابش درباره Microservices معرفی شد. مزیت اصلیاش این است که تیم Frontend میتواند BFF مختص خودش را کنترل کند و نیازی نیست منتظر تیم Backend بماند تا تغییرات مورد نیازش را پیادهسازی کند. همچنین هر BFF میتواند دادهها را به شکلی که کلاینتش نیاز دارد تجمیع، فیلتر و قالببندی کند.
یک مثال ملموس بخوام بگم این هست که فرض کنید صفحه پروفایل کاربر در موبایل فقط به نام، عکس و آخرین فعالیت نیاز دارد، اما همین صفحه در وب شامل تاریخچه خریدها، تنظیمات حساب، پیامها و موارد دیگری هم هست. با BFF، هر کلاینت دقیقا همان چیزی را میگیرد که نیاز دارد، بدون اینکه دادههای اضافهای منتقل شود یا کلاینت مجبور به چندین درخواست جداگانه شود.
البته BFF هزینههایی هم دارد چون نگهداری چندین Backend میتواند پیچیدگی را افزایش دهد. به همین دلیل معمولا BFF در کنار یک API Gateway استفاده میشود تا مسیریابی و اعتبارسنجی مشترک در یک جا مدیریت شود.
[1] S. Newman, “Backends For Frontends,” Sam Newman’s blog (2019) https://samnewman.io/patterns/architectural/backends-for-frontends
[2] Microsoft, “Backends for Frontends pattern,” Azure Architecture Center (2017) https://docs.microsoft.com/azure/architecture/patterns/bff
[3] M. Johnson, “Building Mobile Apps with an API and BFF,” AWS Compute Blog (2019) https://aws.amazon.com/blogs/mobile/backends-for-frontends/
یکی از جذابترین تحولاتی که در سالهای اخیر در دنیای مهندسی نرمافزار رخ داده، ورود هوش مصنوعی به فرآیندهای توسعه نرمافزار است. AI4SE یا هوش مصنوعی برای مهندسی نرمافزار یعنی استفاده از تکنیکها و ابزارهای AI در مراحل مختلف چرخهی حیات نرمافزار؛ از نوشتن کد تا تست، از بررسی کد تا دیباگ کردن.
وقتی درباره AI4SE فکر میکنم، اولین چیزی که به ذهنم میرسد ابزارهایی مثل GitHub Copilot است که بهصورت Real-time کد پیشنهاد میدهد. اما این فقط یک گوشه از این حوزه است. AI4SE طیف گستردهای از کاربردها را شامل میشود.
در حوزه تولید کد، مدلهای زبانی بزرگ مثل GPT-4 و Claude میتوانند تکههای کد بنویسند، Boilerplate تولید کنند، و حتی کدهای موجود را Refactor کنند. در حوزه تست، AI میتواند بهصورت خودکار Test Caseهای جدید تولید کند یا باگهای احتمالی را شناسایی کند. در Code Review هم مدلها میتوانند مشکلات امنیتی، کارایی پایین، یا نقض اصول طراحی را پیدا کنند.
یکی از کاربردهای خیلی جالب، تبدیل زبانهای طبیعی به کد است (Natural Language to Code). یعنی توسعهدهنده میگوید یک تابع بنویس که لیستی از اعداد را میگیرد و میانگین آنها را برمیگرداند و AI کد آن را مینویسد. این به ویژه برای کاهش زمان توسعه و کمک به توسعهدهندگان تازهکار بسیار مفید است.
البته AI4SE چالشهایی هم دارد. کدهای تولیدشده توسط AI همیشه صحیح نیستند و ممکن است باگهای ظریفی داشته باشند. همچنین درباره حقوق مالکیت معنوی کدهای تولیدشده هنوز بحثهای حقوقی جدی وجود دارد. علاوه بر این، وابستگی بیش از حد به AI ممکن است مهارتهای بنیادی توسعهدهندگان را کاهش دهد.
[1] Chen, M., et al. (2021). Evaluating Large Language Models Trained on Code. arXiv:2107.03374.
[2] Barr, E. T., Harman, M., McMinn, P., Shahbaz, M., & Yoo, S. (2015). The Oracle Problem in Software Testing: A Survey. IEEE Transactions on Software Engineering, 41(5), 507–525
اگر AI4SE درباره کمک AI به مهندسان نرمافزار بود، SE4AI دقیقا برعکس است. چگونه اصول و روشهای مهندسی نرمافزار را برای ساختن سیستمهای هوش مصنوعی به کار ببریم؟ این سوال به نظر ساده میرسد، اما چالشهای خاص خودش را دارد.
ساخت یک سیستم مبتنی بر AI با توسعه نرمافزار سنتی تفاوتهای اساسی دارد. در نرمافزار سنتی، رفتار سیستم کاملا با کد تعریف میشود. اما در سیستمهای AI، رفتار سیستم از داده یاد میگیرد. این یعنی وقتی مشکلی پیش میآید، ممکن است نه در کد، بلکه در دادههای آموزشی یا در مدل باشد.
SE4AI تلاش میکند پاسخ دهد که چطور سیستمهای AI را به شکل قابل نگهداری، قابل تست، و قابل مقیاسگذاری طراحی کنیم. برای مثال، یکی از بزرگترین چالشها تست سیستمهای ML است. در نرمافزار سنتی، خروجی برای یک ورودی مشخص کاملا قابل پیشبینی است. اما یک مدل ML ممکن است برای ورودیهای مشابه خروجیهای متفاوتی بدهد.
یکی از مفاهیم کلیدی در SE4AI، مدیریت بدهی فنی (Technical Debt) در سیستمهای ML است. مقالهای از Google با عنوان 'Hidden Technical Debt in Machine Learning Systems' نشان داد که کد واقعی ML معمولا بخش کوچکی از یک سیستم ML را تشکیل میدهد و بخش عمده پیچیدگی در مدیریت داده، پایپلاینها، و Serving قرار دارد.
SE4AI همچنین شامل مهندسی داده، نظارت بر مدلها (Model Monitoring)، مدیریت Versioning مدلها، و طراحی سیستمهایی است که وقتی مدل تغییر میکند بهخوبی بهروزرسانی شوند. این حوزه روز به روز اهمیت بیشتری پیدا میکند چون سیستمهای AI بهسرعت در حال ورود به محصولات واقعی هستند.
[1] Sculley, D., et al. (2015). Hidden Technical Debt in Machine Learning Systems. Advances in Neural Information Processing Systems (NIPS), 28.
[2] Amershi, S., et al. (2019). Software Engineering for Machine Learning: A Case Study. ICSE-SEIP 2019.
[3] Serban, A. C., van den Berg, K., Visser, J., & Zaidman, A. (2020). Adoption and Effects of Software Engineering Best Practices in Machine Learning. ESEM 2020.
هر کسی که تجربه ساخت یک مدل Machine Learning داشته باشد میداند که ساخت مدل فقط نیمی از کار است و نیم دیگر استقرار آن در محیط تولید و نگهداریاش در طول زمان است. MLOps یا Machine Learning Operations، مجموعهای از اصول، ابزارها و روشهایی است که این فرآیند را ساختارمند میکند.
MLOps ترکیبی از DevOps و مهندسی داده و مهندسی ML است. همانطور که DevOps فاصله بین توسعه و عملیات را کاهش داد، MLOps فاصله بین تحقیقات ML (که در دفترچههای Jupyter و محیطهای آزمایشگاهی انجام میشود) و محصولات واقعی را کاهش میدهد.
چرخه حیات یک مدل ML در MLOps معمولا شامل این مراحل است: جمعآوری و پردازش داده، آموزش مدل، ارزیابی و اعتبارسنجی مدل، استقرار (Deployment)، نظارت بر عملکرد (Monitoring)، و در صورت نیاز، بازآموزی (Retraining). کل این چرخه باید تا حد ممکن خودکار و قابل تکرار باشد.
یکی از مهمترین مفاهیم در Model Drift ،MLOps است. منظور این است که عملکرد یک مدل در طول زمان ممکن است کاهش یابد چون دنیای واقعی تغییر میکند اما مدل با دادههای قدیمی آموزش دیده. به همین دلیل نظارت مستمر بر دقت مدل در محیط تولید ضروری است.
ابزارهای محبوب در MLOps شامل MLflow برای ردیابی آزمایشها، Kubeflow برای اجرای پایپلاینهای ML روی Kubernetes، DVC برای نسخهبندی داده، و Seldon یا BentoML برای Serving مدل هستند. پلتفرمهای ابری مثل AWS SageMaker، Google Vertex AI و Azure ML هم مجموعه کاملی از ابزارهای MLOps ارائه میدهند.
[1] Kreuzberger, D., Kühl, N., & Hirschl, S. (2022). Machine Learning Operations (MLOps): Overview, Definition, and Architecture. arXiv:2205.02302.
[2] Sculley, D., et al. (2015). Hidden Technical Debt in Machine Learning Systems. NIPS 2015.
[3] Google Cloud. (2022). MLOps: Continuous delivery and automation pipelines in machine learning. https://cloud.google.com/architecture/mlops-continuous-delivery-and-automation-pipelines-in-machine-learning
در روزگار نه چندان دوری، مدیران سیستم باید بهصورت دستی وارد سرورها میشدند، دستوراتی تایپ میکردند و زیرساخت را پیکربندی میکردند. این روش نه تکرارپذیر بود، نه قابلیت مستندسازی را داشت، و نه مقیاسپذیر بود. Infrastructure as Code یا IaC آمد تا این روش را متحول کند.
IaC به معنای مدیریت و تأمین زیرساخت (سرورها، شبکه، پایگاهداده و غیره) از طریق فایلهای کد قابل خواندن توسط ماشین به جای فرآیندهای دستی است. به عبارت سادهتر، وضعیت مطلوب زیرساخت را در یک فایل کد توصیف میکنیم و یک ابزار مسئول میشود که آن زیرساخت را ایجاد کند.
مزایای این رویکرد زیاد است. اول، تکرارپذیری است، یعنی همان کد را میتوان برای ایجاد محیط توسعه، تست و تولید استفاده کرد و مطمئن بود که همه یکسان هستند. دوم، نسخهبندی آن است، یعنی کد زیرساخت مثل هر کد دیگری در Git نگهداری میشود و میتوان تاریخچه تغییرات را دید. سوم، مستندسازی آن است، یعنی خود کد، بهترین مستندات ممکن برای زیرساخت است.
دو ابزار اصلی در این حوزه عبارتند از Terraform که از HashiCorp است و رویکرد Declarative دارد (یعنی میگوییم چه میخواهیم، نه چطور ایجاد کنیم)، و Ansible که رویکرد Imperative دارد و بیشتر برای پیکربندی سرورهای موجود استفاده میشود. پلتفرمهای ابری هم ابزارهای اختصاصی خود مثل AWS CloudFormation و Azure ARM Templates دارند.
یکی از اصول مهم در IaC، «Idempotency» است. یعنی اگر همان کد را چندین بار اجرا کنیم، نتیجه همیشه یکسان است و تغییر اضافهای ایجاد نمیشود. این اصل باعث میشود بتوانیم با اطمینان، کد زیرساخت را اجرا و مجدداً اجرا کنیم.
[1] Morris, K. (2020). Infrastructure as Code: Dynamic Systems for the Cloud Age (2nd ed.). O'Reilly Media.
[2] HashiCorp. (2023). Terraform Documentation. https://developer.hashicorp.com/terraform/docs
در معماری Microservices، دهها یا حتی صدها سرویس کوچک با هم در ارتباط هستند. مدیریت این ارتباطات، احراز هویت، Load Balancing، Logging و غیره به سرعت پیچیده میشود. دو Pattern مکمل برای حل این چالشها وجود دارند که API Gateway و Service Mesh هستند.
API Gateway نقطه ورودی واحد برای تمام درخواستهای خارجی به سیستم است. به جای اینکه کلاینت مستقیما با سرویسهای داخلی صحبت کند، با API Gateway صحبت میکند و Gateway درخواست را به سرویس مناسب هدایت میکند. علاوه بر مسیریابی، API Gateway معمولا وظایفی مثل احراز هویت (Authentication)، Rate Limiting، Caching، لاگگیری، و SSL Termination را هم انجام میدهد. ابزارهای معروف این حوزه شاملKong، AWS API Gateway، و Nginx هستند.
Service Mesh اما با مشکل متفاوتی سروکار دارد؛ ارتباطات سرویس به سرویس (Service-to-Service) در داخل سیستم. وقتی سرویس A باید با سرویس B صحبت کند، چطور مطمئن میشویم این ارتباط امن، قابل مشاهده و مقاوم در برابر خرابی است؟ Service Mesh این منطق را از کد سرویسها خارج میکند و در یک لایه زیرساختی جداگانه قرار میدهد.
در Service Mesh مدرن مثل Istio یا Linkerd، یک Sidecar Proxy (معمولا Envoy) کنار هر سرویس مستقر میشود. این پروکسی تمام ترافیک ورودی و خروجی سرویس را میگیرد و وظایفی مثل mTLS (رمزنگاری ارتباطات سرویس به سرویس)، Circuit Breaking، Retry، Distributed Tracing و Load Balancing را مدیریت میکند، بدون اینکه کد سرویس چیزی بداند.
تفاوت کلیدی این دو این هست که API Gateway بیشتر برای کنترل ترافیک شمال-جنوب (خارج به داخل) استفاده میشود، در حالی که Service Mesh برای ترافیک شرق-غرب (سرویس به سرویس داخلی). در بسیاری از معماریهای مدرن، این دو در کنار هم به کار میروند.
[1] Richardson, C. (2018). Microservices Patterns. Manning Publications.
[2] Istio Project. (2023). Istio Documentation. https://istio.io/latest/docs
یکی از اصول کلاسیک در طراحی نرمافزار این است که یک متد یا عملیات باید یا یک عمل انجام دهد یا یک مقدار برگرداند، نه هر دو. CQRS یا جداسازی مسئولیت دستور و پرسش این ایده را در سطح معماری سیستم پیادهسازی میکند.
در CQRS، سیستم به دو بخش جداگانه تقسیم میشود. Command Side مسئول تغییر وضعیت سیستم است؛ یعنی چیزهایی مثل محصول جدید اضافه کن، سفارش ثبت کن، موجودی را بهروزرسانی کن. Query Side مسئول خواندن و گزارشگیری است. یعنی چیزهایی مثل لیست محصولات را نشان بده، وضعیت سفارش را برگردان. این دو بخش مدلهای داده، منطق و حتی پایگاه دادههای متفاوتی میتوانند داشته باشند.
چرا این جداسازی مهم است؟ در بسیاری از سیستمها، نیازهای خواندن و نوشتن کاملا متفاوت هستند. ممکن است نوشتن نیاز به Consistency قوی داشته باشد و از یک پایگاه داده رابطهای استفاده کند، در حالی که خواندن نیاز به سرعت بالا دارد و بهتر است از یک پایگاه داده بهینهشده برای جستجو مثل Elasticsearch استفاده شود.
CQRS به خودی خود یک Pattern نسبتا ساده است، اما معمولا با Event Sourcing ترکیب میشود. در این ترکیب، هر Command یک Event تولید میکند، آن Event در یک Event Store ذخیره میشود، و Query Side با خواندن این Eventها وضعیت فعلی را میسازد.
یک نکته مهم: CQRS همیشه مناسب نیست. برای سیستمهای ساده، این Pattern پیچیدگی غیرضروری اضافه میکند. این Pattern بیشتر در سیستمهایی مفید است که نیاز به مقیاسپذیری جداگانه برای عملیات خواندن و نوشتن دارند، یا که منطق کسبوکار پیچیدهای دارند.
[1] Young, G. (2010). CQRS Documents. https://cqrs.files.wordpress.com/2010/11/cqrs_documents.pdf
[2] Fowler, M. (2011). CQRS. https://martinfowler.com/bliki/CQRS.html
[3] Vernon, V. (2013). Implementing Domain-Driven Design. Addison-Wesley Professional.
در معماریهای سنتی، وقتی سرویس A به نتیجه عمل سرویس B نیاز دارد، مستقیما آن را فراخوانی میکند و منتظر پاسخ میماند. این رویکرد Synchronous ساده و قابل فهم است، اما در مقیاسهای بزرگ به سرعت تبدیل به گلوگاه میشود. معماری رویدادمحور یا EDA این مشکل را با تغییر بنیادی در نحوه ارتباط اجزای سیستم حل میکند.
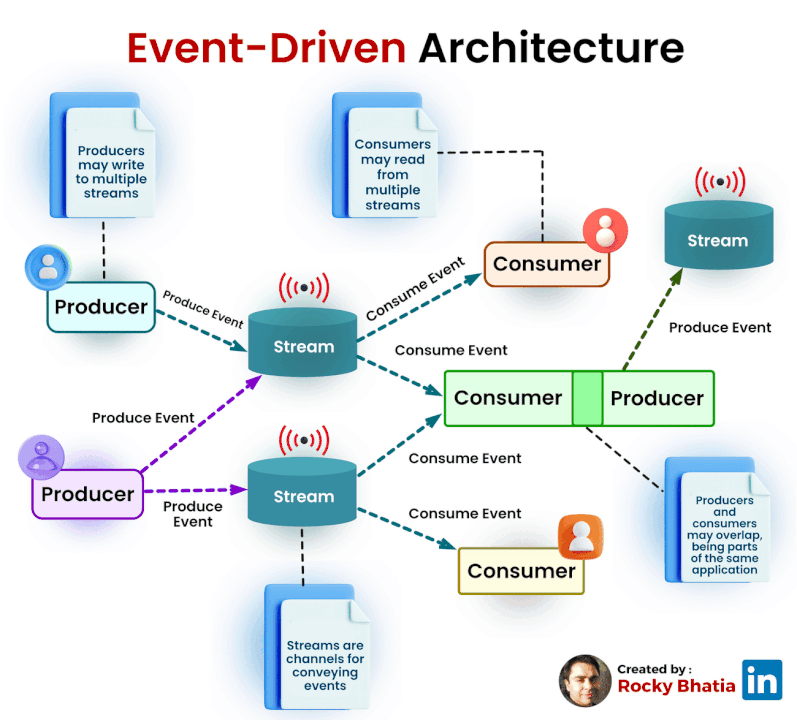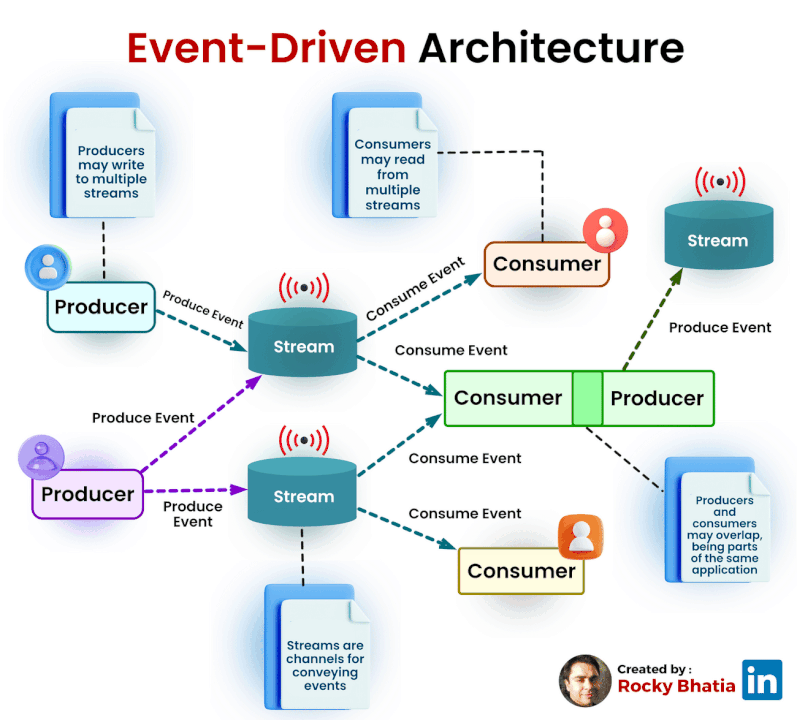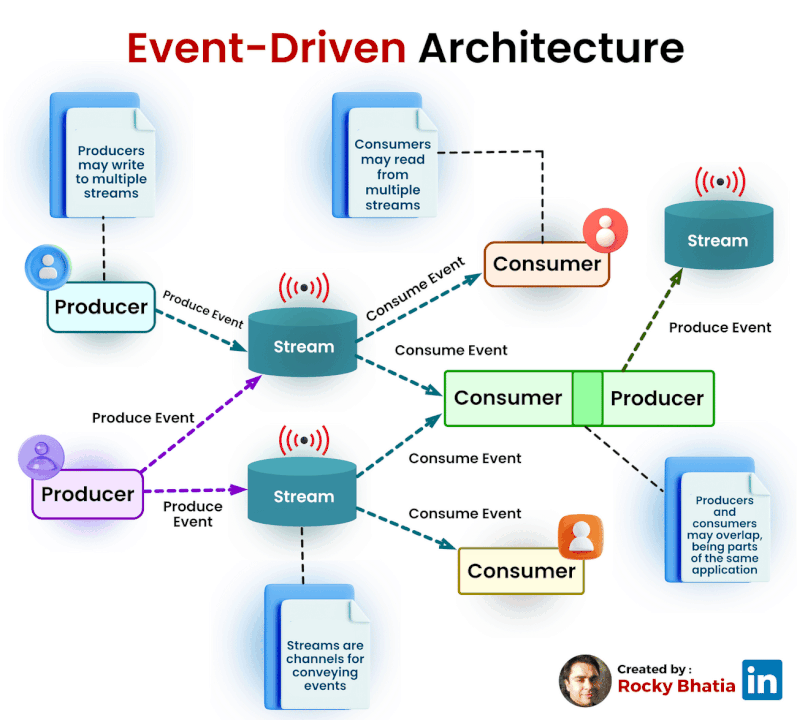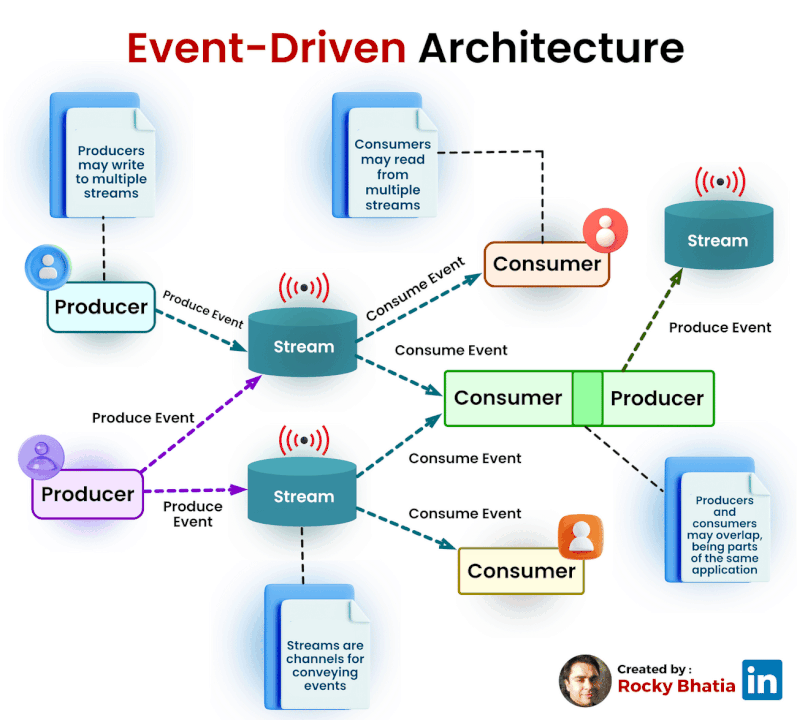
در EDA، اجزای سیستم از طریق رویدادها (Events) با یکدیگر ارتباط برقرار میکنند. یک سرویس رویدادی منتشر میکند (مثلا کاربر جدیدی ثبتنام کرد)، سپس کار خود را ادامه میدهد بدون اینکه منتظر واکنش باشد. سرویسهای دیگری که به این رویداد اهمیت میدهند آن را میشنوند و واکنش نشان میدهند. مثلا سرویس ایمیل یک ایمیل خوشآمدگویی میفرستد، سرویس آمار کاربر جدید را ثبت میکند.
سه مفهوم اصلی در EDA وجود دارد؛ Event Producer که رویداد را تولید میکند، Event Broker که رویدادها را دریافت و توزیع میکند (مثل Apache Kafka یا RabbitMQ)، و Event Consumer که به رویدادهای مورد علاقهاش گوش میدهد و پردازش میکند.
مزایای اصلی EDA عبارتند از Loose Coupling یا اتصال شل بین سرویسها (سرویسها نمیدانند چه کسی به رویدادهایشان گوش میدهد)، Scalability بالا (هر Consumer میتواند بهصورت مستقل مقیاسپذیری شود)، و امکان اضافه کردن Consumer جدید بدون تغییر در Producer.
اما EDA چالشهایی هم دارد. Debugging در سیستمهای EDA دشوارتر است چون جریان اطلاعات خطی نیست. همچنین مدیریت Eventual Consistency، وضعیتی که دادهها در سیستمهای مختلف در لحظههای مختلف بهروزرسانی میشوند، پیچیدگی منطق کسبوکار را افزایش میدهد.
[1] Stopford, B. (2018). Designing Event-Driven Systems. O'Reilly Media.
[2] Richardson, C. (2018). Microservices Patterns. Manning Publications.
[3] Fowler, M. (2017). What do you mean by 'Event-Driven'?https://martinfowler.com/articles/201701-event-driven.html
نام Serverless کمی گمراهکننده است؛ چون سرور همچنان وجود دارد، اما ما به عنوان توسعه دهنده دیگر نگران مدیریت، پیکربندی، و مقیاسدهی آن نیستیم. Serverless یک مدل اجرایی است که در آن فقط کد خود را مینویسیم و ارائهدهنده ابری مسئول همه چیز دیگر، از تامین منابع گرفته تا مقیاسدهی خودکار است.
مهمترین شکل Serverless، Function as a Service یا FaaS است. در این مدل، کد به صورت توابع مستقل نوشته میشود که در پاسخ به رویدادها مثل یک درخواست HTTP، آپلود یک فایل، یا دریافت یک پیام، اجرا میشوند. AWS Lambda ،Google Cloud Functions و Azure Functions معروفترین نمونههای FaaS هستند.
مدل پرداخت در Serverless هم متفاوت است. به جای اینکه برای سرور اجاره داده شده در طول شبانه روز هزینه پرداخت کنیم، فقط برای زمانی که کدمان واقعا اجرا میشود هزینه میدهیم. این برای workload هایی که ترافیک نامنظم و ناپیوسته دارند بسیار مقرونبهصرفه است.
مزایای اصلی Serverless، عدم نیاز به مدیریت سرور (که باری از دوش توسعهدهنده برمیدارد)، مقیاسپذیری خودکار تا بینهایت، و مدل هزینه Pay-per-use. اما معایب هم وجود دارند؛ Cold Start یعنی اولین اجرای یک تابع بعد از مدتی غیرفعال بودن ممکن است کند باشد. همچنین محدودیتهایی در زمان اجرا (معمولا حداکثر چند دقیقه) و حافظه وجود دارد. و Debugging و Testing محلی دشوارتر است.
Serverless برای همه کارها مناسب نیست. برنامههایی که نیاز به پردازش طولانیمدت، حالت دائمی، یا Latency بسیار پایین دارند معمولا گزینههای بهتری دارند. اما برای API های رویداد محور، پردازش فایل، تبدیل داده، و automation taskها، Serverless انتخاب عالی است.
[1] Roberts, M. (2018). Serverless Architectures. https://martinfowler.com/articles/serverless.html
[2] Baldini, I., et al. (2017). Serverless Computing: Current Trends and Open Problems. Research Advances in Cloud Computing. Springer.
[3] Amazon Web Services. (2023). AWS Lambda Developer Guide. https://docs.aws.amazon.com/lambda/latest/dg/welcome.html
در دنیایی که اپلیکیشنهای موبایل، وب، IoT، و سرویسهای شخص ثالث همگی به سیستم ما متکی هستند، طراحی API دیگر یک کار ثانویه بعد از ساخت سیستم نیست و باید اولین و اصلیترین قدم باشد. رویکرد API-First دقیقا همین را میگوید.
در رویکرد API-First، قبل از اینکه حتی یک خط کد پیادهسازی بنویسیم، API را طراحی میکنیم و مستندسازی میکنیم. این طراحی به عنوان قرارداد (Contract) بین تیمهای Frontend، Backend، و تیمهای خارجی عمل میکند. همه میدانند چه Endpointهایی وجود خواهد داشت، چه دادهای ارسال و دریافت میشود، و چه خطاهایی ممکن است رخ دهد.
استاندارد OpenAPI که قبلا Swagger نامیده میشد، معمولا برای توصیف API استفاده میشود. با داشتن این مستند، میتوان به صورت خودکار Client SDK، Server Stub، مستندات تعاملی، و حتی Mock Serverها تولید کرد. Mock Server به تیم Frontend اجازه میدهد قبل از اینکه Backend واقعی آماده شود، توسعه خود را شروع کند.
مزایای این رویکرد توسعه موازی تیمهای Frontend و Backend، کشف مشکلات طراحی قبل از پیادهسازی (اصلاح یک طراحی بد در مرحله قبل از کدنویسی بسیار ارزانتر از اصلاح آن بعد از پیادهسازی است)، مستندات همیشه بهروز (چون از کد تولید میشوند)، و قابلیت Backward Compatibility بهتر.
ابزارهای معروف در این حوزه شامل Swagger/OpenAPI برای توصیف API ،Postman برای تست و Mock Stoplight برای طراحی بصری API، و Pact برای Contract Testing هستند. API-First رویکردی است که به خصوص در سازمانهایی که محصولاتشان Platform هستند یا API را به شرکای تجاری ارائه میدهند، بسیار مهم است.
[1] Higginbotham, J. (2021). Principles of Web API Design: Delivering Value with APIs and Microservices. Addison-Wesley Professional.
[2] OpenAPI Initiative. (2023). OpenAPI Specification. https://spec.openapis.org/oas/v3.1.0
[3] Jacobson, D., Brail, G., & Woods, D. (2011). APIs: A Strategy Guide. O'Reilly Media.
یکی از اصلیترین چالشها در توسعه نرمافزارهای پیچیده، شکاف بین دنیای کسبوکار و دنیای فنی است. توسعهدهندگان با زبان کد صحبت میکنند و کارشناسان دامنه با زبان کسبوکار. Domain-Driven Design یا DDD رویکردی است که این شکاف را کاهش میدهد.
DDD که توسط Eric Evans در کتاب معروفش در سال ۲۰۰۳ معرفی شد، بر این ایده استوار است که مدل نرمافزار باید بازتاب عمیق دامنه کسبوکار باشد، نه صرفا یک سازماندهی فنی. تمام کد، کلاسها، و عملیات باید با واژگان و مفاهیمی که متخصصین کسبوکار استفاده میکنند نامگذاری و سازماندهی شوند.
مفهوم محوری DDD، Ubiquitous Language یا زبان فراگیر است. این زبان مشترکی است که هم توسعهدهندگان و هم متخصصین کسبوکار از آن استفاده میکنند. یک واژهنامه مشترک که در مستندات، در کد و در مکالمات روزمره استفاده میشود. اگر در کسبوکار به چیزی سفارش میگویند، در کد هم باید Order باشد، نه Transaction یا Record.
DDD مفاهیم سازماندهی دیگری هم دارد. Bounded Context مرزی است که یک مدل کسبوکار در آن معنای مشخصی دارد. مثلا محصول در زمینه انبارداری معنای متفاوتی نسبت به محصول در زمینه فروش دارد. Aggregate گروهی از Entity و Value Objectهاست که به عنوان یک واحد منسجم با هم مدیریت میشوند. Aggregate Root تنها نقطه ورودی برای تغییر در این گروه است.
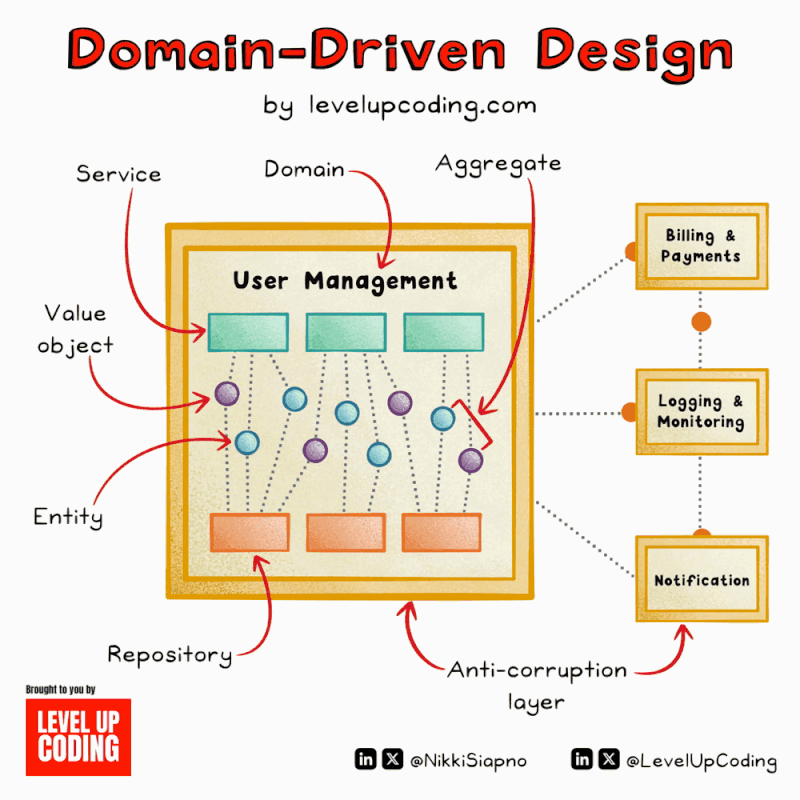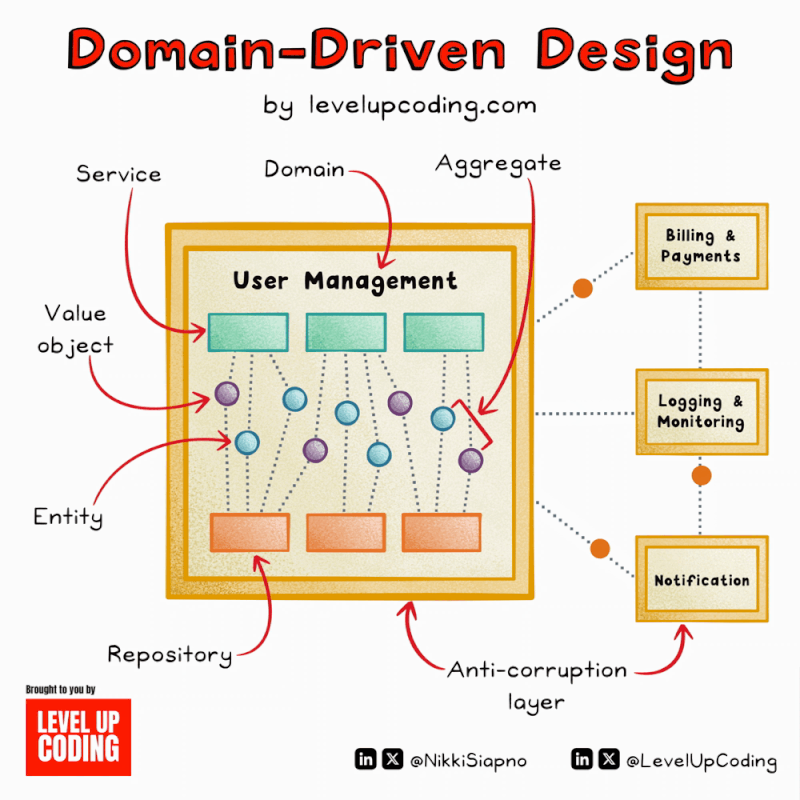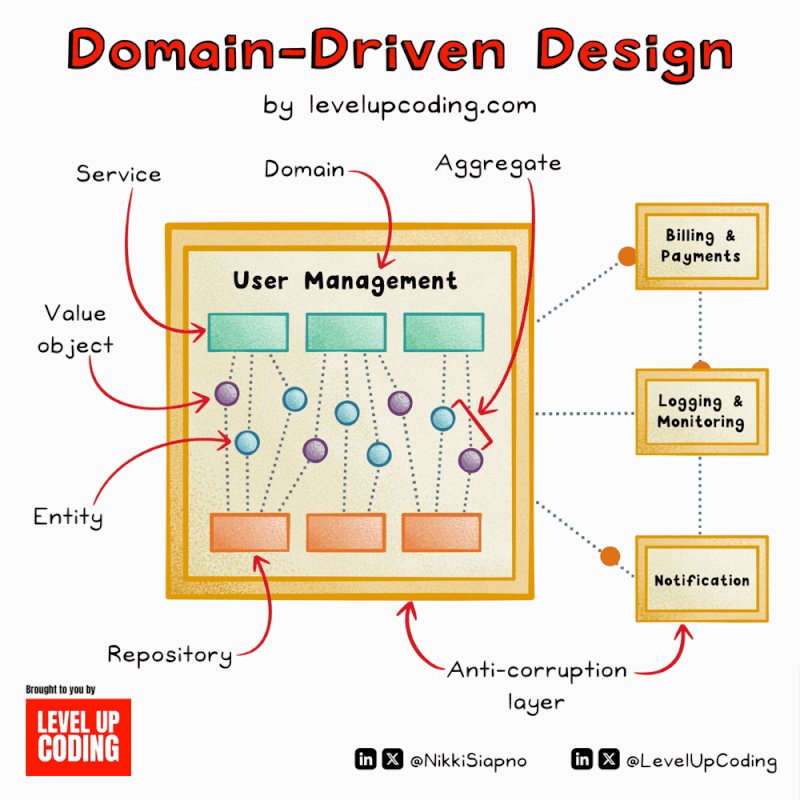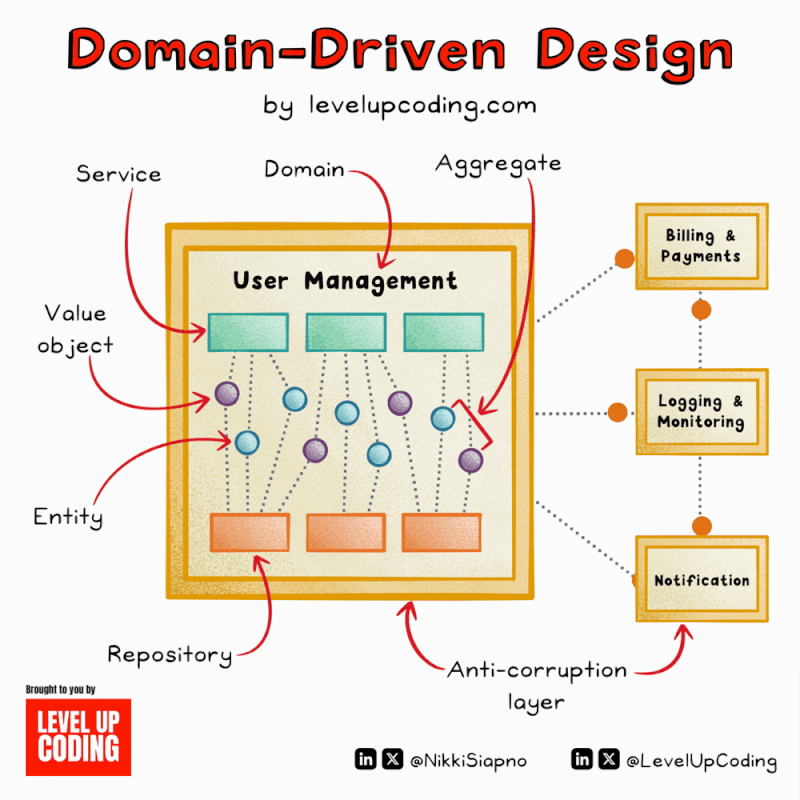
DDD با Microservices ارتباط تنگاتنگی دارد. هر Bounded Context معمولا یک کاندیدای خوب برای تبدیل شدن به یک Microservice مستقل است. این رویکرد به سازمانها کمک میکند سرویسهایی بسازند که با ساختار کسبوکار همسو هستند.
[1] Evans, E. (2003). Domain-Driven Design: Tackling Complexity in the Heart of Software. Addison-Wesley.
[2] Vernon, V. (2013). Implementing Domain-Driven Design. Addison-Wesley Professional.
[3] Millett, S., & Tune, N. (2015). Patterns, Principles, and Practices of Domain-Driven Design. Wrox.
یکی از مشکلات رایج در معماری نرمافزار این است که منطق کسبوکار با جزئیات زیرساختی مثل پایگاهداده، API خارجی، یا رابط کاربری درهم آمیخته میشود. این درهمآمیختگی باعث میشود تست کردن منطق، تغییر دادن پایگاهداده، یا اضافه کردن یک کانال جدید ارتباطی بسیار دشوار شود. Hexagonal Architecture این مشکل را با یک ایده ساده اما قدرتمند حل میکند.
این معماری توسط Alistair Cockburn با نام Ports and Adapters معرفی شد. ایده اصلی این است که منطق اصلی کسبوکار (هسته سیستم) در مرکز قرار میگیرد و از طریق Portها که در واقع Interface هستند، با دنیای خارج ارتباط برقرار میکند. هیچ وابستگی مستقیمی از هسته به جزئیات خارجی وجود ندارد. Adapter نیز وظیفه ترجمه بین زبان دنیای خارج و زبان هسته را دارد.
برای مثال، یک HTTP Adapter درخواست HTTP را میگیرد و آن را به یک فراخوانی متد روی هسته تبدیل میکند. یک Database Adapter متدهای Repository را که هسته میشناسد پیادهسازی میکند و با پایگاهداده واقعی ارتباط برقرار میکند.
ششضلعی بودن شکل این معماری معنای خاصی ندارد و فقط نشان میدهد که یک هسته با جهات متعدد وجود دارد. میتوانیم از سمت API Web یا Primary/Driving Port، از سمت CLI، از سمت یک سیستم خارجی، یا از سمت تستها به هسته دسترسی داشته باشیم.
مهمترین مزیت این معماری، تستپذیری عالیاش هست. چون هسته هیچ وابستگی به زیرساخت ندارد، میتوان آن را کاملا بدون پایگاه داده یا شبکه تست کرد. همچنین تعویض پایگاه داده یا تغییر کانال ارتباطی بدون لمس کردن منطق کسبوکار ممکن است. Clean Architecture و Onion Architecture نیز ایدههای مشابهی دارند.
[1] Cockburn, A. (2005). Hexagonal Architecture. https://alistair.cockburn.us/hexagonal-architecture/
[2] Martin, R. C. (2017). Clean Architecture: A Craftsman's Guide to Software Structure and Design. Prentice Hall.
[3] Wlaschin, S. (2018). Domain Modeling Made Functional. Pragmatic Bookshelf.
در اکثر سیستمها، وقتی چیزی تغییر میکند، مقدار قدیمی را با مقدار جدید جایگزین میکنیم. وقتی کاربر اسمش را عوض میکند، مقدار قدیمی از بین میرود. وقتی موجودی انبار تغییر میکند، فقط عدد جدید باقی میماند.Event Sourcing این رویکرد را به کلی زیر سوال میبرد.
در Event Sourcing به جای ذخیره وضعیت فعلی، تمام رویدادهایی که به آن وضعیت منجر شدهاند را ذخیره میکنیم. مثل اینکه به جای نگه داشتن موجودی فعلی حساب بانکی، تمام تراکنشها را نگه میداریم. موجودی فعلی را در هر لحظه با جمع زدن همه تراکنشها میتوانیم محاسبه کنیم.
این رویکرد مزایای بسیار جالبی دارد. اول، Audit Log کامل که تاریخچه کامل هر تغییری در سیستم ثبت شده است، یعنی کی چه کرده، کجا، و در پاسخ به چه رویدادی. دوم، قابلیت Time Travel که میتوانیم وضعیت سیستم را در هر نقطه از زمان بازسازی کنیم. سوم، امکان Debug کردن کامل که در آن میتوانیم دقیقا ببینیم چه اتفاقی افتاد که به یک باگ منجر شد.
یکی از کاربردهای جذاب Event Sourcing، قابلیت Replay کردن رویدادهاست. اگر یک باگ کشف کنیم، میتوانیم آن را رفع کنیم و سپس تمام رویدادهای تاریخی را دوباره پردازش کنیم تا وضعیت صحیح را به دست بیاوریم. یا اگر یک View جدید نیاز داشته باشیم، میتوانیم از ابتدا تمام رویدادها را پردازش کنیم.
چالشهای Event Sourcing اول اینکه برای بازسازی وضعیت فعلی باید همه رویدادها را پردازش کنیم که با افزایش تعداد رویدادها کندتر میشود که این با Snapshot حل میشود. دوم، تکامل رویدادها (Event Schema Evolution) پیچیده است که اگر فرمت یک رویداد تغییر کند، با رویدادهای قدیمی چه کنیم؟ سوم، این رویکرد با تفکر CRUD رایج فاصله زیادی دارد و نیاز به تغییر ذهنیت دارد.
[1] Young, G. (2010). CQRS and Event Sourcing. https://cqrs.files.wordpress.com/2010/11/cqrs_documents.pdf
[2] Fowler, M. (2005). Event Sourcing. https://martinfowler.com/eaaDev/EventSourcing.html
[3] Vernon, V. (2016). Domain-Driven Design Distilled. Addison-Wesley Professional.
برای مدتهای طولانی، ساخت نرمافزار مستلزم دانش عمیق برنامهنویسی بود. اما موج Low-code و No-code در حال تغییر این معادله است. این پلتفرمها به افراد و سازمانها اجازه میدهند بدون نوشتن یا با نوشتن کد کم اپلیکیشنهای کاربردی بسازند.
No-code پلتفرمهایی هستند که کاملا بدون کد کار میکنند و از رابطهای بصری Drag and Drop استفاده میکنند؛ مثل Bubble، Webflow، یا Airtable. ولی Low-code پلتفرمهایی هستند که تا حد زیادی بصری هستند اما در مواقع لازم اجازه میدهند کد سفارشی هم بنویسیم؛ مثل OutSystems ،Mendix یا Microsoft Power Apps.
این پلتفرمها به چه دردی میخورند؟ به Citizen Developers و کارمندانی که دانش کسب و کار عمیقی دارند اما برنامهنویس نیستند، اجازه میدهند ابزارهای مورد نیاز خودشان را بسازند. همچنین برای سازمانهایی که با کمبود نیروی فنی روبرو هستند، سرعت توسعه را به شکل چشمگیری افزایش میدهند.
کاربردهای رایج شامل ساخت داشبوردهای داخلی، اتوماسیون فرآیندهای کسبوکار، فرمهای سازمانی، و Prototyping سریع ایدهها هستند. برخی سازمانها حتی محصولات کامل و پیچیدهای روی این پلتفرمها ساختهاند.
اما محدودیتهایی هم وجود دارد؛ مثل قابلیت سفارشیسازی محدود برای نیازهای پیچیده، وابستگی به ارائه دهنده پلتفرم (Vendor Lock-in)، چالشهای مقیاس پذیری در برخی موارد، و سوالاتی درباره امنیت و رعایت مقررات. پلتفرمهای Low-code/No-code ابزارهای قدرتمندی هستند، اما نباید به عنوان جایگزین کامل توسعه حرفهای تلقی شوند.
[1] Forrester Research. (2021). The State Of Low-Code Platforms In 2021.
[2] Cabot, J. (2020). About the complexities of low-code/no-code software development. IEEE Software Blog.
[3] Gartner. (2022). Magic Quadrant for Enterprise Low-Code Application Platforms.
هر سازمانی فرآیندهایی دارد؛ از استخدام کارمند تا پردازش سفارش مشتری، از درخواست مرخصی تا تایید فاکتور. مدیریت این فرآیندها به شکل سیستماتیک، قابل اندازهگیری، و بهینهشده دقیقا حوزهای است که BPMS یا سیستمهای مدیریت فرآیند کسب و کار به آن میپردازند.
BPMS یک دسته از نرمافزارهاست که به سازمانها کمک میکند فرآیندهای کسبوکارشان را مدلسازی، اجرا، نظارت، و بهینهسازی کنند. چرخه حیات در BPMS شامل چهار مرحله اصلی است؛ Design که به طراحی فرآیند با استفاده از استانداردهایی مثل BPMN گفته میشود، Deploy یعنی استقرار و اجرای فرآیند، Execute یعنی اجرای خودکار یا نیمهخودکار وظایف و Monitor که نظارت بر عملکرد و شناسایی بهبودها است.
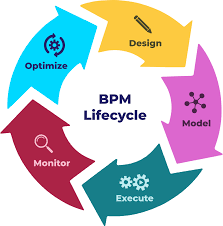
BPMN یا Business Process Model and Notation، زبان استانداردی است که برای توصیف بصری فرآیندهای کسبوکار استفاده میشود. با BPMN میتوانیم جریان کار، تصمیمگیریها، وظایف موازی، رویدادها و مسئولیتها را به شکلی گرافیکی نمایش دهیم که هم برای افراد فنی و هم برای افراد کسب و کاری قابل فهم باشد.
ابزارهای معروف BPMS شامل Camunda که هم Open Source و هم Enterprise دارد و بر پایه BPMN و DMN است، Activiti، IBM Business Process Manager، و Appian هستند. Camunda به خصوص در میان توسعهدهندگان محبوب است چون میتوان آن را بهراحتی در کد Java یا دیگر زبانها جاسازی کرد.
تفاوت BPMS با ابزارهای workflow سادهتر این است که BPMS یک چرخه کامل مدیریت فرآیند را پوشش میدهد و قابلیتهای تحلیلی جدی دارد. میتوان دید کدام مرحله گلوگاه است، میانگین زمان تکمیل هر فرآیند چقدر است و کجا خطا رخ میدهد.
[1] Dumas, M., La Rosa, M., Mendling, J., & Reijers, H. A. (2018). Fundamentals of Business Process Management (2nd ed.). Springer.
[2] Weske, M. (2019). Business Process Management: Concepts, Languages, Architectures (3rd ed.). Springer.
[3] Object Management Group. (2013). Business Process Model and Notation (BPMN) 2.0.2. https://www.omg.org/spec/BPMN/2.0.2
تصور کنید یک سیستم پرداخت آنلاین دارید که در لحظات اوج (مثلا Black Friday) هزاران درخواست در ثانیه دریافت میکند. اگر هر درخواست مستقیما به سرویس پردازش پرداخت ارسال شود، ممکن است سیستم تحت فشار خراب شود. Message Queue راه حل این مشکل است.
یک Message Queue (صف پیام) یک ابزار میانجی است که پیامها را از فرستنده دریافت میکند، آنها را ذخیره میکند، و با سرعتی که دریافتکننده میتواند پردازش کند به او تحویل میدهد. این مکانیزم یک بافر ایجاد میکند که تولیدکننده و مصرفکننده پیام را از هم جدا میکند.
RabbitMQ یک Message Broker سنتی است که بر اساس پروتکل AMQP کار میکند. نقاط قوت آن در پیامرسانی مطمئن (Reliable Messaging)، routing انعطافپذیر، و پشتیبانی از الگوهای مختلف مثلPublish/Subscribe Routing و Topic است. وقتی یک پیام توسط مصرفکننده پردازش شود، از صف حذف میشود.
Apache Kafka رویکرد متفاوتی دارد. Kafka یک سیستم ثبت رویداد توزیعشده است که پیامها را روی دیسک ذخیره میکند و برای مدت زمان قابل تنظیمی نگه میدارد. این یعنی چند Consumer متفاوت میتوانند همان پیام را بخوانند، میتوان پیامهای قدیمی را دوباره خواند (Replay)، و حجم بسیار زیادی از داده را پردازش کرد. Kafka در Stream Processing، Event Sourcing و ادغام سیستمها بسیار قوی است.
چه وقت از کدام استفاده کنیم؟ RabbitMQ برای پیامرسانی سنتی، task queuing و وقتی که پیچیدگی routing نیاز داریم مناسبتر است. Kafka برای streaming دادههای حجیم، Event Sourcing ،Real-time analytics و ادغام بین سیستمهای مختلف انتخاب بهتری است. در بسیاری از معماریهای بزرگ، هر دو ابزار همزمان استفاده میشوند.
[1] Narkhede, N., Shapira, G., & Palino, T. (2017). Kafka: The Definitive Guide. O'Reilly Media.
[2] Roy, M. (2019). RabbitMQ in Depth. Manning Publications.
[3] Richardson, C. (2018). Microservices Patterns. Manning Publications.
یکی از قدیمیترین مشکلات در توسعه نرمافزار این بود که روی ماشین من کار میکند! یعنی اپلیکیشنی که در محیط توسعه درست اجرا میشود، در محیط تولید با مشکل مواجه میشود چون کتابخانهها، تنظیمات، و محیط متفاوت است. Container برای حل این مشکل ساخته شد.
یک Container یک بسته مستقل و قابل اجرا است که شامل کد اپلیکیشن، تمام کتابخانههای مورد نیاز، متغیرهای محیطی، و پیکربندیهاست. Container روی هر ماشینی که Docker (یا موتور Container مشابه) روی آن نصب باشد، به طور یکسان اجرا میشود. به این ترتیب محیط توسعه، تست، و تولید، یکسان هستند.
Docker معروفترین پلتفرم Container است. با یک Dockerfile که دستوراتی مثل از این Image پایه شروع کن، این فایلها را کپی کن، این بستهها را نصب کن را توصیف میکند، یک Docker Image ساخته میشود. از این Image میتوان هر تعداد Container یکسان ایجاد کرد.
اما وقتی اپلیکیشن از دهها یا صدها Container تشکیل شده باشد چطور؟ اینجاست که Container Orchestration وارد میشود. Kubernetes (که معمولا K8s نامیده میشود) محبوبترین سیستم Orchestration است. Kubernetes مسئولیتهایی مثل این را بر عهده میگیرد که زمانبندی و جایگذاری Container روی نودهای مناسب، راهاندازی مجدد Containerهای خراب، مقیاسپذیری خودکار بر اساس بار، مدیریت شبکه و Load Balancing و مدیریت اسرار (Secrets) و پیکربندی.
تفاوت Container با ماشین مجازی (VM) در این است که Container خیلی سبکتر است چون به جای virtualize کردن کل سختافزار، فقط فضای نرمافزار را ایزوله میکند و از Kernel سیستم عامل مشترک استفاده میکند. یک سرور میتواند صدها Container اجرا کند، در حالی که شاید دهها VM داشته باشد.
[1] Burns, B., Grant, B., Oppenheimer, D., Brewer, E., & Wilkes, J. (2016). Borg, Omega, and Kubernetes. ACM Queue, 14(1), 70–93.
[2] Luksa, M. (2017). Kubernetes in Action. Manning Publications.
[3] Docker Documentation. (2023). Docker Overview. https://docs.docker.com/get-started/overview
وقتی یک نرمافزار به عنوان سرویس (SaaS) به چندین سازمان یا مشتری (Tenant) ارائه میشود، یک سوال اساسی مطرح میشود که آیا برای هر مشتری یک نسخه جداگانه نرمافزار مستقر کنیم، یا همه مشتریان از یک نسخه مشترک استفاده کنند؟ معماری Multi-Tenancy پاسخ این سوال است.
در معماری Multi-Tenant، یک نمونه واحد از نرمافزار به چندین مشتری سرویس میدهد، در حالی که دادهها و تنظیمات هر مشتری از دیگران جدا و ایزوله است. فکر کنید به سرویسهایی مثل Salesforce، Slack، یا Jira، هزاران سازمان از همان نرمافزار استفاده میکنند اما دادههایشان کاملاً از هم جداست.
چندین استراتژی اصلی برای پیادهسازی Multi-Tenancy وجود دارد. روش اول، جداسازی در سطح پایگاهداده، یعنی هر Tenant یک Database جداگانه دارد. بیشترین ایزولاسیون را ارائه میدهد اما هزینه بر است. روش دوم، Schema Separation هست، یعنی همه Tenantها در یک Database هستند اما هر کدام یک Schema جداگانه دارند. روش سوم، Row-level Separation هست، یعنی همه دادهها در یک Schema هستند و با یک Tenant ID از هم متمایز میشوند. این ارزانترین روش است اما ایزولاسیون کمتری دارد.
یکی از بزرگترین چالشها در Multi-Tenancy که میشود بهش اشاره کرد، Noisy Neighbor است، وقتی یک Tenant با مصرف زیاد منابع بر عملکرد Tenantهای دیگر تاثیر میگذارد. مکانیزمهایی مثل Rate Limiting و Resource Quotas برای جلوگیری از این مشکل استفاده میشوند.
علاوه بر جداسازی داده، یک Multi-Tenant سیستم باید امکاناتی مثل سفارشیسازی برای هر Tenant (Custom Branding، تنظیمات مختلف)، Tenant-level Authentication and Authorization و قابلیت Onboarding و Offboarding آسان Tenantها را فراهم کند.
[1] Bezemer, C.-P., & Zaidman, A. (2010). Multi-tenant SaaS Applications: Maintenance Dream or Nightmare? IWPSE-EVOL 2010.
[2] Chong, F., & Carraro, G. (2006). Architecture Strategies for Catching the Long Tail. Microsoft MSDN.
[3] AWS. (2022). SaaS Tenant Isolation Strategies. AWS Whitepaper. https://docs.aws.amazon.com/whitepapers/latest/saas-tenant-isolation-strategies
آخرین مفهوم در این بخش، Data Migration یا انتقال داده است، موضوعی که ظاهرا ساده به نظر میرسد اما در عمل یکی از پر ریسکترین فعالیتهای مهندسی نرمافزار است. مهاجرت داده به فرآیند انتقال داده از یک سیستم، قالب، یا ساختار به سیستم، قالب، یا ساختار دیگر گفته میشود.
Data Migration در چندین سناریوی اصلی رخ میدهد، تعویض پایگاهداده (مثلا از Oracle به PostgreSQL)، ارتقای نسخه نرمافزار (که ساختار جدولها تغییر میکند)، ادغام دو سازمان (که دادههای دو سیستم باید ترکیب شوند) و انتقال به فضای ابری.
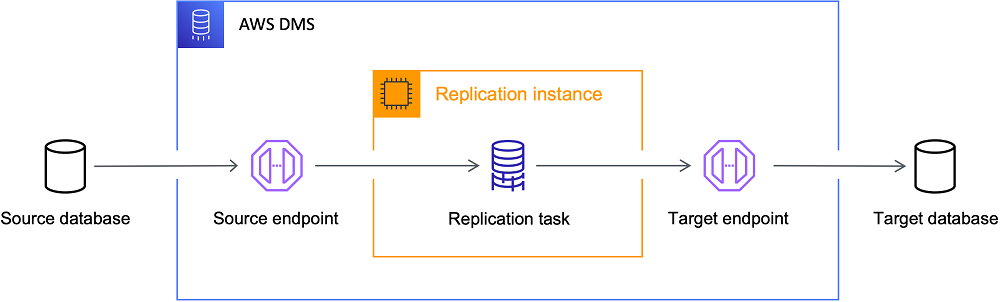
یک Data Migration معمولا شامل مراحل Extract (استخراج داده از منبع)، Transform (تبدیل داده به قالب مقصد و پاکسازی) و Load (بارگذاری در مقصد) است که با عنوان ETL شناخته میشود. مرحله Transform معمولا پیچیدهترین و زمانبرترین بخش است که شامل دادههای تکراری، دادههای ناسازگار، فیلدهای اجباری که خالی هستند، یا ساختارهای متفاوت همه باید مدیریت شوند.
یکی از مهمترین چالشها، مهاجرت بدون توقف سرویس (Zero-Downtime Migration) است. استراتژی رایج Dual Write است، یعنی در مدت مهاجرت، هر نوشتن هم در سیستم قدیمی و هم جدید انجام میشود. به تدریج ترافیک خواندن هم به سیستم جدید منتقل میشود. وقتی مطمئن شدیم همه چیز درست است، سیستم قدیمی خاموش میشود.
اصل مهم در Data Migration این هست که هرگز بدون Rollback Plan مهاجرت نکن. باید همیشه برنامهای برای بازگشت به وضعیت قبلی در صورت بروز مشکل وجود داشته باشد. همچنین تست Migration روی یک کپی از دادههای واقعی (نه دادههای تستی) قبل از اجرای واقعی ضروری است. بسیاری از پروژههای Migration به دلیل کمتوجهی به این مرحله با شکست مواجه شدهاند.
[1] Fowler, M. (2003). Patterns of Enterprise Application Architecture. Addison-Wesley.
[2] Redman, T. C. (2018). If Your Data Is Bad, Your Machine Learning Tools Are Useless. Harvard Business Review.
[3] AWS Documentation. (2023). Database Migration Guide. https://docs.aws.amazon.com/dms/latest/userguide/Welcome.html
اگر تا اینجا همراه من بودهاید، احتمالا با مجموعهای از مفاهیم و الگوهای مهم و پرکاربرد در دنیای مهندسی نرمافزار، معماری نرم افزار و توسعه نرمافزار مدرن آشنا شدهاید. هدف من از نوشتن این مطالب، ارائه یک دید کلی، کاربردی و قابل فهم از موضوعاتی بود که امروزه در بسیاری از پروژههای واقعی و سازمانهای فناوری مورد استفاده قرار میگیرند. طبیعتا هر یک از این مفاهیم دنیایی از جزئیات، تجربیات و مباحث تخصصی را در دل خود دارند و آنچه در این مجموعه ارائه شد، صرفا نقطه شروعی برای آشنایی بیشتر با آنهاست. امیدوارم مطالبی که در این نوشتهها با شما به اشتراک گذاشتم برایتان مفید، کاربردی و الهامبخش بوده باشد و بتواند در مسیر یادگیری، مطالعه یا حتی فعالیت حرفهای شما کمککننده باشد🌱
نویسنده: امین مستوری نژاد
دانشجوی مهندسی نرم افزار دانشگاه شهید بهشتی
خرداد 1405

