
گاها ممکن است در کاربردهای مختلف با حالتهایی مواجه میشویم که در آنها ابعاد دیتاست بسیار بزرگ باشد به عبارت دیگر تعداد فیچرها (d) بسیار زیاد است . این بزرگ بودن سبب میگردد که پیچیدگی دادهها و در نتیجه پیچیدهتر شدن مدلهای ما میشود،که این امر باعث افزایش حجم محاسبات میگردد . هم چنین قابلیت تفسیرپذیری ما نیز کاهش مییابد. لذا با توجه به تمامی موارد گفته شده نیاز به روشهایی جهت کاهش ابعاد داریم .
در بحث کاهش ابعاد،معمولا با دو مفهموم کلی سرکار داریم که عبارتند از :
۱ - انتخاب ویژگی:
در انتخاب ویژگی ما به دنبال یافتن یک زیرمجموعه kعضوی از مجموعه d فیچر خود می باشیم (k<d). قطعا میخواهیم که این فیچرهای انتخاب شده به خوبی بتوانند دادههای ما را نمایندگی کنند و نماینده مناسبی برای کل فیچرهای ما باشند. در عمل مسئله ما به انتخاب زیرمجموعه تغییر میکند. فضای جستجوی انتخاب ویژگی از میان d ویژگی برابر $2^d$ میباشد که به معنای وجود یا عدم وجود هرکدام از ویژگی ها میباشد.
رویکردهای مختلفی برای بحث انتخاب ویژگی وجود دارد که دو روش Forward Selection و
Backward Selection از روشهای پایه ای میباشند. در کنار روش های مطرح شده میتوان از الگوریتم های فراابتکاری همانند الگوریتم ژنتیک برای انتخاب ویژگی بهره برد.
۲- استخراج ویژگی:
در استخراج ویژگی ما به دنبال این میباشیم که ویژگیها را از فضای موجود و اصلی دادهها به فضای جدیدی انتقال دهیم. فضای جدید حاصل ترکیب d فیچر ما از فضای اولیه میباشد .
روش های مختلفی برای استخراج ویژگی به صورت با ناظر، بدون ناظر، خطی یا غیرخطی وجود دارد . برای روش با ناظر میتوان از Factor Analysis(FA)، برای روش بدون ناظر میتوان از
Principal Component Analysis(PCA)، برای روش غیرخطی میتوان از ISO Map نام برد.
به صورت کلی در PCA، ما به دنبال یافتن یک فضای با ابعاد کوچکتر میباشیم به طوری که هنگامی که فیچرهای ما x در فضای اولیه روی این فضا تصویر میشوند از دست رفتن اطلاعات کمینه باشد. اگر بخواهیم این عبارت را به صورت ریاضی بنویسیم به صورت زیر اقدام میکنیم .
x فیچرهای ما در فضای اولیه باشد و wفضای مورد نظر ما باشد که میخواهیم آن را به دست آوریم و تصویر x بر فضایw را با z میتوانیم بنویسیم .
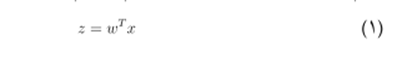
هدف ما یافتن w است به گونه ای که واریانس z که با Var(z)نمایش میدهیم بیشینه گردد.
براساس تعریف واریانس و امید ریاضی میدانیم که :
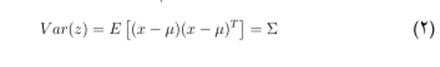
علامت سیگما در این جا بیان گر کوواریانس میباشد.
حال خواهیم داشت :
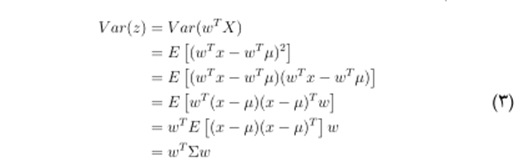
پس هدف ما یافتن w است به طوری که مقدار Var(z) بیشینه گردد . برای w جواب های مختلفی ممکن است یافت شود لذا به جهت این که جواب یکتا باشد فرض میکنیم نرم w برابر ۱ میباشد . حال مسئله به فرم ریاضی بازنویسی میکنیم .
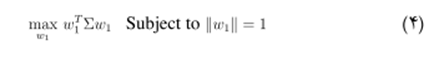
با استفاده از روش لانگرانژ، میتوان قیدها را درون معادله (۴) وارد کرد که معادله (۵) به دست خواهد آمد.
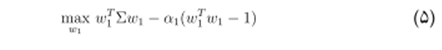
برای یافتن نقطه بهینه از معادله (۵) نسبت به فیچرها مشتق میگیریم و خواهیم داشت :
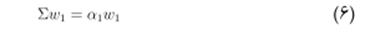
معادله (۶) ما را یاد مفاهیم بردارویژه و مقدارویژه می اندازد .
اگر A یک مبدل خطی و x یک بردار غیرصفر باشد آنگاه به ازای یک اسکالر مانند لامبدا میتوان یک بردارویژه یافت به طوری که :
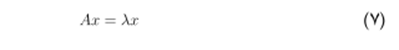
در معادله فوق همان بردارویژه مبدل خطی A میباشد. یکی از ویژگیهای مهم بردارویژه آن است که جهت آن نسبت به مبدل خطی A تغییر نخواهد کرد.
در معادله (۶)، w1 همان بردارویژه برای سیگما که کوواریانس است میباشد. در اصل سوال یافتن یک فضای با ابعاد کوچکتر مانند w به یافتن بردارویژه و مقدارویژه تبدیل میگردد. به w1 اولین مولفه اساسی میگوییم. برای یافتن دومین مولفه اساسی w2 مانند مولفهی w1 عمل میکنیم یعنی هدف یافتن w2 است به گونهای که Var(z) بیشینه گردد.
حال دوباره جهت یکتایی جواب فرم میکنیم نرم w2 هم برابر ۱ است . علاوه بر شرط مطرح شده ما میخواهیم که w2 بر w1 عمود باشد ، در این صورت نسبت به هم مستقل میباشند. خواهیم داشت :
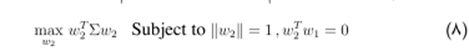
با استفاده از روش لانگرانژ، قیدها را وارد معادله میکنیم و معادله (۹) را خواهیم داشت.
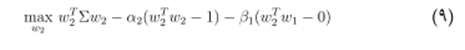
پس از مشتق گیری نسبت به فیچرها داریم :
که w2نیز یک بردارویژه برای کواریانس میگردد.به همین ترتیب برای d فیچرخود یک بردارویژه پیدا میکنیم و d بردارویژه خواهیم داشت سپس از میان این d بردارویژه به انتخاب میپردازیم.
یکی از مباحث مهم در PCAانتخاب تعداد ویژگی هایی است که میخواهیم آنها را انتخاب کنیم . اگر این تعداد k کوچک انتخاب شود تعداد فیچرها کم خواهد بود و فیچرهای انتخابی نمیتوانند به خوبی سایر فیچرها را نمایندگی کنند و اگر kبزرگ انتخاب شود تعداد فیچرهای به دست آمده خیلی به تعداد فیچرهای اصلی نزدیک است و ابعاد ما خیلی کاهش نیافته است.
یکی از راه های یافتن تعداد فیچرها،روش Proportion of Variance(POV)میباشد.
فرض میکنیم لامبدا ها مقادیرویژه ما باشند که به صورت نزولی مرتب شده اند یعنی
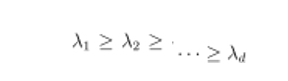
آنگاه داریم :
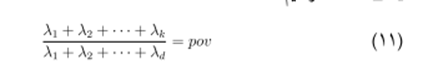
حال با تعیین عددی برای pov مانند ۰.۹میتوانیم k را مشخص کنیم.
شبه کد این روش به صورت زیر میباشد :
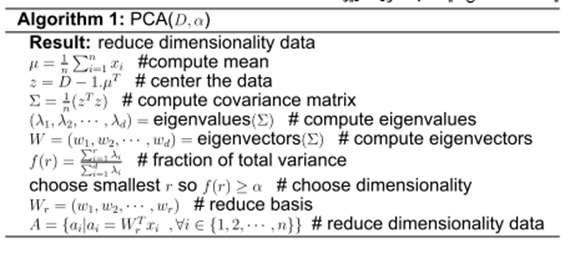
در کد زیر با استفاده از پکیج sklearn به اجرای الگوریتم PCA روی دیتاست IRIS میپردازیم که دیتاست شامل 4 فیچر است و در سه کلاس میباشد که هر کلاس دارای 50 نمونه میباشد . ما در اینجا برای نمایش دو بعدی فیچرها تعداد k = 2 در نظر میگیریم میتوان به جای اینکار از POV بهره برد و مقدار آن را مثلا 0.95 در نظر گرفت و خود الگوریتم تعداد k را برای ما پیدا کند .
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.decomposition import PCA
iris = datasets.load_iris()
X = iris.data
y = iris.target
target_names = iris.target_names
pca = PCA(n_components=2)
X_r = pca.fit(X).transform(X)
plt.figure()
colors = ['navy', 'turquoise', 'darkorange']
lw = 2
for color, i, target_name in zip(colors, [0, 1, 2], target_names):
plt.scatter(X_r[y == i, 0], X_r[y == i, 1], color=color, alpha=.8, lw=lw, label=target_name)
plt.legend(loc='best', shadow=False, scatterpoints=1)
plt.title('PCA of IRIS dataset')
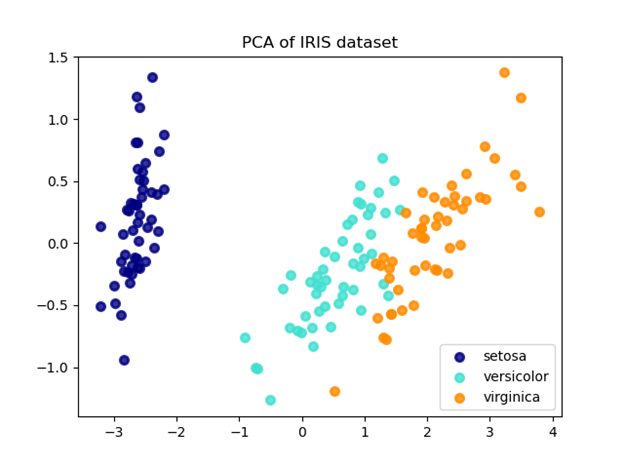
به صورت کلی ممکن است دیتاست هایی با ابعاد بزرگ داشته باشیم که هزینه محاسباتی زیاد و مشکلات دیگری را برما وارد میکنند در نتیجه به روشهایی جهت کاهش بعد نیاز داریم که یکی از این روشها که به صورت بدون ناظر عمل میکند الگوریتم PCAمیباشد.PCAدادههای ما از فضای اصلی که فیچرها ممکن است با هم کورولیشن داشته باشند به فضای جدیدی میبرد که در فضای جدید فیچرها باهم کورولیشنی ندارند . در این الگوریتم ما میتوانیم k فیچر را از dفیچر در فضای جدید انتخاب کنیم و به این ترتیب ابعاد را کاهش داده ایم که برای یافتن kمناسب روش های مختلفی وجود دارد که یکی از این روش ها POVمیباشد.
یکی از نکاتی که باید به آن توجه داشته باشیم الگوریتم PCA برای دادههایی کاربرد دارند که کورولیشنی بین برخی یا همه فیچرها وجود داشته باشد و درصورتی که کورولیشنی بین فیچرها در دیتاست اصلی وجود نداشته باشد، الگوریتم کاربردی برای ما نخواهد داشت.
1. Data Mining and Analysis,Mohamed J.Zaki,2013.
2. Introduction to Machine Learning,Ethem Alpaydin,2004.

