
همیشه برای خیلی از ماها سوال بوده که گوگل یا موتور های جستجو دیگه چجوری اینهمه اطلاعات از سایتهای مختلف پیدا میکنن و بهمون نشون میدن . یکی از روش های این موتور های جستجو توی بازیابی اطلاعات استفاده از سیستم خزشگر یا Crawler هستش . خزشگر دقیقا چیه ؟ این برنامه میتونه تگ های HTML سایت های مختلف در بیاره و اطلاعات خاص و مفید ازشون پارس کنه و برگردونه . اینکه خزشگر گوگل چجوری کار میکنه محرمانه ست . توی این پست میخوام یه خزشگر خیلی ساده رو روی سایت IMDB بهتون اموزش بدم . سایت IMDB یه قسمت داره که همه فیلم های پخش شده از سال 1972 تا سال 2016 هستش رو گذاشته حالا ما میخوایم یکسری اطلاعات مثل سال انتشار یا اسم یا امتیاز های مختلف اسم کارگردان رو دربیاریم. اول از همه باید یه اطلاعایی از ساختار سایت داشته باشیم . اول یه نگاهی به سایت و تگ هاش بندازین :
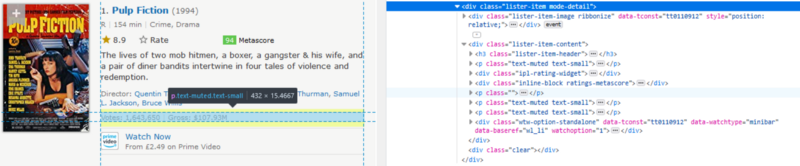
همونجوری که میبینین هر اطلاعاتی که میخوایم با یک کلاس خاص مشخص شده . حالا بریم سراغ کد:
برای Crawl کردن یه سایت ابزار های مختلفی هستش یکی از اون ابزار های کتابخانه BeatifulSoup هستش
import requests import os import re from bs4 import BeautifulSoup
حالا که کتابخانه های لازم وارد کردیم باید ادرس سایت مشخص کنیم یه درخواست بهش بفرستیم و تگ های HTML درخواست کنیم .
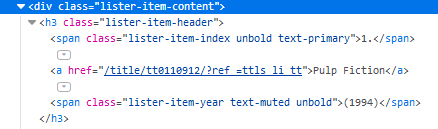
بعد از اینکه HTML سایت رو بدست اوردیم باید الگو اطلاعات که میخوایم رو بدست بیاریم و برای برنامه هم مشخص کنیم . اول لیست div ای که همه فیلما توش هستن رو بدست میاریم.
حالا میتونیم داخل یک حلقه اطلاعات رو در بیاریم .
بعد در اوردن اطلاعات میتوانیم این اطلاعات رو درون یک پایگاه داده مثل SQLAlchemy که یک کتابخانه برای پایتون هستش ذخیره کنیم یا توی یک فایل JSON ذخیره کنیم .

