
Retrieval-Augmented Generation (RAG) فرآیند بهینه سازی خروجی یک مدل زبان بزرگ است، بنابراین قبل از ایجاد پاسخ به یک پایگاه دانش معتبر خارج از منابع داده آموزشی خود ارجاع می دهد. مدلهای زبان بزرگ (LLM) بر روی حجم وسیعی از دادهها آموزش میبینند و از میلیاردها پارامتر برای تولید خروجی اصلی برای کارهایی مانند پاسخ دادن به سؤالات، ترجمه زبانها و تکمیل جملات استفاده میکنند. RAG قابلیتهای قدرتمند LLMها را به حوزههای خاص یا پایگاه دانش داخلی سازمان گسترش میدهد، همه بدون نیاز به آموزش مجدد مدل. این یک رویکرد مقرون به صرفه برای بهبود خروجی LLM است بنابراین در زمینه های مختلف مرتبط، دقیق و مفید باقی می ماند.
LLM ها یک فناوری کلیدی هوش مصنوعی (AI) هستند که به چت ربات های هوشمند و دیگر برنامه های کاربردی پردازش زبان طبیعی (NLP) نیرو می دهد. هدف ایجاد رباتهایی است که میتوانند با ارجاع متقابل به منابع دانش معتبر به سؤالات کاربران در زمینههای مختلف پاسخ دهند. متأسفانه، ماهیت فناوری LLM غیرقابل پیش بینی در پاسخ های LLM را معرفی می کند. علاوه بر این، داده های آموزشی LLM ثابت است و تاریخ قطعی را برای دانشی که دارد معرفی می کند.
چالش های شناخته شده LLM عبارتند از:
شما می توانید مدل زبان بزرگ را به عنوان یک کارمند جدید بیش از حد مشتاق در نظر بگیرید که از مطلع شدن از رویدادهای جاری امتناع می ورزد اما همیشه با اطمینان کامل به هر سوالی پاسخ می دهد. متأسفانه، چنین نگرشی می تواند بر اعتماد کاربران تأثیر منفی بگذارد و چیزی نیست که بخواهید چت بات های شما از آن تقلید کنند!
RAG یک رویکرد برای حل برخی از این چالش ها است. LLM را برای بازیابی اطلاعات مرتبط از منابع معتبر و از پیش تعیین شده دانش هدایت می کند. سازمانها کنترل بیشتری بر خروجی متن تولید شده دارند و کاربران بینشهایی در مورد نحوه ایجاد پاسخ توسط LLM به دست میآورند.
LLM ها از مدل های یادگیری عمیق استفاده می کنند و بر روی مجموعه داده های عظیم آموزش می بینند تا محتوای جدید را بفهمند، خلاصه کنند و تولید کنند. اکثر LLM ها بر روی طیف گسترده ای از داده های عمومی آموزش دیده اند، بنابراین یک مدل می تواند به انواع مختلفی از وظایف یا سوالات پاسخ دهد. پس از آموزش، بسیاری از LLM ها توانایی دسترسی به داده های فراتر از نقطه برش داده های آموزشی خود را ندارند. این باعث می شود که LLM ها ایستا باشند و ممکن است باعث شود که پاسخ های نادرست بدهند، پاسخ های قدیمی بدهند یا در هنگام پرسیدن سوالاتی در مورد داده هایی که در مورد آنها آموزش ندیده اند، دچار توهم شوند.
برای اینکه LLMها پاسخهای مرتبط و خاص بدهند، سازمانها به مدل نیاز دارند تا دامنه خود را درک کنند و از دادههای خود در مقابل پاسخهای گسترده و کلی پاسخهایی ارائه دهند. برای مثال، سازمانها رباتهای پشتیبانی مشتری را با LLM میسازند، و این راهحلها باید پاسخهای خاص شرکت را به سؤالات مشتری بدهند. دیگران در حال ساخت ربات های پرسش و پاسخ داخلی هستند که باید به سوالات کارکنان در مورد داده های منابع انسانی داخلی پاسخ دهند. چگونه شرکت ها چنین راه حل هایی را بدون آموزش مجدد آن مدل ها ایجاد می کنند؟
یک راه آسان و پرطرفدار برای استفاده از دادههای خود این است که آنها را به عنوان بخشی از درخواستی که با آن مدل LLM را جستجو میکنید، ارائه دهید. به این تولید افزوده بازیابی (RAG) گفته می شود، زیرا داده های مربوطه را بازیابی می کنید و از آن به عنوان زمینه تقویت شده برای LLM استفاده می کنید. به جای تکیه صرف بر دانش به دست آمده از داده های آموزشی، یک گردش کار RAG اطلاعات مربوطه را جمع آوری می کند و LLM های ثابت را با بازیابی داده ها در زمان واقعی متصل می کند.
با معماری RAG، سازمانها میتوانند هر مدل LLM را مستقر کرده و آن را تقویت کنند تا با دادن مقدار کمی از دادههای خود، بدون هزینهها و زمان تنظیم دقیق یا پیشآموزش مدل، نتایج مرتبط را برای سازمان خود به دست آورند.
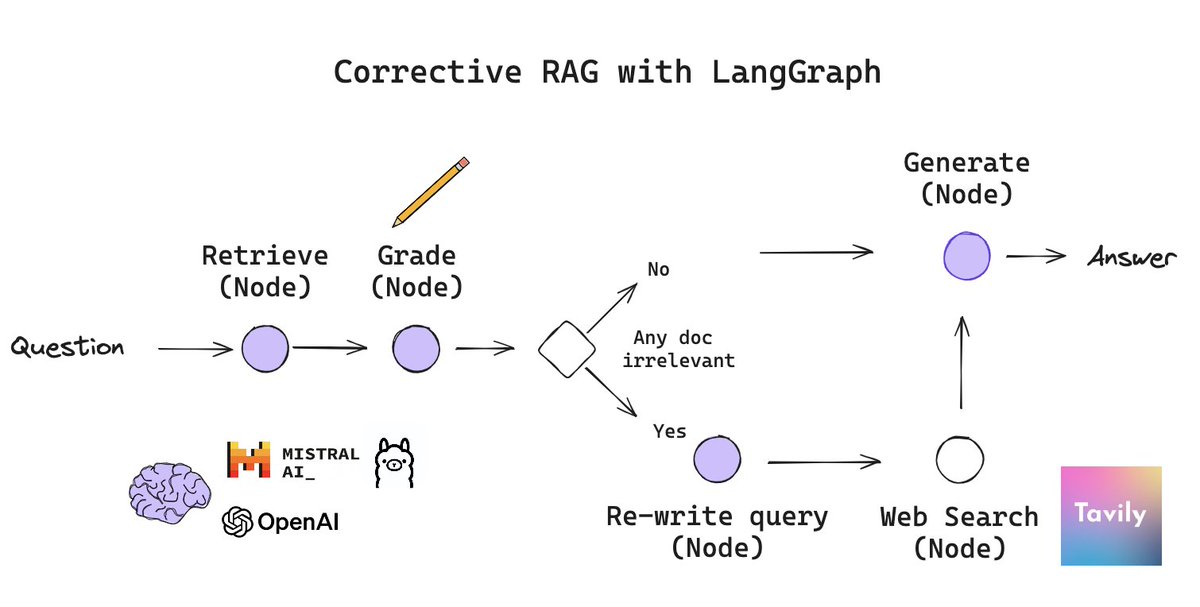
موارد استفاده مختلفی برای RAG وجود دارد. رایج ترین آنها عبارتند از:
رویکرد RAG دارای چندین مزیت کلیدی است، از جمله:
RAG مکان مناسبی برای شروع است، آسان و احتمالاً برای برخی موارد استفاده کاملاً کافی است. تنظیم دقیق در موقعیتهای متفاوت، زمانی که فرد میخواهد رفتار LLM تغییر کند یا “زبان دیگری” را یاد بگیرد، مناسبتر است. اینها متقابل نیستند. به عنوان یک گام آینده، می توان یک مدل را برای درک بهتر زبان دامنه و فرم خروجی مورد نظر تنظیم کرد – و همچنین از RAG برای بهبود کیفیت و ارتباط پاسخ استفاده کرد.
چهار الگوی معماری برای سفارشی کردن یک برنامه LLM با داده های سازمان شما وجود دارد. این تکنیک ها در زیر توضیح داده شده اند و متقابل نیستند . در عوض، آنها را می توان (و باید) با هم ترکیب کرد تا از نقاط قوت هر یک استفاده کرد.
https://aliayoubi.com/retrieval-augmented-generation-rag/

