
در چند روز گذشته، هوش مصنوعی توجه خود را به ویدیوهای بی صدا معطوف کرده است . به طور خاص، آوردن صدا به کلیپ های تولید شده توسط هوش مصنوعی.
بازوی تحقیقاتی DeepMind گوگل یک مدل هوش مصنوعی جدید قدرتمند ساخته است که میتواند صدا را بدون صدا به ویدیوها اضافه کند و با جلوههای صوتی و موسیقی دوبله کند.
آنچه در مورد تحقیقات جدید بسیار چشمگیر است، توانایی دنبال کردن دقیق تصاویر است. در یکی از کلیپها نمای نزدیک از نواختن گیتار را نشان میدهند و موسیقی در SFX دقیقاً با نتهای واقعی در حال پخش مطابقت دارد.
📷
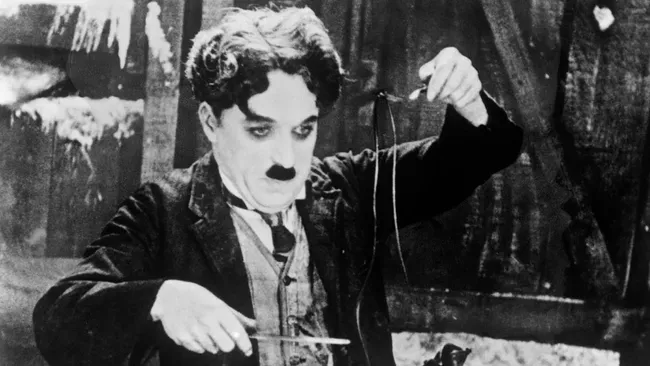
از برخی جهات، این روی دیگر سکه است که ماه گذشته از طریق ElevenLabs نسل موسیقی مبتنی بر یک دستور بصری را دید و با خود پتانسیل زیادی برای بازسازی رسانه های قدیمی که دیگر جزء صوتی ندارند به همراه دارد – و چارلی چاپلین ممکن است در صورت پیشرفت بیشتر، صدای جدیدی دریافت خواهید کرد.
در حالی که مدل Google DeepMind هنوز برای استفاده در دسترس نیست، ابزار مشابهی از ElevenLabs وجود دارد که می توانید امروز آن را امتحان کنید. اگر می خواهید ویدیویی ایجاد کنید تا آن را امتحان کنید، می توانید لیست 5 بهترین تولید کننده ویدیوی هوش مصنوعی ما را بررسی کنید.
در رشته پستهای X ، حساب DeepMind Google کارها را با شخصیتی شروع میکند که در یک تونل روشن و وحشتناک قدم میزند.
برخی از موسیقی های سبک کر را می توان از بالای سازهای کوبه ای دراماتیک شنید، زیرا گام های شخصیت هنگام حرکت در صحنه شنیده می شود.
ما در حال به اشتراک گذاشتن پیشرفت در فناوری تولیدکننده ویدیو به صدا (V2A) هستیم. این میتواند صدا را به کلیپهای بیصدا اضافه کند که با آکوستیک صحنه مطابقت دارد، اکشن روی صفحه را همراهی میکند، و موارد دیگر. در اینجا ۴ مثال وجود دارد – صدای خود را روشن کنید.
نمونه سازدهنی در نحوه تغییر گام آن کمی بیش از حد “دره عجیب و غریب” به نظر می رسد، اما قسمت پشتی زیرین جامد است، در حالی که چتر دریایی شبیه چتر دریایی است. نکته قابل توجه این است که برخی از نکات اضافی، از جمله “حیات دریایی” و “اقیانوس” دارد.
با این حال، ویدئویی با اعلان “یک درامر روی صحنه در یک کنسرت احاطه شده توسط چراغ های چشمک زن و جمعیتی که تشویق می کنند” کمی دور است. برای اولین بار، ضربات با ریتم ویدیو به محض اینکه پخش می شود، مطابقت ندارند، در حالی که به نظر می رسد چوب ها روی تله و شاید کف تام متمرکز شده اند، در حالی که صدا با برخی درام های دیگر کمی پیچیده تر به نظر می رسد.
با این حال، این یک شروع چشمگیر برای پروژه ای است که احتمالاً با گذشت زمان رشد می کند.
مانند بسیاری از پروژه های گوگل، این هنوز منتشر نشده است، فقط یک پیش نمایش تحقیقاتی است. گوگل می گوید محدودیت ها و مسائل ایمنی وجود دارد که ابتدا باید به آنها رسیدگی شود.
به عنوان مثال: “از آنجایی که کیفیت خروجی صدا به کیفیت ورودی ویدئو بستگی دارد، مصنوعات یا اعوجاج های موجود در ویدئو که خارج از توزیع آموزشی مدل هستند، می توانند منجر به افت قابل توجه کیفیت صدا شوند.”
آنها همچنین روی همگام سازی لب برای ویدیوهای دارای گفتار کار می کنند، در حالی که در حال حاضر تلاش برای انجام این کار، همیشه دقیق نیست و جلوه دره ای عجیب ایجاد می کند.
ما برای معرفی Text to Sound Effects API هیجانزده هستیم. برای نمایش آن – ما اولین برنامه Video to Sounds Effects را ساختهایم. این برنامه به صورت آنلاین و کاملا متن باز در دسترس اس.
ناگفته نماند، ElevenLabs این هفته API جدید Text to Sound Effects خود را معرفی کرد که می تواند بر اساس آنچه در آن آپلود می کنید جلوه های صوتی ایجاد کند.
برخلاف مدل V2A گوگل، API از ElevenLabs در حال حاضر قابل دسترسی است و از آزمایشها به طرز شگفتآوری خوب کار میکند.
در مثال بالا، ویدیویی از شکستن بطری چند گزینه مختلف برای انتخاب دارد، در حالی که میم خندان دی کاپریو صدای اضافی را از افراد دیگر در اتاق دریافت می کند.
این شرکت یک برنامه سریع را برای نشان دادن آنچه با API امکان پذیر است، راه اندازی کرد، و به شما این امکان را می دهد که یک ویدیو آپلود کنید و از آن بخواهید صدا را اضافه کند. این برای استفاده رایگان و منبع باز است و میتوانید همین الان آن را امتحان کنید .
ElevenLabs به Tom’s Guide گفت که هدف واقعی این است که شرکتها و توسعهدهندگان دیگر چیزهایی را با API خود بسازند، مانند ادغام در ویدیوی تولیدی.

