
اگر ChatGPT آیفون است، پس AppStore هنوز ساخته نشده است و این مجموعه ای از برنامه های کاربردی عمودی خواهد بود که در بالای آن ساخته شده است. هر صنعت، هر کسب و کار و هر فردی قرار است این برنامه ها را به روش های کوچک و بزرگ بسازد. شروع از ساختن یک ChatGPT مخصوص مراقبتهای بهداشتی یا تولید، تا نوشتن ایمیلهای دامنه خاص برای بازاریابی، تا پاسخ دادن به سؤالات خاص سازمانی از پایگاه دانش داخلی، تا حتی ساخت موتورهای جستجوی شخصی برای پاسخ به سؤالاتی مانند آدرس جان چیست یا چه زمانی. تولد مادرشوهر من است؟ ما در پست قبلی وبلاگمان در اینجا چند نمونه نوشتیم.
📷
برای درک این موضوع، درک وب شفاف در مقابل عمیق مهم است:
مدلهایی مانند ChatGPT بر روی یک مجموعه داده عظیم آموزش داده میشوند، اما همه چیزهایی که در وب شفاف موجود است. بنابراین نمیتوانید از آن سؤالی بپرسید که پاسخ آن به هر چیزی در وب عمیق مانند ایمیل یا اسناد خصوصی شما بستگی دارد. با این حال، در فرآیند یادگیری از مجموعه دادههای گسترده وب واضح، مدلهایی مانند ChatGPT آنقدر هوشمندی در مورد زبان و معنایی ایجاد میکنند که یادگیری اطلاعات جدید از مقادیر کم داده برای یک کار خاص برای آن بسیار آسانتر است.
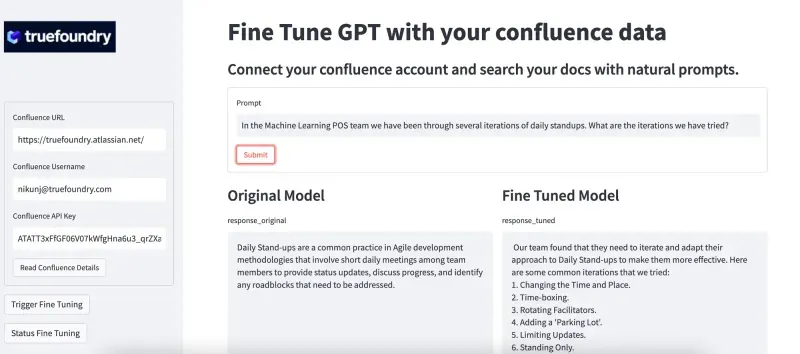
تنظیم دقیق یک تکنیک قدرتمند است که به ما امکان می دهد از دانش و یادگیری یک مدل از پیش آموزش دیده مانند ChatGPT برای بهبود عملکرد مدل در یک کار جدید با آموزش آن بر روی یک مجموعه داده کوچکتر و مختص کار استفاده کنیم. به عنوان مثال، فرض کنید می خواهید یک سیستم پاسخگویی به سوالات برای اسناد شرکت داخلی خود که در Confluence ذخیره شده است بسازید. می توانید تمام محتوای متنی را از محل تلاقی خود منتقل کنید و یک مدل GPT را با آنها تنظیم کنید.
ساده به نظر می رسد. چرا همه این کار را نمی کنند؟
در حالی که OpenAI اصطکاک زیادی را از طریق API های تنظیم دقیق خود کاهش داده است، هنوز هم به کمی توجه، برنامه ریزی و تلاش در محورهای مختلف نیاز دارد.
دادههایی که برای تنظیم دقیق مدلها نیاز دارید باید در قالب جفت تکمیل سریع باشد.
{“prompt”: <prompt-text>, “completion”: <ideal generated text>}
چند نکته قابل تامل:
OpenAI چندین مدل دارد که می توان آنها را به دقت تنظیم کرد و هر یک از آنها معاوضه هایی دارند که باید در نظر گرفته شوند.
توجه: همچنین میتوانید مدلی که قبلاً تنظیم شده است را به صورت تدریجی تنظیم کنید. به دلیل تغییر APIها، محدودیتهایی در چارچوب زمانی وجود دارد که مدلها باید پس از ۲۱ آوریل ۲۰۲۲ بهطور دقیق تنظیم شده باشند.
ما سعی کردیم از تنظیم دقیق APIهای OpenAI با پارامترهای پیشفرض استفاده کنیم و آنها روی برخی از وظایف بسیار خوب کار میکردند، اما میتوانستیم با تغییر پارامترهای فوقالعاده تا 40 درصد پیشرفت داشته باشیم.
هزینه های تنظیم دقیق بسته به پارامترهایی که تصمیم می گیرید انتخاب کنید بسیار متفاوت است، بنابراین داشتن درک دقیق بسیار مهم است.
برای ۱ میلیون توکن:
– آدا: ۰.۴ دلار
– بابیج: ۰.۶ دلار
– کوری: ۳ دلار
– داوینچی: ۳۰ دلار.
استفاده از مدلهای تنظیمشده بهطور قابلتوجهی گرانتر (~ ۵ برابر) از نمونههای از پیش آموزش دیده است.
برای ۱ میلیون توکن،
– آدا: ۱.۶ دلار در مقابل ۰.۴ دلار
– بابیج: ۲.۴ دلار در مقابل ۰.۵ دلار
– کوری ۱۲ دلار در مقابل ۲ دلار
– داوینچی ۱۲۰ دلار در مقابل ۲۰ دلار
هنگامی که از مدل استفاده می کنید، پارامترهایی مانند bestof و n نیز بر هزینه شما تأثیر می گذارند، زیرا در نهایت برای یک درخواست، چندین تکمیل ایجاد می کنید. استفاده از max_response_length را برای صرفه جویی در هزینه یا کاهش استفاده از پارامترهای best_of و n در نظر بگیرید.
ساختن یک مدل دقیق برای مجموعه داده تلاقی خودمان بی اهمیت نبود.
واکشی داده ها
برای فهمیدن خواندن تمام دادههای Confluence از طریق APIهای آن کمی تلاش کردم، زیرا Confluence دادههای غنی با جداول، سرفصلها و زیرعنوانها دارد و من مجبور شدم آن را به متن ساده برای سهولت استفاده تبدیل کنم. همچنین، مدیریت مجوزها و سطح دسترسی مناسب، بی اهمیت نبود. در نهایت، ما توانستیم یک فرم بسیار ساده ایجاد کنیم که در آن آدرس، نام کاربری و کلید API را ارسال کنید و ما بتوانیم داده ها را واکشی کنیم.
پیش پردازش داده ها
این سخت ترین قسمت بود. در اینجا ما چندین رویکرد را امتحان کردیم –
ما در نهایت بیشتر جفتها را از شماره ۳ انتخاب کردیم، اما تعدادی نمونه تصادفی از شماره ۱ و ۲ بالا را نیز انتخاب کردیم. برای مجموعه داده خود ما بیش از ۵۰۰۰۰ جفت اعلان و تکمیل با طول متوسط ۱۷ کلمه برای درخواست و ۱۳۳ کلمه برای پاسخ ایجاد کردیم که در مجموع ۱۵۰ کلمه در هر جفت است. در حالت ایده آل، این مرحله به آزمایش بسیار بیشتری نیاز دارد.
تنظیم دقیق مدل
ما با مدلها و فراپارامترهای مختلف آزمایش کردیم و متوجه شدیم که کوری نسبت به آدا یا بابیج بهتر عمل میکند، اما با توجه به هزینهها احساس میکردیم که آدا خوب است. ما داوینچی را امتحان نکردیم. ما مجبور شدیم نرخ یادگیری را تغییر دهیم و روی 0.05 قرار گرفتیم در حالی که مدل را برای 6 دوره اجرا کردیم. هزینه آموزش 1 اجرا کوری حدود 30 دلار و آدا حدود 4 دلار بود. به طور کلی از طریق یک سری آزمایش، ممکن است برای ما 400 دلار اعتبار OpenAI برای تنظیم دقیق هزینه داشته باشد – ما همچنین چند اجرا بد داشتیم.
آزمایش کردن
ما متوجه شدیم که مدل تنظیم شده به شدت بهتر از مدل اصلی در سوالات مربوط به مجموعه داده های داخلی ما عمل می کند. ما از تیم ما خواستیم که حدود ۱۰۰ درخواست عجیب و غریب را امتحان کند و آنها را به صورت دستی رتبه بندی کند. این علمی نیست اما برای این مورد استفاده ساده کار می کند. جالب توجه است، ما متوجه شدیم که در برخی موارد، مدل دقیق تنظیم شده بدتر از مدل اصلی برای پرس و جوهای عمومی عمل می کند. ما هنوز باید آنچه در اینجا اتفاق می افتد را اشکال زدایی کنیم.
این یک تمرین سرگرمکننده بود و ما روی مجموعههای داده دیگر آزمایش خواهیم کرد.
اگر مجموعه داده خاصی را می خواهید، یا می خواهید من این برنامه را برای استفاده برای Confluence خود باز کنم، با من در [email protected] تماس بگیرید.
TrueFoundry یک PaaS استقرار ML بر روی Kubernetes برای سرعت بخشیدن به گردش کار توسعه دهندگان است و در عین حال به آنها امکان انعطاف کامل در آزمایش و استقرار مدل ها را می دهد و در عین حال امنیت و کنترل کامل را برای تیم Infra تضمین می کند. از طریق پلتفرم خود، تیمهای یادگیری ماشینی را قادر میسازیم تا مدلها را در 15 دقیقه با 100% قابلیت اطمینان، مقیاسپذیری، و توانایی بازگشت به عقب در عرض 15 دقیقه استقرار و نظارت کنند – به آنها اجازه میدهیم هزینهها را صرفهجویی کنند و مدلها را سریعتر به تولید برسانند و امکان تحقق ارزش واقعی کسبوکار را فراهم کنند. .

