
نام دانشجو : علی سیاهکالی
شماره دانشجویی : 982075443
درس پایگاه داده
با افزایش سیستم های کامپیوتر و گسترش تکنولوژی اطلاعات بحث اصلی در علم کامپیوتر از چگونگی جمع آوری اطلاعات به نحوه استفاده از اطلاعات منتقل شده است. سیستم های داده کاوی این امکان را به کاربر میدهند که بتواند انبوه داده های جمع آوری شده را تفسیر کنند و دانش نهفته در آن را استخراج نمایند.
داده کاوی به طور همزمان از چندین رشته علمی بهره میگیرد مانند تکنولوژی پایگاه داده ، هوش مصنوعی ، یادگیری ماشین ، شبکه های عصبی ، آمار ، شناسایی الگو ، سیستم مبتنی بر دانش ، حصول دانش ، بازیابی اطلاعات ، محاسبات سرعت بالا و بازنمایی بصری داده.
در این مقاله ابتدا نگاه کلی بر داده کاوی ، استراتژی های داده کاوی سپس طرح چند مثال مرتبط و انواع داده ها و نیز بیان مراحل داده کاوی روی داده ها مطرح خواهد شد.
مفهوم داده کاوی (موسسه گارتنر) :
داده کاوی کشف واسبتگی ها ، الگو ها و روند های با معنی و جدید با وارسی مقادیر زیاد داده های ذخیره شده در انباره ها با استفاده از تکنیک های تشخیص الگو به همراه روش های ریاضی و آماری میباشد. به عبارتی داده کاوی به معنای جستجو در یک پایگاه داده برای یافتن الگو هایی میان داده ها است.
بنابراین هدف اصلی از داده کاوی کشف دانش نهفته در محیط مورد بررسی است که این دانش میتواند شکل های گوناگونی داشته باشد. دانش استخراج شده میتواند به فرم الگو های موجود در داده ها باشد که کشف این الگو ها منجر به شناخت بهتر سیستم نیز میشود. الگو های استخراجی عموما بیانگر روابط بین ویژگی های سیستم هستند. مثلا در سیستم تجاری یک الگو میتواند بیانگر رابطه بین نوع کالا و میزان تقاضای آن باشد.
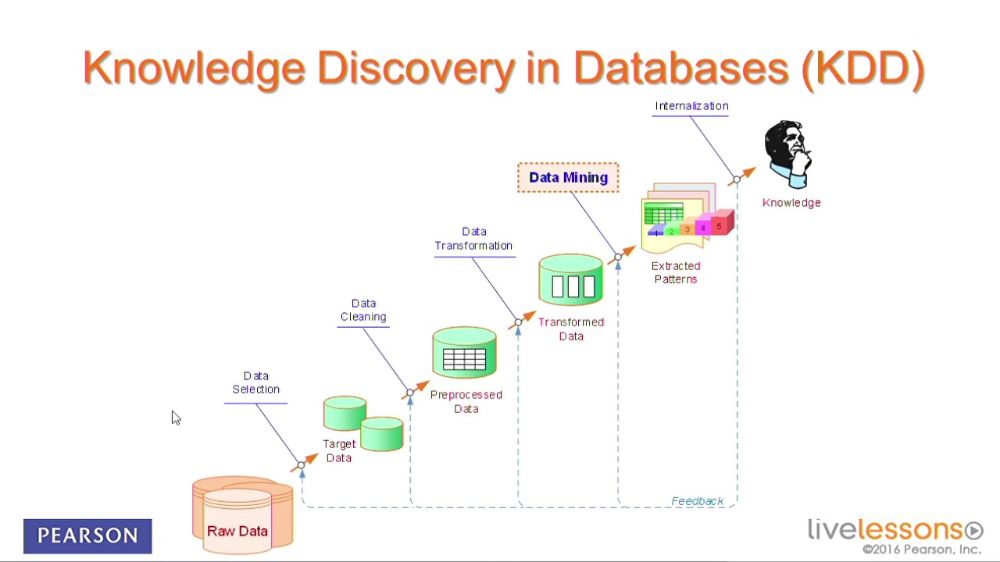
کشف دانش یا KDD
در پایگاه داده اصطلاحی است که مکررا بجای داده کاوی بکار میرود. از نظر تکنیکی کاربردی از روش های علمی داده کاوی است.
شاپیرو که در سال 1989 واژه KDD را ابداع کرده است میگوید :
" واژه KDD در جامعه هوش مصنوعی و یادگیری ماشین متداول شد ولیکن محققان پایگاه داده ها در ارتباط بیشتری برای گفتمان با اهل کسب و کار و رسانه ها بودند و واژه داده کاوی در اخبار کسب و کار متداول شده. داده کاوی واژه ای قدیمی تر از KDD است که در جامعه تحلیل داده های آمار محور ابداع شده است.
مزیت داده کاوی قابلیت فهم عمیق تر الگو هایی است که با تکنولوژی های گزارش گیری موجود قابل مشاهده نیستند.
لزوم استفاده از KDD :
1- در تجارت باعث بهینه سازی و عملکرد بهتر در بازار های حیاتی ، رقبا و مشتریان میشود.
2- سهولت در تحلیل داده ها
3- با توجه به نرخ داده ها بکار گیری روش های سنتی کارساز نیست. حجم داده ها برای روش های تحلیل کلاسیک بیش از اندازه بزرگ است و ممکن است نتوانیم آنرا در حافظه کامپیوتر نگه داریم. چگونه میتوان میلیون ها رکورد و ده ها یا صد ها فیلد را کاوش کرد و الگو یافت؟
4- شبکه سازی : فرصتی مناسب و رو به رشد برای دسترسی بیشتر فراهم کرده است.
5- بطور روز افزون ، کاوش بلادرنگ مشخصات کالا ها ، اطلاعات سفر و سایر خدمات برروی اینترنت مورد نیاز است.
6- کاربر نهایی ، آمار دان نیست.
7- نیاز به تشخیص و پاسخ سریع به فرصت های درحال ظهور ، قبل از رقبا وجود دارد.
8- با رشد پایگاه داده ها ، توانایی انجام تحلیل و تصمیم گیری به کمک پرس و جوی سنتی (SQL) غیر ممکن میشود.
9- بیان بسیاری از پرس و جو های جالب انسانی با زبان پرس و جوی معمولی دشوار است. مثلا افرادی که احتمالا محصول x را میخرند را پیدا کن.
10- مشکل فرموله کردن پرس و جو وجود دارد. این مشکل با بهینه سازی پرس و جو قابل حل نیست و در حوزه ی پایگاه داده ها یا در روش های کلاسیک آماری به آن توجه کافی نشده است. راه طبیعی روش آموزش از طریق مثال است (مثلا در یادگیری ماشین و تشخیص الگو).
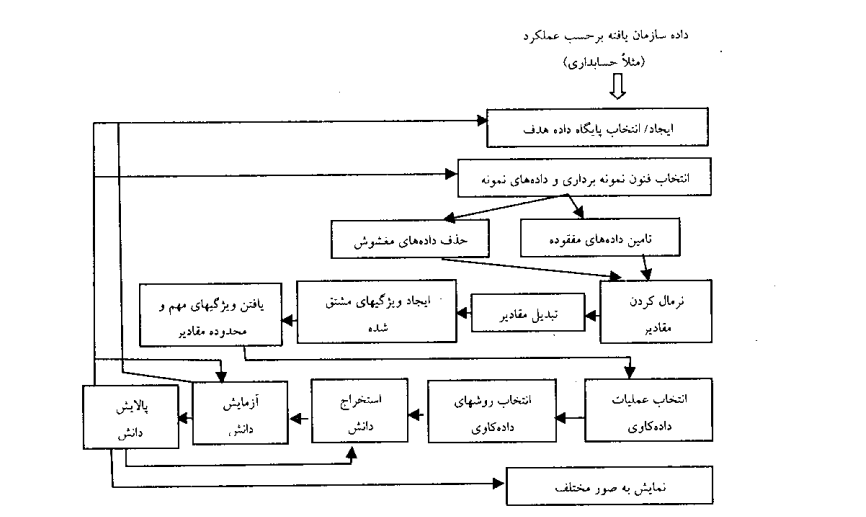
انواع داده ها جهت داده کاوی :
عملیات داده کاوی به یک نوع از داده ها محدود و محصور نمیشود. معمولا داده های مختلفی توسط این سیستم پذیرفته میشوند. البته تکنیک های متفاوتی برای انواع مختف داده ها مناسب اند یعنی یک راهکار کلی ندارد.
داده های غیر ساخت یافته (Unstructured) مانند متون
داده های نیم ساخت یافته (Semi structured) مانند اسناد
داده های ساخت یافته (structured) مانند جداول در مدل رابطه ای
مراحل داده کاوی
اغلب به عنوان بخشی از فرایند کشف دانش از پایگاه داده تلقی میشود. کشف دانش از پایگاه داده فرایندی است که داده های خام را به دانش مفید تبدیل میکند که علاوه بر داده کاوی شامل دو مرحله پیش پردازش و پس پردازش نیز میباشد.
پیش پردازش : جهت بهبود کیفیت داده های واقعی برای داده کاوی. هدف پیش پردازش تبدیل داده های خام به قالبی است که برای تحلیل های بعدی مناسب باشد همچنین این مرحله به شناسایی ویژگی ها و قطعات مختلف داده کمک میکند.
از آنجایی که داده ها با قالب های مختلف در پایگاه داده های متفاوتی ذخیره شده اند اغلب زمان زیادی برای پیش پردازش داده لازم است.
وظایف پیش پردازش عبارتند از :
1- پاکسازی داده ها (Data cleaning) شامل نرمال سازی ، حذف نویز ، کاهش افزونگی ، برطرف کردن ناسازگاری و پرکردن داده های مفقودی
2- یکپارچه سازی داده ها (Data Integration) یکپارچه سازی از منابع مختلف چند پایگاه ناهمگن
3- تبدیل داده (Data transformation) هموار سازی ، تجمیع و نرمال سازی
4- کاهش داده (Data Reduction) یافتن ویژگی های مفید
5- تصویر کردن و کاهش بعد : با تبدیلات و کدگذاری تولید داده فشرده و اصلی میشود.
روش های داده کاوی
توصیفی : خواص عمومی داده هارا مشخص میکند.
پیش بینانه : با مدلسازی داده های در دسترس سعی میکند یک پیش بینی صحیح از داده های آتی و آزمایشی داشته باشند.
کاربرد های داده کاوی :
انتخاب اطلاعات مفید از بین انبوه داده ها و گروه بندی
1- کاربرد های معمول تجاری : از قبیل تحلیل و مدیریت بازار ، تحلیل سبد بازار ، بازار یابی هدف ، فهم رفتار مشتری ، تحلیل و مدیریت ریسک.
2- مدیریت و کشف فریب : کشف فریب تلفنی ، کشف فریب های بیمه ای و اتومبیل ، کشف حلقه های کارت های اعتباری ، کشف تراکنش های مشکوک مالی (پول شویی)
3- متن کاوی (text mining) : پالایش متن (نامه های الکترونیکی ، گروه های خبری و غیره)
4- پزشکی : کشف ارتباط علامت و بیماری ، تحلیل آرایه های DNA ، تصاویر پزشکی
5- ورزش : آمار های ورزشی
6- وب کاوی (Web mining) : وب یک مخزن داده ای پویا ونیز ناهمگن محسوب میشود. پیشنهاد صفحات مرتبط ، بهبود ماشین های جستجوگر یا شخصی سازی حرکت در وبسایت
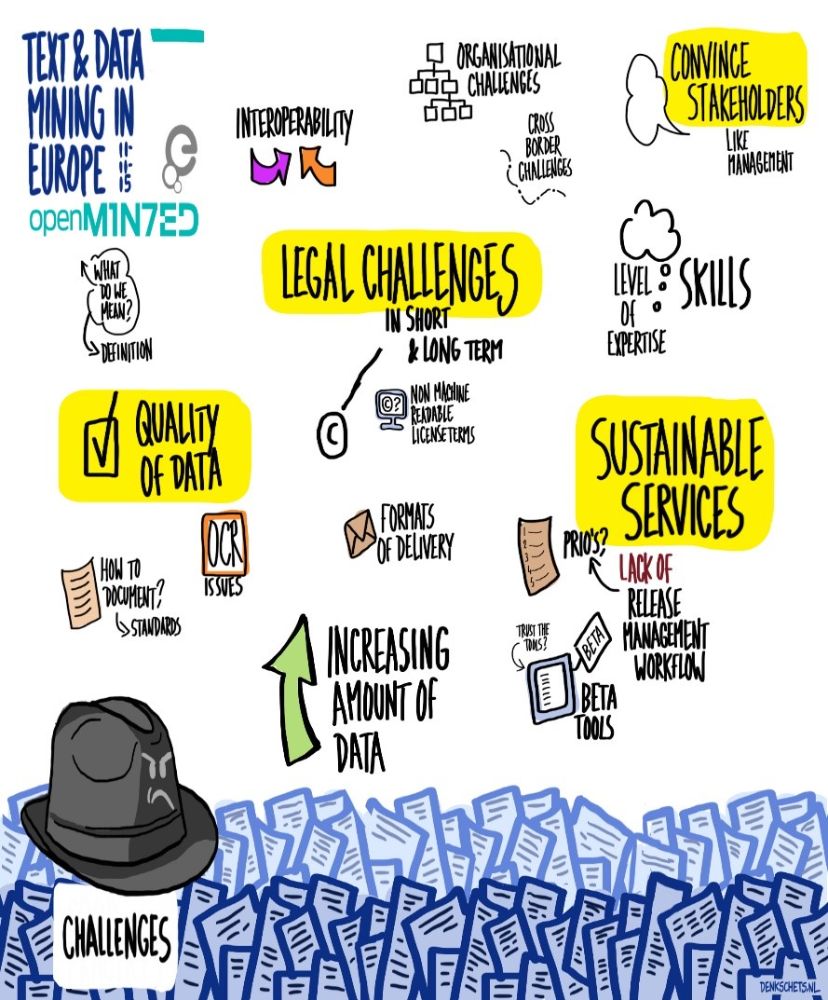
چالش های داده کاوی
تنوع داده ها و عملیات و تکنیک های داده کاوی باعث چالش هایی میشود :
توسعه روش ها و سیستم های داده کاوی کارا ، ساخت محیط های داده کاوی مجتمع و تعاملی ، طراحی زبان های داده کاوی و بکار بستن تکنیک های داده کاوی جهت حل برنامه های کاربردی عظیم از مهم ترین وظایف پژوهشگران و توسعه دهندگان این حوزه است.
1- پایگاه داده بزرگتر : پایگاه داده با صدها فیلد و جدول ، میلیون ها رکورد و اندازه های چند میلیارد بایتی کاملا متداول هستند و استفاده از پایگاه داده ترابایتی معمول میشود.
2- بعد زیاد : زیرا اندازه فضای جستجو نیاز به تلاش برای استقرا مدل را بطور فزاینده ای بزرگ میکند چاره ی این مشکل استفاده از روش های کاهش بعد موثر و استفاده از دانش پیشین برای تشخیص متغیر های نامربوط است.
3- بیش پردازش : منجر به عملکرد ضعیف مدل روی داده های آزمون میشود.
4- تشخیص معنا دار بودن آماری : باید از روش هایی که آماره آزمون را به عنوان تابعی از جستجو تنظیم میکنند استفاده شود.
5- داده و دانش درحال تغییر : باید روش های تدریجی برای به هنگام کردن الگو ها و برخورد با تغییر به عنوان یک فرصت کشف ( با بکار بردن آن بعنوان راهنمایی برای جستجوی خودالگو های تغییر )
6- داده مفقود و مغشوش : این مشکل بخصوص در پایگاه داده های تجاری حاد است. راه حل ممکن بکار بردن استراتژی های آماری پیچیده تر برای تشخیص متغیر ها و وابستگی های مخفی است.
7- روابط پیچیده بین فیلد ها : نیاز به الگوریتم هایی دارند که بتوانند بطور موثر ازین اطلاعات استفاده کنند. الگوریتم های داده کاوی بطور تاریخی برای رکورد های ( ویژگی مقدار ) ساده توسعه یافته اند. البته روش های جدیدی برای عمل روی رابطه بین متغیر ها در حال توسعه اند.
8- قابل درک بودن الگو ها : در کاربرد های داده کاوی از راه های ممکن عبارتند از نمایش گرافیکی برای خلاصه کردن توزیع یک ویژگی معین یعنی هیستوگرام ، ساختار بندی قواعد با گراف های جهت دار غیر دوری ، بکارگیری زبان طبیعی و فنون مصورسازی داده و دانش.
9- تعامل با کاربر و دانش پیشین : بسیاری از روش ها واقعا تعاملی (Interactive) نیستند و نمیتوانند به آسانی دانش پیشین درباره یک مسله ( بجز موارد ساده ) در نظر بگیرند. استفاده از دانش حوزه مورد مطالعه در همه مراحل فرایند KDD مهم است.
10- تلفیق با سیستم های دیگر : نمونه های تلفیق عبارتند از تلفیق با DBMS از طریق رابط پرس و جو ، تلفیق با صفحه گسترده ها و ابزار های مصورسازی و همچنین میتوان حسگر هایی را برای قرایت بلادرنگ داده ها با این سیستم ها تلفیق نمود.
گرایش های داده کاوی که منعکس کننده این چالش هاست :
1- ایجاد سیستم های داده کاوی خاص یا تک منظوره : معمولا برنامه های موجود داده کاوی برای رقابت در حوزه تجارت طراحی و پیاده سازی شده اند البته حوزه های دیگری مانند بیوانفورماتیک بسیار مستعد استفاده از راهکار های داده کاوی هستند به همین دلیل توسعه سیستم های خاص جهت این کاربرد ها یک نیاز محسوب میشود.
2- توسعه روش های مقیاس پذیر و تعاملی : حجم بسیار زیاد داده ها و نرخ رشد بالای آن و تعامل بیشتر کاربران با سیستم های داده کاوی نیز از چالش های این حوزه محسوب میشود البته بعضی از سیستم ها با پذیرفتن محدودیت های کاربران ، خروجی الگوریتم انتخابی را به سمت دلخواه کاربران هدایت میکنند.
3- استاندارد سازی زبان های داده کاوی : با آموزش ساده تر و ارتباط میان چند سیستم داده کاوی و بهبود این چالش کوشش هایی انجام شده است.
4- طراحی و پیاده سازی روش های جدید برای انواع داده های پیچیده : الگوریتم های کنونی ساختار ساده ای دارند مثل جداول در مدل رابطه ای ، انبار داده ها و پایگاه داده تراکنشی رشد بی رویه داده ها در شکل ها و ساختار های پیچیده مثل داده های خاص مانند متون ، داده های چند رسانه ای ، گراف ها و ... چالش بزرگی است.
5- توسعه داده کافی توزیع شده (Distributed) و بلادرنگ (Real time) :
بسیاری از الگوریتم های موجود داده کاوی محیط های توزیع شده ی مناسب ندارند داده کاوی پویا نیز یکی از باید هایی است که راهکار هایی را جهت استفاده در اینگونه محیط ها میطلبد.
چالش های دیگر : امنیت – داده کاوی بصری (visual Data mining) – داده کاوی و مهندسی نرم افزار و ... از موضوعات پژوهشی محققین خواهد بود.
داده کاوی دانشجویان انصرافی به منظور افزایش نرخ ماندگاری دانشجو
از چالش های موسسات آموزشی بالاخص موسسات آموزش عالی غیرانتفایی کسب درآمد جهت تحقق اهداف است اما انصراف دانشجو در نقطه مقابل قرار دارد. با شناسایی دانشجویان انصرافی میتوان با اتخاذ سیاست های پیشگیرانه و حمایتی از کاهش وجه موسسه جلوگیری و امیدوار به جذب درآمد مورد انتظار شد. با استفاده از داده کاوی اطلاعات دانشجویان انصرافی را شناسایی میکنیم.
داده ها از سامانه آموزش استخراج و از بیست صفت محتملی موثر در انصراف مدلی مثلا با دقت 92 درصد شناسایی میشود. در مدل مذکور شش مشخصه مستقل ( سن ، گروه ، مقطع ، دوره تحصیلی ، مشروطی و جنسیت ) و یک مشخصه وابسته ( سنوات ) شناسایی و متعاقبا درجه اهمیت مشخصه های دخیل در انصراف و ارتباط آنها با یکدیگر تعیین میشود. احتمال خطر انصراف ( ریسک ریزش ) اولویت بندی و جدول احتمال برای ترم های مختلف ارایه میشود.
یافته ها حکایت از شناسایی سن به عنوان مهم ترین عامل را دارد. از نظر سنی در کارشناسی پرخطر ترین گروه ها هستند از لحاظ دوره تحصیلی در کارشناسی و دکتری دوره رسمی و در ارشد دوره آموزشی پژوهشی رسمی پر خطر ترین دوره میباشند. نرخ انصراف برای دانشجویان 19 و 20 سال در ترم سوم تقریبا 50 درصد است.
مشکلات اساسی درمان سرطان و عدم وجود روشی مناسب در تشخیص زودرس
تشخیص در مراحل اولیه : تعیین و پیش بینی با الگوریتم های ژنتیکی با واکنش های شیمیایی درون یک عضو میتواند بصورت الگو های پروتینی در مایعاتی نظیر خون ، خلط و ادرار انعکاس داده شود.
ابزار های مناسب جهت تهیه پروفایل های پروتینی از نمونه های بیولوژیک :
طیف سنج جرمی جذب – یونیزاسیون لیزری سطحی ارتقا یافته
ارایه یک روش داده کاوی جهت انتخاب نشانگر های حیاتی تفکیک کننده ی گروه های سالم از سرطانی ( چالش مهم در تحلیل الگو های پروتینی است).
داده کاوی ترکیبی مبتنی بر سه معیار آزمون آماری – اندازه تفکیک پذیری کلاس و امتیازدهی نقاط معرفی شده است. با این روش بهترین زیر مجموعه پروتینی برای تعیین نشانگر های حیاتی استفاده میشود. ( الگوریتم بهینه سازی جمعی در تشخیص بیماری )
داده ها دو دسته میشوند : یادگیری و آزمون حداقل آستانه برای آمارگان انتخاب میشود. الگوریتم داده کاوی به نقاط باقی مانده از مرحله آستانه دهی اعمال شد و بهترین زیرمجموعه ویژگی ها شامل نشانگر های حیاتی با قدرت تمایز بالا انتخاب گردید این روش نشان داد که با کاهش تعداد نشانگر های حیاتی منتخب که از مزیت های این روش میباشد ، قدرت تفکیک پذیری از سطح مناسبی برخوردار است.
طبق نتایج بدست آمده تاکید دارد که انتخاب مناسب زیرمجموعه پروتین های شاخص تاثیر بسزایی در تعیین نشانگر های حیاتی در تشخیص صحیح بیماری دارد.
شبکه های عصبی
روشی است که با استفاده از مدل های ریاضی و توان کامپیوتر برخی از جنبه های ساده مغز انسان را شبیه سازی میکند.
برخی کاربرد های دسته بندی براساس شبکه های عصبی
1- دسته بندی مسافرین خطوط هواپیمایی برمبنای اطلاعات سفر ها در دسته بندی مسافرین کثیرالسفر و ارایه خدمات ویژه به آنها با استفاده از ایجاد مدل های شبکه عصبی در خطوط هواپیمایی
2- دسته بندی خانواده محصولات تولیدی بر اساس زمان های تولید در سیستم های تولید انعطاف پذیر کارخانجات چند منظوره با استفاده از داده کاوی بر اساس شبکه عصبی
3- ایجاد سیستم های خبره تحت وب در زمینه شناسایی بازار های هدف محصولات متفاوت با استفاده از آموزش شبکه های عصبی مصنوعی از طریق داده های خرید مشتریان تحت وب
4- فعالیت های بحرانی و غیر بحرانی در برنامه ریزی و کنترل پروژه بر اساس بانک اطلاعات زمان تخصیص یافته به هر پروژه در شرکت های عمرانی
بخش عمده از کاربرد های شبکه عصبی عملیات تخمین و پیش بینی داده کاوی است. دسته بندی هم حوزه مناسبی برای کاربرد این شبکه است.
مثلا برای خوشه بندی گروه های اندازه از روش شبکه عصبی مصنوعی خودسازمان دهنده به علت قابلیت های آن استفاده میشود. در شبکه عصبی متغیر ها براساس شباهت خود در خوشه های مختلفی قرار میگیرند.
ساختار یک شبکه خودسازمان دهنده مانند ساختار یک شبکه پرسپترون یک لایه دارای یک لایه ورودی و تعدادی نرون خروجی است.
آموزش شبکه با n ورودی و m خروجی است. نرون های لایه ورودی وظیفه انتقال داده ها به شبکه را برعهده دارند تعداد نرون های موجود در لایه خروجی به مسیله مورد مطالعه وابسته است و توسط کاربر مشخص میشود.
آموزش شبکه بر اساس کمترین فاصله ی اقلیدسی است. در واقع از میان نرون های خروجی نرونی به عنوان برنده ( خروجی شبکه ) انتخاب میشود که در میان نرون های خروجی کمترین فاصله اقلیدسی را با نمونه ورودی داشته باشد. البته شاخص های اعتبار سنجی متنوعی برای سنجش صحت نتایج خوشه بندی مقایسه روش های مختلف خوشه بندی با مقایسه نتایج حاصل از یک روش با پارامتر های مختلف پیشنهاد شده اند مثلا شاخص Davis Bouldin در این معیار از شباهت بین دو خوشه استفاده میکنند که براساس پراکندگی یک خوشه و عدم شباهت بین دوخوشه تعریف میشود. این شاخص در واقع میانگین شباهت هر خوشه را با شبیه ترین خوشه به آن محاسبه میکند. هرچه مقدار این شاخص کمتر باشد خوشه های بهتری تولید میشود. برای انجام این سنجش میتوان از محیط نرم افزاری MATLAB استفاده کرد.
منابع :
کتاب داده کاوی رسولی
کتاب داده کاوی غضنفری
جزوات سید محمدتقی روحانی رانکوهی
Dataacademy.ir
استاد راهنما :
دکتر مریم حاجی اسمعیلی. دکترای علوم کامپیوتر از دانشگاه کینگستون لندن
Dr.Maryam Hajiesmaeili
PhD of computer science from Kingston university of London

