
ابرداده ها و داده های بزرگ
نام دانشجو : علی سیاهکالی
شماره دانشجویی : 982075443
درس پایگاه داده
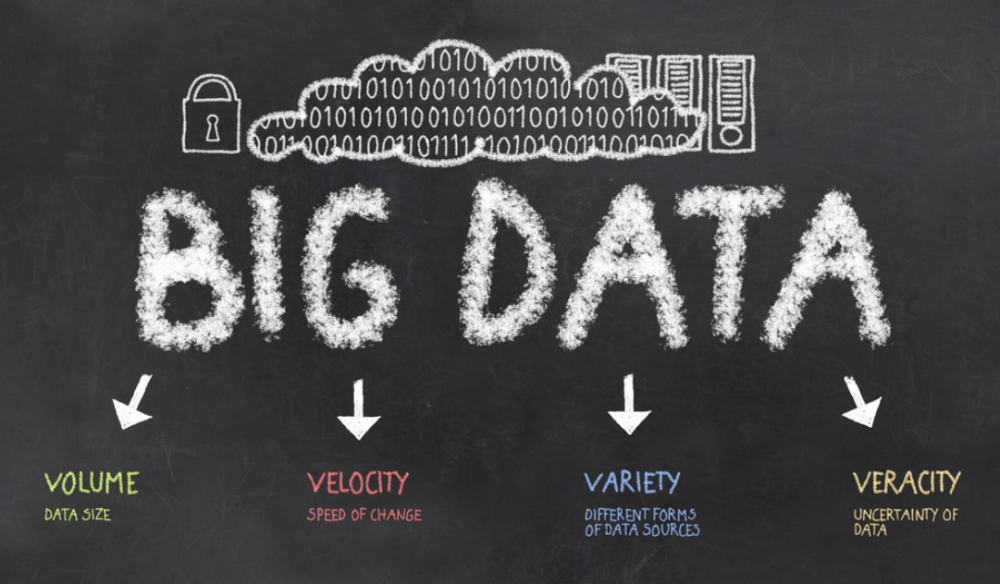
Big Data اصطلاحی است برای مجموعه داده های حجیم که بزرگ ، منتوع ، با ساختار پیچیده و با دشواری هایی برای ذخیره سازی ، تحلیل و تصویر سازی ( نمایش ) ، پردازش های بیشتر یا نتایج میباشد. پروسه تحقیق بر روی داده های حجیم جهت آشکار سازی الگو های مخفی و راز همبستگی ها ، تجزیه و تحلیل Big data نامیده میشود. این اطلاعات مفید برای سازمان ها و شرکت ها در جهت کسب بینش غنی تر و عمیق تر و موفقیت در رقابت کمک میکند. به همین دلیل اجرا های Big data نیاز دارند تا در صورت امکان تحلیل شوند و بطور دقیق اجرا گردند.
مقدمه
Big data و تجزیه تحلیل اش در مرکز علوم و تجارت های مدرن هستند. این داده ها از تراکنش های Online email ها ، ویدیو ها ، صوت ها ، کلیک کردن های log ها و ارسال ها ، درخواست های جستجو ، یادداشت های درست ، تعاملات شبکه های اجتماعی ، داده های علمی ، سنسور ها و تلفن های همراه و برنامه های کاربردی آنها تولید میشوند. آنها برروی پایگاه داده ها که به شکل حجیم رشد میکنند ذخیره میشوند و ضبط ، شکل دهی ، ذخیره سازی ، مدیریت ، به اشتراک گذاری ، تحلیل و نمایش آنها از طریق ابزار های نوعی نرم افزار پایگاه داده ها دشوار میشود.
در قسمت یک پیامد های اساسی ، مزایا ، چالش ها ، بررسی نتایج ، مثال ها ، روش ها و اکتشاف دانش از Big Data ارایه داده شده است و در قسمت دو پیامد های مهم در پیامد های امنیتی بازبینی میشود. و قسمت سه مزایا ، موانع بالفعل ، چالش ها و موانع Big Data را ارایه میدهد.
1- پیامد های مهم
Big Data به یک گام چرخشی رو به جلو از تحلیل داده های سنتی نیاز دارد که با سه مولفه اصلی اش توصیف میشود : variety ( تنوع یا گوناگونی ) ، volume ( حجم ) ، velocity ( سرعت ).
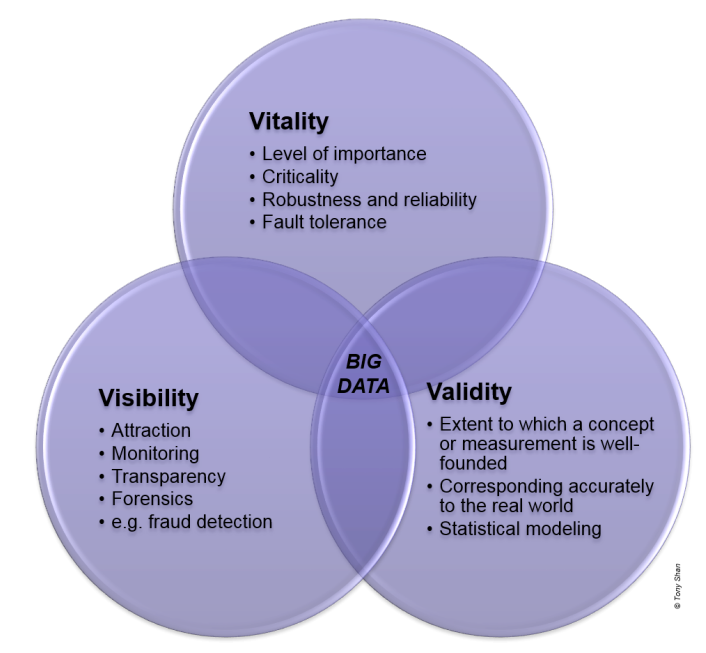
Variety ( تنوع یا گوناگونی )
تنوع Big Data را واقعا بزرگ میکند. Big Data از یک تنوع بزرگ از منابع می اید و عموما این سه نوع را دارد : structured (ساخت یافته ) ، semi structured (نیمه ساخت یافته) ، unstructured (بدون ساخت).
داده های ساخت یافته در یک انبار داده قبلا برچسب زده شده insert میشود و براحتی ذخیره میگردد اما داده های بدون ساخت رندوم هستند و تحلیل آنها دشوار است. داده های نیمه ساخت یافته با فیلد های ثابت تطبیق داده نمیشوند اما شامل برچسب هایی جهت جدا سازی عناصر داده میباشند.
Volume ( حجم )
حجم یا اندازه داده هم اکنون بزرگ تر از ترابایت و پتابایت است. مقیاس بزرگ و پیشرفت داده ها ، روش های سنتی ذخیره سازی و تکنیک های تحلیل را پشت سر میگذارد.
Velocity ( سرعت )
سرعت نه تنها لازمه Big Data است بلکه لازمه همه پردازش ها میباشد. برای پردازش های محدود به زمان Big Data باید مورد استفاده قرار بگیرد همانطور که در سازماندهی به منظور به حداکثر رساندن ارزش خود ، جریان دارد.
در کنار کثرت این اطلاعات مولفه دیگر ، تصدیق جریان داده است. کنترل داده بزرگ مشکل میباشد بنابراین امنیت داده باید تامین شود. به علاوه پس از تولید و پردازش Big Data آن باید یک مقدار اضافه جهت سازماندهی ایجاد کند.
تجزیه و تحلیل داده های حجیم میتواند به صد ها سرور نیاز داشته باشد که با نرم افزار موازی به شکل انبوه اجرا میشود. آن چیزی که داده های حجیم را جدا از تنوع و حجم و سرعت آن واقعا متمایز میکند ، پتانسیل تحلیل آن برای آشکار سازی بینش های جدید جهت بهینه سازی تصمیم گیری است.
2- نمونه هایی از داده های حجیم
نمونه های واقعا در دسترس از داده های حجیم عبارتند از : در ستاره شناسی ، علوم جوی ، ژنومیک ( علم تجزیه و تحلیل داده های ژنتیکی ) ، بیوژیوشیمی ( شیمی زیستی جغرافیایی ) ، علوم و تحقیقات زیستی ، دولت ، حوادث طبیعی ، منابع مدیریت ، بخش خصوصی ، مراقبت نظامی ، خدمات مالی ، جزییات ، شبکه های اجتماعی ، وبلاگ ها ، متون ، اسناد ، عکاسی ، صوت ، ویدیو ، جریان کلیک کردن ، جستجو ، اندیس گاری ، سوابق جزییات تماس ، اطلاعات اعتباری ، شناسایی فرکانش رادیویی ( RFID ) ، تلفن های همراه ، شبکه های حسگر و ارتباطات از راه دور.
سازمان ها در هر صنعتی که دارای داده های حجیم هستند میتوانند از تحلیل های دقیق خود در کسب بینش و دقیق بینی جهت حل مشکلات واقعی نفع ببرند.
3- روش ها ( Methods )
اکثر شرکت ها با مقدار زیادی داده های جدید که در اشکال مختلف بسیاری دریافت میشوند روبرو هستند. Big Data این پتانسیل را دارد که بینش هایی ایجاد کند. که میتواند هر کسب و کاری را دگرگون کند. Big data یک صنعت کاملا جدید از معماری های پشتیبانی کننده نظیر ( Map reduce ) ایجاد کرده است. Map reduce یک Framework برنامه نویسی است. برای محاسبات توزیع شده که بوسیله Google تولید شده و از روش تقسیم و غلبه استفاده میکند.
جهت در هم شکستن مسایل داده های حجیم مختلط به بخش های کاری کوچک و پردازش موازی آنها. Map reduce میتواند به دو مرحله تقسیم شود :
- Map step (گام نگاشت)
داده ی گره اصلی (Master node) به تعدادی زیر مسیله کوچک تر خرد میشود. یک گره کارگر (Worker node) تعدادی زیر مجموعه از مسیله های کوچک تر را تحت کنترل گره دنبال کننده کار (Job tracker node) پردازش میکند و نتایج را در سیستم فایل محلی ذخیره میکند. جایی که یک کاهنده ( reducer ) قادر به دسترسی به آن باشد.
- گام کاهش ( Reduce step )
این مرحله داده های ورودی از مراحل نگاشت را تحلیل و ادغام میکند. میتواند چندین وظیفه کاهش جهت موازی سازی اجتماع ، وجود داشته باشد و این وظایف (Tasks) برروی node های کارگر تحت کنترل دنبال کننده کار ( Job tracker) انجام میشود.
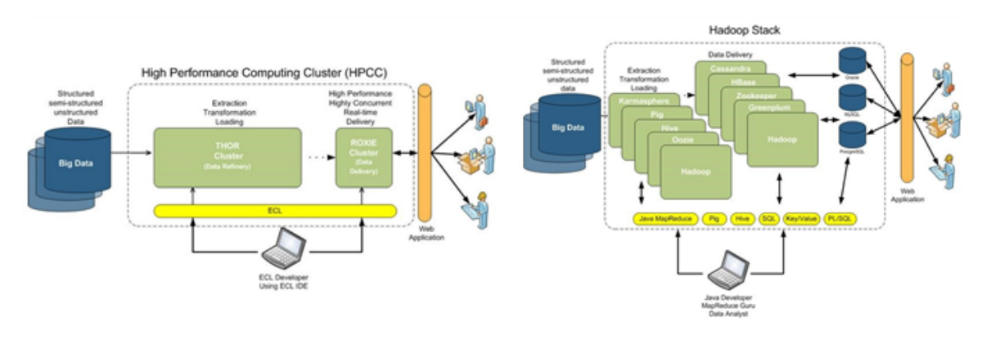
Hadoop با الهام از جدول بزرگ (Big table) که یک سیستم ذخیره سازی داده های Google است سیستم فایل گوگل و Map reduce بوجود آمد.
Hadoop یک Framework مبتنی بر جاوا و سکوی متن باز ناهمگون (heterogenous open source platform) است. Hadoop جایگزینی برای Database انبار (Warehouse) یا استراتژی ) Extract , Transform , Load ) نیست. Hadoop شامل یک سیستم فایل توزیع شده ، تجزیه و تحلیل و سکوی ذخیره سازی داده میباشد و یک لایه ای که محاسبات موازی ، گردش کار و مدیریت پیکربندی را اداره میکند. Hadoop برای پردازش رویداد های مختلط بلادرنگ مثل رشته ها طراحی نشده است.
HDFS (Hadoop Distributed File System) یا سیستم فایل توزیع شده Hadoop در میان گره ها در یک خوشه Hadoop اجرا میشود و سیستم های فایل تعدادی داده ورودی و خروجی را به هم متصل میکند تا آنها را بصورت یک سیستم فایل بزرگ درست کند.
همانطور که در شکل زیر میبینید Hadoop ارایه میدهد :
HDFS : یک سیستم فایل توزیع شده ی بسیار تحمل کننده خطا است که مسؤل ذخیره سازی داده ها در کلاستر ها میباشد.
Map Reduce : یک تکنیک برنامه نویسی قدرتمند برای پردازش موازی کلاستر ها است.
Hbase : یک پایگاه داده ی توزیع شده ی مقیاس پذیر برای دسترسی خواندن/نوشتن بطور تصادفی است.
Pig : یک سیستم پردازش داده سطح بالا برای تحلیل مجموعه های داده که بوسیله یک زبان سطح بالا رخ میدهد.
Hive : یک برنامه کاربردی ذخیره سازی داده است که یک رابط (Interface) مشابه SQL و مدل رابطه ای را فراهم میاورد.
Sqoop : یک پروژه برای انتقال داده بین پایگاه داده رابطه ای و Hadoop.
Avro : یک سیستم از داده های مرتب.
Oozie : یک جریان کار برای کار های Hadoop وابسته.
Chukwa : یک زیرپروژه Hadoop به عنوان سیستم جمع آوری داده برای نظارت سیستم های توزیع شده.
Flume : مجموعه ی log های جاری توزیع شده و قابل اعتماد.
Zookeeper : یک سرویس مرکزی است جهت فراهم آوردن همزمانی توزیع شده و سرویس های گروهی.
4- کشف دانش از داده های حجیم (KDD)
کشف دانش از داده های حجیم عبارت است از تعدادی عملگر که برای دریافت اطلاعات از مجموعه های داده پیچیده طراحی شده اند.
کشف دانش از داده های حجیم با استفاده از Hadoop را در سه اصل تحلیل میکند :
1- کشف دانش از داده ها شامل روش های تحلیلی منتوعی میباشد مانند برنامه نویسی توزیع شده ، الگو شناسی ، داده کاوی ، پردازش زبان طبیعی ، تجزیه و تحلیل احساسات ، تجزیه و تحلیل آماری و تصویری و تعاملات کامپیوتری بشر.
بنابراین معماری باید روش های تحلیل و متود های متنوعی را پشتیبانی کند.
2- یک معماری KDD جامع باید نگهداری و بکار انداختن خط پردازش را تامین کند.
3- این یک اصل است که نتایج ساده و در دسترس باشند. و روش های زیر جهت رسیدن به این موضوع استفاده میشوند : استفاده از استاندارد های رایج و متن باز. استفاده از معماری های مبتنی بر Web. نتایج با قابلیت دسترسی عمومی.
مسایل حفظ حریم خصوصی و امنیت
یک مدل امنیتی مبتنی بر داده های حجیم دارای مشخصه های زیر میباشد :
- منابع داده داخلی و خارجی که در مقدار ضرب میشود و یک تاثیر آموزشی همکاری کننده ایجاد میکند.
- ابزار های خودکار که انواع داده های مختلف را جمع آوری کرده و آنها را نرمال میکنند.
- مدیریت موتور های تجزیه و تحلیل جهت پردازش حجم بزرگی از داده هایی که در زمان واقعی به سرعت در حال تغییر هستند.
- سیستم های نظارت پیشرفته که بطور مداوم سیستم های با ارزش بالا و منابع را تجزیه و تحلیل میکنند و بر منبای رفتار و مدل های خطا رسیدگی میکنند.
- کنترل های فعال از قبیل نیاز تصدیق هویت کاربر سنتی ، مسدود کردن انتقال داده ها یا ساده سازی تصمیم گیری تحلیل گران.
- متمرکز سازی انبار بطوریکه همه داده های وابسته امنیتی برای تحلیل گران امنیتی جهت پرس و جو در دسترس باشند.
- استاندارد سازی دیدگاه ها به نمایش های سازگار که به شکل قابل خواندن برای ماشین ایجاد شده اند و میتوانند در مقیاس منابع قابل اعتماد به اشتراک گذاشته شوند.
- زیر ساخت های n لایه که در تمام جهات مقیاس پیری را ایجاد میکنند و قادر به پردازش پرس و جو ها و جستجو های بزرگ و پیچیده هستند.
- درجه بالایی از یکپارچگی از طریق امنیت و ابزار های مدیریت خطا جهت تسهیل بررسی مفصل مشکلات بالقوه.
ارزیابی کلی
حجم داده ها افزایش پیدا کرده است و تجزیه و تحلیل مجموعه داده ها رقابتی تر شده است. چالش فقط جمع آوری و مدیریت حجم وسیعی از انواع مختلفی از داده ها نیست بلکه استخراج ارزش معنا دار از داده است. همچنین نیاز است به مدیران و تحلیل گرانی با بینش عالی از اینکه چگونه میتوان داده های حجیم را بکار برد. شرکت ها باید در بکار گیری برنامه ها شتاب کنند. در حین اینکه سرمایه گذاری های قابل توجهی در آموزش و پرورش پرسنل کلیدی انجام دهند.
منابع و رفرنس ها :
1- A.Vailaya, “Whats all the buzz around “big data?”” , IEEE Women in engeenering Magazine
2- B.Brown, M.Chui and J.Manyika, “Are you ready for the era of Big Data?” Mckinsey Quarterly, Mckinsey gloal institute
3- B.Gerhardt, K.Griffin and R.Klemann, “Unlocking value in the fragmented world of Big data analytics” Cisco internet business
استاد راهنما :
دکتر مریم حاجی اسمعیلی. دکترای علوم کامپیوتر از دانشگاه کینگستون لندن
Dr.Maryam Hajiesmaeili
PhD of computer science from Kingston university of London

