
تحلیل تطبیقی غلطیابی در زبانهای پارسی و انگلیسی: از بیقاعدگیهای نوشتاری تا پیچیدگی صرفی (ساختواژه)
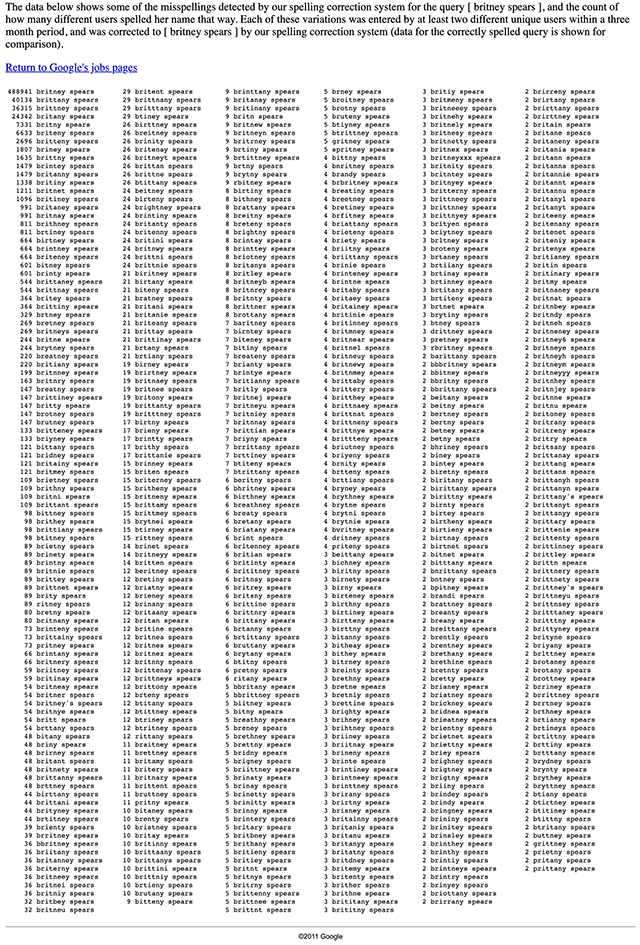
نمونهای از خطاهای کاربران در جستجوی نامهای مشهور
Michael Jackson – michael jackson, micheal jackson, michel jackson, mickael jackson, mickal jackson, michael jacson, mihceal jackson, mickeljackson, michel jakson, micheal jaskcon, michal jackson, mical jachson, micahle jackson, machael jackson, muickael jackson, mikael jackson, miechle jackson, mickel jackson, mickeal jackson, michkeal jackson, michele jakson, micheal jaskson, micheal jasckson, micheal jakson, micheal jackston, micheal jackson, michal jakson, michaeljackson, michael joseph jackson, michael jayston, michael jakson, michael jackson mania!, michael jackaon, micael jackson, machel jackson, jichael mackson
جزییات فنی ارائه شده در بخش ۲ و ۳ کمی از موضوع اصلی دور بود برای یادآوری دوباره، خلاصهای از آنچه گفته شد:
غلطیابی مستقل از زبان هدف، ۲ بخش اساسی دارد، تشخیص خطا و ارائه پیشنهادهای اصلاحی. برای بخش تشخیص اشتباه، از مقایسه با لغتنامه و مقایسه تریگرامهای واژگان شناخته شده استفاده میشود. برای حدس زدن واژه صحیح هم از الگوریتمهایی مانند فاصله لونشتاین واژگان با یکدیگر استفاده میشود.
در قسمت ۲ از نرمافزار مشهور غلطیاب ویراستیار یاد شد. با ۲ نفر از عزیزان نویسنده نرمافزار ویراستیار، جناب آقای امید کاشفی و کامیار کنعانی، مدت کوتاهی (مستقل از پروژه ویراستیار) همکار بودهام. امیداورم فرصتی باشد تا نرمافزار ارزشمند ویراستیار را بررسی کنیم تا ببینم در تهیه این نرمافزار از چه روشها و الگوریتمهایی استفاده شده است. در نرمافزار ویراستیار به خطاهای ناشی از حروف مجاور در چینش صفحهکلید QWERTY فارسی توجه شده است.
مثلا برای بخش تشخیص، ویراستیار از تریگرامها استفاده کرده است. البته جستجوی ریشه واژگان هم انجام میشود که بعدتر درباره آن صحبت خواهیم کرد. برای بخش ارائه پیشنهاد، الگوریتم Needleman-Wunsch نیدلمن-وانچ نیز استفاده شده است. در مورد فاصله لونشتاین، آقای امید کاشفی به عملیاتهای ۴ گانه، درج، حذف، جایگزینی و جابجایی ضرایب متفاوت داده است. این کار باعث تغییر در نتایج الگوریتم فاصله لونشتاین میشود.
ضرایب کاشفی در نرمافزار ویراستیار برای محاسبه فاصله واژگان از یکدیگر
درج یا فشار دادن تصادفی دکمه در صفحه کلید، ضریب ۰.۶۷۹
حذف یا فراموش کردن حرف، ضریب ۰.۵۶۹
جایگزینی که حاصل فشار دادن کلیدهای مجاور در صفحه کلید است ضریب ۰.۳۶۷
جابجایی یا ترانسپوز که حاصل لغزش انگشتان بر روی صفحه کلید است، ضریب ۰.۷۲۵
انگلیسی امروزین، اگر چه از نظر صرف یا ساختواژگی سادهتر از بسیاری از زبانهای جهان است، اما رسمالخط آن بهطرز دردآوری غیرقابل پیشبینی است. سیر تاریخی این زبان و جدایی آن از ریشه مشترک با زبان آلمانی در سدههای پیشین، وامگیری گسترده از لاتین، فرانسوی و زبانهای ژرمنی، باعث شده تا رسمالخط آن پیچیده و اغلب ناسازگار میان صداها و حروف شود. این ویژگی چالش اصلی برای غلطیابی انگلیسی را رقم میزند: مشکل کمتر به شناسایی صورتهای نادرست واژگان مربوط است و بیشتر به رفع ابهام میان صورتهای درست اما در بافت نادرست مربوط میشود. بنابراین، مشکل غلطیابی در زبان انگلیسی اساساً ماهیتی معنایی دارد.
درباره خطای واژه واقعی، خطایی که حاصل آن کلمه نادرست نیست بلکه یک واژه صحیح دیگر است (مانند رام به جای راز) صحبت کردیم. بزرگترین علت دشواری غلطیابی انگلیسی، رواج و شیوع خطاهای واژگان واقعی است که از چند ویژگی زبانی ناشی میشود:
همآوایی یا هوموفونی (Homophone): زبان انگلیسی سرشار از همآواهاست، واژگانی که تلفظ یکسان دارند اما املا و معناهای متفاوتی دارند. جفتهایی مانند your/you're، to/too/two، its/it's و affect/effect همواره منبع خطا برای نویسندگان هستند. از آنجا که هر واژه در یک مجموعه همآوا یک مدخل معتبر در واژهنامه دارد، غلطیابی املایی که زمینه یا بافتار را در نظر نگیرد، نمیتواند این خطاها را شناسایی کند. خطا در جمله «Your right» تنها زمانی قابل تشخیص است که درک شود «You're» (شکل کوتاهشده you are) از نظر دستوری در این بافت و بستر لازم است.
بیقاعدگیهای رسمالخطی: املای انگلیسی بر مجموعهای از قواعدی استوار است که بهطرز مشهوری پر از استثنا هستند. نمونهها بسیارند، قاعده «i قبل از e، مگر پس از c، یا زمانی که صدای a بدهد، مانند neighbor و weigh» سوای پیچیدگی، استثناهای خاص خود را دارد (weird، seize). به همین ترتیب، قواعد مربوط به ساخت جمع (برای نمونه، واژههایی که به -o ختم میشوند ممکن است -s یا -es بگیرند: pianos در برابر potatoes) و افزودن پسوندها میتواند گیجکننده باشد و به خطاهای مکرر بینجامد، خطاهایی که ممکن است به واژههای نادرست یا حتی غیرواژه منجر شوند.
تنوع منطقهای املای واژگان: شیوههای نوشتن متفاوت، بهویژه میان انگلیسی بریتانیایی و آمریکایی، لایه دیگری از پیچیدگی میسازد. واژگانی مانند colour/color، honour/honor، centre/center و افعالی که به ise/ize ختم میشوند، نیازمند آن هستند که غلطیاب یا از چند واژهنامه پشتیبانی کند یا یکدستی را درون یک متن اعمال نماید. نرمافزاری که «colour» را در متن خطا در نظر بگیرد، برای کاربر بریتانیایی، نرمافزاری مشکلدار است.
مجموع این عوامل نشان میدهد که در زبان انگلیسی، دشوارترین و رایجترین خطاها، تنها نوشتنهای اشتباهی که به واژههای بیمعنا منجر میشوند نیستند، بلکه خطاهای ظریفیاند که واژهای متفاوت اما به همان اندازه معتبر در انگلیسی پدید میآورند. چالش نه در واژگان، بلکه در معناشناسی و فهم دستور زبان نهفته است.
حالا برای رفع ابهام در این موارد چه باید کرد؟ چگونه متوجه شویم you're book نادرست است و چگونه متوجه شویم عبارت درست your book است؟

