
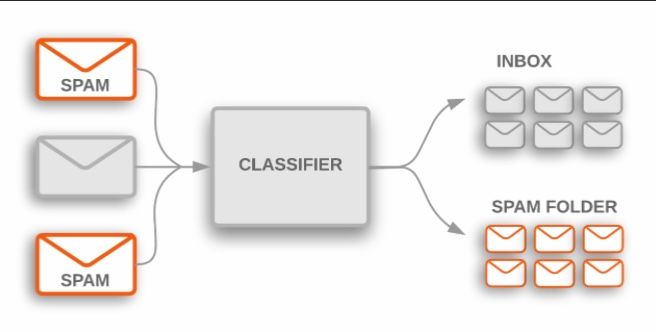
من در این دوره قصد دارم به طور خلاصه راجب یادگیری ماشین توضیح بدهم . در یونان باستان عقیده داشتن که میتوان در یک بدنه فلزی مغز ساختگی قرار داد و یکی از اسطوره های یونان یک غول آهنی بود که مغز مکانیکی داشت البته یونانیان دست به کار شده بودند در آثار به جا مانده از آنان قطعات مکانیکی پیچیده ای کشف شده بود . آلن تورینگ یکی از تاثیرگذارترین افراد در حوزه هوش مصنوعی است او تست تورینگ را پیشنهاد داد که معیاری برای تشخیص هوشمندی ماشین است. هوشمندی را میتوان با اشکال مختلف تعریف کرد از منظر اول هوشمندی یا در رفتار است یا در تفکر و از منظر دوم هوشمندی در انسان گونه بودن یا در منطقی فکر کردن است که در کل به چهار تعریف میرسیم . هوش مصنوعی چیزی است که : ۱)منطقی فکر کند ۲)منطقی رفتار کند ۳)مانند انسان فکر کند ۴)مانند انسان عمل کند . یادگیری ماشین بعد از هوش مصنوعی موضوعیت پیدا کرد و آن را میتوان زیر مجموعه هوش مصنوعی در نظر گرفت. مهم ترین ویژگی یادگیری ماشین ، یادگیری با استفاده از داده و بدون استفاده از دستورات مستقیم است. ویژگی دیگر یادگیری ماشین تغییر خود با دیدن داده ها است یعنی مانند انسان با کسب تجربه رفتار خود را تغییر دهد . حال که با هوش مصنوعی و شاخه های آن آشنا شدیم به بررسی کاربرد ها و مشاغل این حوزه میپردازیم . قدرت الگوریتم های یادگیری ماشین امکانات بسیاری را به جامعه عرضه کرده و حوزه های بسیاری به آن وابسته شدند . صنعت ، تجارت ، دانشگاه ، سلامت ، اقتصاد و … از یادگیری ماشین برای پیشبرد اهداف خود استفاده میکنند . اولین کاربرد آن در تشخیص ایمیل های Spam بود .
امروزه ماشین های بدون راننده در سطح شهرها در حال حرکت هستند ، اقتصاددانان برای پیش بینی روند بازار از آن استفاده میکنند . به همین دلیل استفاده الگوهای داده درتصمیم گیری شرکت ها ، شغل های مرتبط با داده به یکی از جذاب ترین شغل ها حاضر تبدیل شدند . یکی از دلایل این جذابیت توجه ویژه برنامه نویسان و شرکت های برنامه سازی به آن است . زبان Pythonو R محبوب ترین زبان های قابل استفاده برای یادگیری ماشین هستند . با درک اهمیت دانش و اطلاعات ، بسیاری به فکر استفاده از داده های موجود افتادند و سعی کردند در تصمیم گیری ها از نتایج تحلیل داده استفاده کنند مثل ثبت روزانه وزن ، ثبت پیاده روی روزانه ، ثبت مخارج ماهیانه وپیدا کردن روش هایی برای کاهش هزینه ها و بسیاری از گزارش های دیگر که افراد برای مقاصد شخصی خود از این اطلاعات استفاده کنند . احتمالا کلماتی مانند دانشمند داده ، تحلیلگر داده و مهندس یادگیری ماشین به گوشتان خورده حال به معرفی میپردازیم . تحلیل گر داده : داده خام قبل از تبدیل شدن به دانش نیازمند ذخیره سازی مناسب و آماده سازی های میباشد . تحلیلگرداده معماری مناسب برای جمع اوری اطلاعات یک سازمان را طراحی میکند و پایگاه داده مناسب برای این کار را انتخاب میکنند و سپس آماده سازی و انتخاب قالب مناسب ، آنها را پایگاه داده ای که طراحی کرده ذخیره میکند و قدرت تحلیل بالایی دارند داشتن مهارت برنامه نویسی ضروری نمیباشد میتواند از نرم افزارها یا سرویس وب برای انجام امور استفاده کند . دانشمند داده : سطح بالاتری از تحلیلگرداده دارد نیازمند دانش آماری ، ریاضیاتی و برنامه نویسی قوی تری نسبت به تحلیلگر داده است . مهندس داده : کارش با مفاهیم کلان داده یا روند رسیدن داده خام به دست مصرف کنندگان داده میباشد . پس از مشورت با دیگر اعضا شرکت و انتخاب منابع داده ، داده های منابع مختلف را یکپارچه میکنند و برای نگهداری بهینه آن ها برنامه ریزی میکند . مهندس یادگیری : مهندس یادگیری ماشین نقاط مشترک فراوانی با مهندس داده دارد . هر دو فرایند رسیدن داده از محل تولید تا مدل نقش داشته و با ساختار داده و پیچیدگی های مرتبط با آن آشنایی دارد . دانش یادگیری ماشین برای مهندس یادگیری ماشین الزامی است و مسئول رساندن خروجی به کاربر نهایی است . او مدل تولید شده را بررسی و مدل نظری را وارد فرایند عملیاتی میکند . او باید پیچیدگی های محاسباتی و حافظه ای را محاسبه کند و مدل طراحی شده توسط دانشمند داده را برای کار در مقیاس بزرگتر آماده کند . یادگیری ماشین در معدن نیز کاربرد های دارد که شامل : ۱)پردازش تصاویر ماهواره ای : ماهواره های مختلفی برای مقاصد زمین شناسی وجود دارند از این تصاویر برای شناسایی و ترسیم نقشه های زمین شناسی منطقه مورد نظر به دست می آید
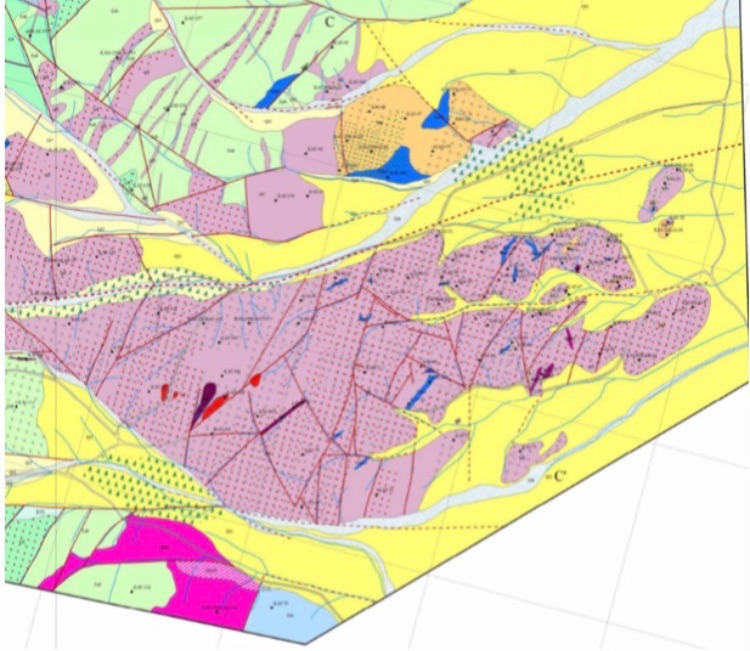
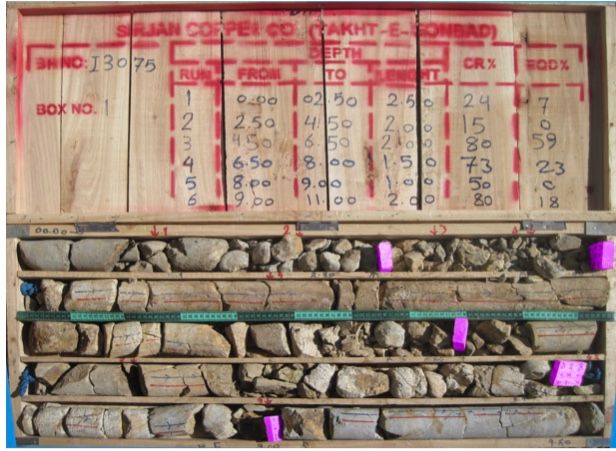
.۲)پیش بینی متغییرهای ژئومتالوژیکی : آمار و احتمال در حوزه کشف معدن کاربرد دارد چون نمونه برداری در معدن هزینه زیادی دارد و از این روش با کمترین داده بیشترین اطلاعات را بدست آورد استفاده از یادگیری ماشین و در این زمینه بسیار کارآمد است. ۳)آنالیز تصاویر مربوط به جعبه مغزه ها : حفاری اکتشافی به چاه هایی گفته میشود که برای برسی های بیشتر در زمین حفر میشوند . این حفاری ها در اندازه های مشخصی انجام شده و مغزه های حاصل از حفاری در جعبه های مشخصی برای تحلیل های بعدی قرار میگیرند .
۴)پردازش تصاویر گرفته شده از پهپاد برای شناسایی هدف های از پیش تعیین شده . در مصاحبه با مهندس هادی ستوده ، دانشمند داده در کوئرا ، ایشان توصیه کردند کسی که میخواهد کار کند خودش علمی راجب موضوع که کار میکند داشته باشد که اگر سیستم اشتباه کرد بفهمد و جلو ضرر را بگیرد . حال میخواهیم روش های یادگیری ماشین و همچنین به معرفی انواع داده نحوه بررسی دقت مدل یادگیری بپردازیم . انواع مختلفی داده داریم که شامل : ۱)تصاویر : عموما به آن بینایی ماشین میگوییم داده ها تصاویر هستند که به صورت اعداد در ماشین ذخیره میشوند و مسائل را حل میکنند مثل تشخیص چهره ، تشخیص پلاک خودرو ۲)کلمات (زبان طبیعی) : امکان برقراری ارتباط میان انسان ها و ماشین ها فراهم میشود که ممکن است به صورت نوشتاری یا صوت باشد کاربرد ها آن شامل : تشخیص گفتار ، دسته بندی نوشتاریا نظرات میباشد ۳)جداول : معادل پایگاه داده در سیستم نرم افزاری هستند . اطلاعات داخل جداول را به الگوریتم یادگیری ماشین میدیم و میخواهیم مسائل را حل کنند که دو نوع داده داریم نوع اول داده های عددی هستند مثل سن و نوع دوم داده ها داده دسته ای مثل جنسیت ۴)سری زمانی : در بعضی داده ها تغییرات آن و در نتیجه مقدار آن در طول زمان اهمیت دارد مانند نوار قلب . مراحل انجام یادگیری ماشین دارای چهار عنصر اساسی است : ۱)الگوریتم برای تصمیم گیری ۲)معیاری برای امتیازدهی اینکه عملکرد مدل چقدر خوب بوده است . ۳)بررسی خودکار کیفیت مدل براساس امتیاز . ۴)روش خودکار برای بهبود امتیاز بر اساس ایجاد تغییرات در مدل . یادگیری ماشین سه نوع که شامل یادگیر بانظارت، یادگیری بی نظارت ، یادگیری تقویتی میباشد . یادگیری با نظارت : الگوریتمی است که با استفاده از داده های دارای برچسب هستند الگو مناسب را پیدا میکند یعنی بتواند خروجی را برای ورودی جدید تخمین بزند و شامل دو دسته میشود : طبقه بندی : (داده ها را تقسیم میکند و دسته درست برای نمونه های جدید انتخاب میکند مانند تشخیص بیماری) - Regression: ( تخمین مقدار یک ویژگی برای نمونه میباشد و خروجی ها پیوسته است مانند تخمین قیمت بازار ) یادگیری بی نظارت : در این روش مدل به تنهایی و بدون کمک برچسب هایی الگو پنهان را پیدا میکند و شامل خوشه بندی و کاهش ابعاد میشود . خوشه بندی یعنی دسته بندی به صورت اتوماتیک داده ها به این صورت که داده های هر خوشه ویژگی یکسانی داشته باشند . کاهش ابعاد یعنی کاهش دادن تعداد ویژگی هایی که از آنها برای آموزش مدل استفاده میکنیم . اندازه ای به مراتب کوچیکتر از ورودی داشته باشد . یادگیری تقویتی : روشی است که با ذهنیت آزمون خطا کار میکند مانند بازی ها.
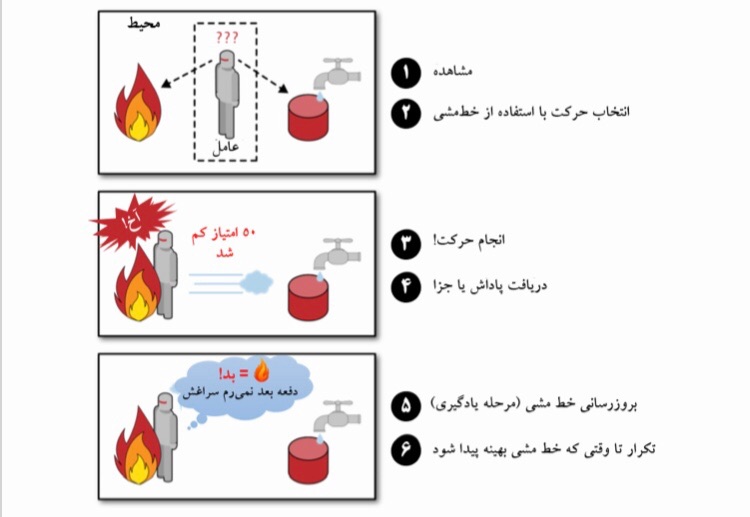
سنجش یادگیری برای آموزش مدل دادگان را استفاده میکند که به دادگانی برای آموزش مدل استفاده میشود دادگان آموزش و به دادگانی که برای ارزیابی استفاده میشوند ، دادگان آزمایش میگویی . در مصاحبه با مهندس هادی یامی ، دانشمند کاربردی در شرکت Microsoft توصیه کردند حوزه یادگیری ماشین کار با داده و هوش مصنوعی به شدت حاد و حادتر خواهد شد و اگر علاقه دارید حتما وارد این حوزه شوید چون هم لذت خواهید برد هم خیلی کار وجود دارد و به شدت حاد و حادتر خواهد شد . Python برای علم داده : Python یک زبان برنامه نویسی است که در اوایل دههی ۹۰ میلادی ، توسط Guido Van Rossum در هلند اختراع شد . از زمان اختراعش تا امروز به عنوان یک زبان برنامه نویسی سطح بالا در توسعهی برنامههای وب و موبایل و همچنین در آنالیز داده و محاسبات علمی به کار رفته است . هدف اصلی از توسعهی این زبان ، اتوماسیون کارهای تکراری ، برای توسعه سریع برنامهها است . Python زبانی به نسبت آسان برای یادگیری است زیرا کدهای آن تمیز و قابل فهم است . بنابراین غافلگیر کننده نیست که بیشتر برنامه نویسها با آن آشنا هستند . که دارای مفسر است نوشتار ساده تری دارد به همین دلیل سریع قابل یادگیری بودن بسیار محبوب شده است . این زبان داری کتابخانه های متنوعی برای کار با داده و انجام عملیات یادگیری ماشین دارد که در اینجا به چند مورد از پرکاربردترین کتابخانه های آن اشاره میکنیم . Numpy: یکی از کتابخانه های پرکاربرد است که داده از منابع مختلف جمع اوری میشود به شکل آرایه ای از اعداد در می آید . Pandas : یکی دیگر از کتابخانه ها است . در پانداس ساختار اصلی داده به صورت Data Form است یعنی در واقع یک آرایه دو بعدی است که در آن سطر و ستون عنوان دارند . Matplotlib: هم یکی دیگر کتابخانه های پایتون است . ساخت نمودارهایی که بتوانند اطلاعات را به خوبی انتقال دهند یکی دیگر از مهم ترین کارها در تحلیل داده است و در ساخت نمودارهای دو بعدی کاربرد دارد و رابط کاربری آن بسیار شبیه Matlab است . Scikit Learn : معروف ترین کتابخانه پایتون میباشد که حاوی ابزار های متنوعی برای یادگیری ماشین و مدل سازی آماری است . یادگیری ماشین به این دلیل مهم است که کارهایی که قبلا تنها توسط انسان ها امکان پذیر بود را با سرعت بیشتر و دقت بیشتر انجام دهد حتی برای حل مشکلات بزرگتر مثل پیش بینی وقایع طبیعی . به دلایل افزایش بی حد و حصرداده ها ، ذخیره سازی مقرون به صرفه داده ها و افزایش قدرت پردازنده ها و کاهش هزینه های آن ها خیلی آسانتر و فراگیر شدند . داده اساس یادگیری ماشین است الگوریتم ها با داده بد عملکرد خوبی ندارند . از جمله چالش ها مربوط به داده تعداد ناکافی داده ها است . یعنی اگر به تعداد کافی داده به الگوریتم تزریق نکنیم نمیتوانیم انتظار عملکرد خوبی داشته باشیم ، داده بی کیفیت یعنی پر از مقادیر اشتباه و گم شده است . و در نهایت انتخاب ویژگی مناسب یعنی ویژگی انتخاب کنیم که مدل بتواند از آن آموزش ببیند و از دل آن الگویی برای پیش بینی آینده استخراج کند . حال که توانستیم چالش های مربوط به داده رو مدیریت کنیم به سراغ چالش های الگوریتمی میرویم که شامل سه چالش میشود . مسئله بیش برازش: مدل نمیتواند آینده را به درستی پیش بینی کند علتش هم این است که داده ها آموزش را زیاد از حد یادگرفته اند . مسئله کم برازش : مدل نمیتواند به خوبی از دادگان آموزش را یاد بگیرد یکی از دلایلش داده نامناسب میباشد داده نامناسب یعنی داده به قدری بی کیفیت است که اطلاعات دقیقی از هدفی که قصد مدل کردن آن داریم نمیدهد . مسئله زمان : زمان از دو جهت اهمیت دارد ؛ هم مدت زمانی که طول میکشد آموزش مدل تمام شود ، هم زمانی که مدل برای پیش بینی نمونه ها مصرف میکند . دانشمند داده سعی میکند هر دو زمان را کمینه کند . در صحبت با مهندس سینا رسولی ، دانشمند و رهبر داده در کافه بازار فهمیدیم که لازم است آمار جبر خطی و یادگیری ماشین آشنا باشیم به طور کلی هر مسیری میروید تلاش کنید و کنار توانایی های مختلف کارهای عملی یاد بگیرید . برای حل مسئله حوزه یادگیری ماشین این گام هایی باید طی شود : ۱)دریافت و بررسی داده ۲)آماده سازی داده ۳)انتخاب و آموزش مدل مناسب ۴)تست و ارزیابی . برای آشنایی بیشتر با نحوه حل سوالات حوزه یادگیری ماشین ، دیتاست بسیار سادهای را مورد بررسی و ارزیابی قرار دادهایم . که به دلیل طولانی بودن برای یادگیری آن به سایت کوئرا مراجعه کنید . مهندس علی بهجتی ، مهندس داده در شرکت Booking در مصاحبه با کوئرا توصیه کردند که زیرساخت های مناسبی برای دیتا در ایران وجود ندارد و شرکت ها در این زمینه جای کار دارند و نیاز اساسی به مهندس داده دارند که پیشرفت زیادی کنند . چرخه تب تکنولوژی : نمودار رشد تکنولوژیهای مختلف را در طی زمان نشان میدهد . بر این اساس هر تکنولوژی ۵ مرحله اصلی را طی میکند . به این صورت که ابتدا معرفی میشود و شروع به مشهور شدن میکند . در این مرحله اغلب شرکتها به استفاده از این فناوری جدید روی میآورند . در مرحله دوم که اوج قله است ، نام آن تکنولوژی در همهجا شنیده شده و با جذب سرمایهگذار ، بسیاری از استارتآپها شروع به معرفی و استفاده از آن میکنند . اما در مرحله سوم محدودیتهای این تکنولوژی شناخته میشود و آهسته از شهرت آن کاسته شده و بسیاری استفاده از آن را کنار میگذارند . در مرحله چهارم ، تنها برخی کسانی که در عرصه آن تکنولوژی باقیماندهاند شروع به فعالیت اصلی در این حوزه کرده و تکنولوژی شروع به رشد میکند تا زمانی که به مرحله پایانی یعنی پختگی و ثبات نسبی برسد . هوش مصنوعی که ما تا حالا مطالعه کردیم هوش مصنوعی محدود است .
. هوش مصنوعی عمومی عبارت است از ساختن عامل هوشمندی که مانند انسان از هوش عمومی برخوردار باشد که توانایی آموختن در مواجه با هر مسئله جدیدی را داشته باشد و محدود به یک زمینه یا مسئله خاص نباشد داری ابعاد متنوع و رشته های مختلفی باشد . مسئله هوش مصنوعی عمومی ابعاد متنوعی دارد و رشتههای مختلفی را حول خود گرد میآورد . بخشی از مسائل آن به فلسفه و به طور دقیقتر فلسفه ذهن برمیگردد . بهترین راهها برای تحقیق درباره هوش مصنوعی عمومی ، مطالعه هوش طبیعی است . هر چه شناخت بیشتری از مغز خودمان و نحوه کارکرد آن پیدا کنیم ، ابعاد بیشتری از مسئله هوش به رویمان باز میشود . از همین روست که یکی از رویکردهای ارزشمند در این زمینه مطالعه رشتههایی مثل علوم اعصاب و روانشناسی است که درباره آن چه در سر انسان میگذرد تحقیق میکنند . تکنیک فناوری : در ادامه تحولات شگفتی که برای هوش مصنوعی پیشبینی میشود ، از نقطهای نام برده میشود که هم با شکوه و هم دلهره برانگیز است و آن نقطه تکینگی فناوری است . زمانی که پیشرفت تکنولوژی به نقطهای غیرقابل کنترل و برگشتناپذیر برسد که تمدن انسانی را تحت تاثیر قرار دهد . از مثالهای چنین پیشرفتی که میتواند شگفت انگیز یا خطرناک باشد ، ادامه دار بودن افزایش قدرت پردازشی و تحقق هوش مصنوعی عمومی است . شرکت های پیشرو در زمینه هوش مصنوعی و یادگیری ماشین ، قدرت پردازش بالا و فراوانی داده از اهمیت زیاد برخوردار است . به معرفی چهار شرکت معروفت این حوزه میپردازیم . شرکت Deep Mind: هدف بلند مدت خود را حل مسئله هوشمندی و ساخت سیستمهای حل مسئله با عمومیت و توانایی بیشتر که از آن به همان هوش مصنوعی عمومی یاد میکند اعلام کرده است . شرکت Open AI : مقر اصلی آن در سانفرانسیسکوی آمریکا قرار دارد و در حال حاضر یکی از شرکتهای پیشروی حوزه هوش مصنوعی است. این شرکت هم هدف خود را ساختن هوش مصنوعی عمومیای میداند که برای بشریت مفید واقع شود . هوش مصنوعی عمومی در تعریف آنها سیستمهای فوق خودکاری هستند که انسانها را در بیشتر کارهای ارزشمند از نظر اقتصادی پشت سر میگذارند . شرکت Facebook AI: یک بخش تحقیقاتی ویژه هوش مصنوعی دارد که از پیشگامان این حوزه به شمار میرود . زمینههای تحقیقاتی این بخش شامل ابعاد مختلف یادگیری ماشین از جمله بینایی ماشین و پردازش زبان طبیعی میشود . شرکت Google AI: شرکت Google هم به پشتوانه منابع پردازشی و دادهای عظیمش گروهی ویژه هوش مصنوعی تاسیس کرده است که به دنبال توسعه هوش مصنوعی و استفاده از آن در محصولات و زمینههای مختلف است . کتابخانه این شرکت همچنان در صنعت بیشترین استفاده را برای پیاده سازی الگوریتمهای یادگیری ماشین دارد . در آخر چند کتاب پیشنهادی در سطح های مختلف برای یادگیری هوش مصنوعی معرفی میکنیم :
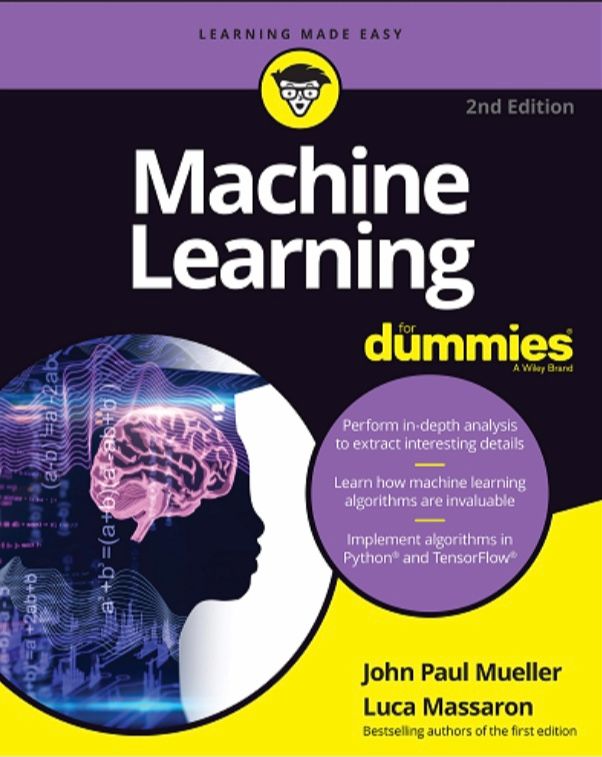
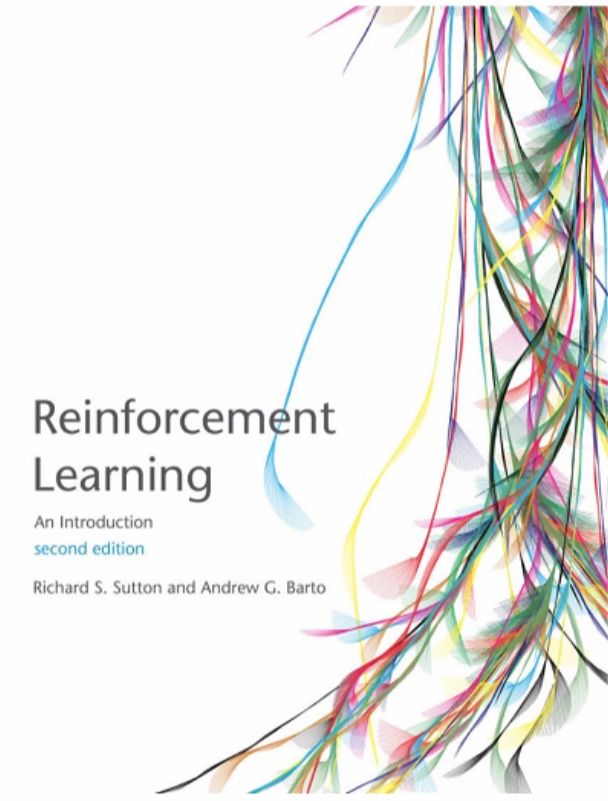
امیدوارم توانسته باشم مفاهیم کلی یادگیری ماشین را در این درسنامه گفته باشم که با مراجعه به سایت کوئرا و گذراندن دوره یادگیری ماشین به طور کلی این مفاهیم را درک خواهید کرد .
https://quera.ir/college/land/college/8522/ منبع

