
در سالهای اخیر، هوش مصنوعی تقریباً همان نقشی را پیدا کرده است که زمانی واژههایی مانند «Agile»، «Cloud»، «Blockchain» و «Microservices» داشتند. یعنی بهمحض آنکه فناوری جدیدی محبوب میشود، وسوسه میشویم آن را برای حل هر مسئلهای به کار ببریم. جملهٔ طنزآمیز زیر نیز همین نگرانی را با اغراق بیان میکند:
اگر صنعت هوانوردی با استانداردهای رایج مهندسی نرمافزار اداره میشد، هیچ هواپیمایی دو بار پشت سر هم سالم فرود نمیآمد.
ابزار، روش و فناوری نباید هدف باشند؛ باید متناسب با هزینهٔ شکست، کیفیت موردنیاز و ماهیت مسئله انتخاب شوند. البته نتیجهٔ درست این نیست که «Agile در سیستمهای حساس ممنوع است». سازمان غذا و داروی آمریکا استانداردی را به رسمیت شناخته که چگونگی استفاده از روشهای Agile در توسعهٔ نرمافزار تجهیزات پزشکی را توضیح میدهد. در هوانوردی نیز FAA استانداردهای سختگیرانهٔ تضمین نرمافزار مانند DO-178C را بهعنوان یکی از روشهای پذیرفتهشده برای اثبات انطباق به رسمیت میشناسد. تفاوت اصلی در این است که در سیستمهای حساس، سرعت توسعه نمیتواند جای تحلیل خطر، مستندسازی، قابلیت ردیابی نیازمندیها، آزمون، بازبینی مستقل و شواهد ایمنی را بگیرد.
بنابراین مسئله نه «Agile یا Waterfall» است و نه «AI یا بدون AI». مسئله این است:
برای این تصمیم خاص، با این سطح از ریسک، کدام ترکیب از انسان، کد، مدل آماری و هوش مصنوعی مناسبتر است؟
یک سیستم خوب الزاماً سیستمی نیست که بیشترین هوش مصنوعی را در خود جای داده باشد. سیستم خوب، سادهترین و کمهزینهترین معماریای است که بتواند نیازمندیها را با سطح قابلقبولی از ایمنی، دقت، سرعت و قابلیت پاسخگویی برآورده کند.
مؤسسه ملی فناوری و استانداردهای آمریکا (NIST) ریسک را ترکیبی از دو عامل در نظر میگیرد:
۱. احتمال وقوع یک خطا یا رویداد نامطلوب؛
۲. بزرگی پیامدهای آن رویداد.
این نگاه بسیار مهم است. ممکن است یک مدل فقط در یکدهم درصد موارد خطا کند، اما اگر همان خطا بتواند باعث مرگ بیمار، انتقال اشتباه پول، افشای اطلاعات محرمانه یا رد ناعادلانهٔ یک متقاضی شود، نمیتوان صرفاً با اعلام «دقت ۹۹٫۹ درصد» آن را ایمن دانست. NIST همچنین تأکید میکند که ریسکهای هوش مصنوعی مولد ممکن است در تمام مراحل طراحی، توسعه، استقرار، بهرهبرداری و بازنشستگی سیستم ظاهر شوند و به نظارت، آزمون پیش از استقرار، ثبت رخدادها و بازبینی انسانی بیشتری نیاز داشته باشند.
تقریباً هر مسئلهٔ نرمافزاری را میتوان با یکی از پنج گزینهٔ زیر یا ترکیبی از آنها حل کرد:
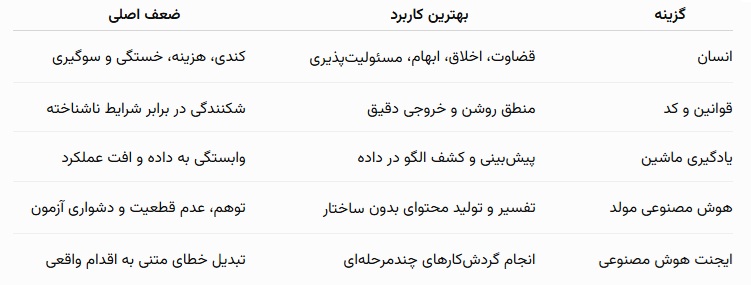
انسان در کارهایی مناسب است که به درک زمینه، تشخیص استثناها، همدلی، ملاحظات اخلاقی و پذیرفتن مسئولیت نیاز دارند.
نمونهها عبارتاند از تصمیم نهایی استخدام، تشخیص یا انتخاب درمان حساس، تفسیر حقوقی، مذاکره، مدیریت بحران و تصمیمهای راهبردی.
اما انسان نیز راهحل بینقصی نیست. انسان خسته میشود، ممکن است اطلاعات را فراموش کند، تحت فشار تصمیم بگیرد یا دچار سوگیری شود. به همین دلیل، «انسان در حلقه» فقط زمانی یک کنترل واقعی است که آن انسان:
تخصص کافی داشته باشد؛
زمان کافی برای بررسی داشته باشد؛
بتواند با پیشنهاد AI مخالفت کند؛
به شواهد مستقل دسترسی داشته باشد؛
مسئولیت و اختیار تصمیم نهایی را واقعاً بر عهده داشته باشد.
قرار دادن یک دکمهٔ «تأیید» مقابل کاربری که روزانه باید هزاران پیشنهاد AI را بررسی کند، نظارت انسانی واقعی نیست؛ بیشتر شبیه امضای ماشینی است.
وقتی منطق مسئله روشن، پایدار و قابلتعریف است، معمولاً کد از AI بهتر است.
برای نمونه:
اگر موجودی حساب کمتر از مبلغ تراکنش بود، پرداخت را رد کن.
یا:
اگر کاربر مجوز Admin ندارد، اجازهٔ حذف اطلاعات را نده.
محاسبهٔ مالیات، جمعزدن اعداد، کنترل دسترسی، اعتبارسنجی شماره کارت، بررسی فرمت ایمیل، اعمال سقف برداشت و تبدیل واحد، معمولاً به مدل زبانی نیاز ندارند.
کد سنتی در این موارد چند مزیت مهم دارد:
خروجی تکرارپذیر است؛
میتوان آن را با آزمونهای دقیق بررسی کرد؛
مسیر تصمیم قابلردیابی است؛
هزینه و تأخیر آن معمولاً کمتر است؛
رفتار آن را میتوان بهروشنی ممیزی کرد.
اگر مسئله با چند شرط روشن و یک ماشین حالت ساده حل میشود، اضافه کردن LLM معمولاً فقط تعداد راههای شکست را افزایش میدهد.
یادگیری ماشین زمانی مناسب است که:
دادهٔ تاریخی کافی وجود داشته باشد؛
هدف قابلاندازهگیری باشد؛
الگوها با قوانین دستی بهسادگی قابلتعریف نباشند؛
خروجی بهصورت احتمال، رتبه یا پیشبینی قابلقبول باشد.
تشخیص تقلب، پیشبینی ریزش مشتری، پیشبینی تقاضا، امتیازدهی ریسک و سیستمهای توصیهگر از کاربردهای متداول آن هستند.
مشکل این است که مدل به دنیایی وابسته است که دادههای آن را دیده است. هنگامی که رفتار کاربران، شرایط اقتصادی، جمعیت بیماران، تجهیزات ثبت داده یا فرآیند کاری تغییر میکند، رابطههای آموختهشده ممکن است دیگر معتبر نباشند.
FDA هشدار میدهد که تغییر جمعیت بیماران، روشهای درمان، زیرساخت، دادههای ورودی یا شرایط واقعی میتواند باعث Data Drift و کاهش دقت، افزایش سوگیری یا کاهش قابلیت اتکای مدلهای پزشکی شود. به همین دلیل، آزمون اولیه برای چنین مدلهایی کافی نیست و عملکرد آنها باید پس از استقرار نیز پایش شود.
مدلهای مولد برای کار با متن، تصویر، صدا، کد و اسناد بدون ساختار بسیار مفیدند. آنها میتوانند:
متن را خلاصه کنند؛
پیشنویس تولید کنند؛
سؤال کاربر را تفسیر کنند؛
اسناد را دستهبندی کنند؛
اطلاعات را به زبان ساده توضیح دهند؛
کد اولیه یا تست پیشنهادی بسازند؛
میان زبانها یا قالبهای مختلف تبدیل انجام دهند.
اما خروجی مدل مولد یک «حقیقت بازیابیشده» یا «نتیجهٔ محاسبهشده» نیست؛ خروجیای احتمالی است که بر اساس الگوهای آموختهشده تولید شده است.
به همین دلیل، یک پاسخ میتواند هم روان، حرفهای و متقاعدکننده باشد و هم اشتباه باشد.
RAG، اتصال به پایگاه داده، جستوجوی وب و ابزارهای دیگر میتوانند خطا را کاهش دهند، اما آن را به صفر نمیرسانند. مدل ممکن است منبع نامناسب را انتخاب کند، متن را اشتباه تفسیر کند، بخشی از پاسخ را بدون پشتوانه بسازد یا از اطلاعات قدیمی استفاده کند.
بنابراین، هوش مصنوعی مولد برای «پیشنهاد دادن» معمولاً مناسبتر از «تعیین حقیقت نهایی» است.
ایجنت یک چتبات معمولی نیست. ایجنت میتواند با ابزارها ارتباط برقرار کند و اقدام انجام دهد؛ برای مثال:
ایمیل ارسال کند
فایل تغییر دهد
یک API را فراخوانی کند
رکوردی را در CRM ثبت کند
سفارش ایجاد کند
کد اجرا کند
جلسهای را در تقویم قرار دهد
تراکنشی را آماده یا اجرا کند
IBM توضیح میدهد که ایجنتهای مبتنی بر LLM میتوانند خروجیهایی مانند SQL یا JSON تولید کنند و از آنها برای فراخوانی ابزارهای خارجی استفاده کنند. همین توانایی، ارزش و در عین حال ریسک ایجنت را چند برابر میکند. IBM همچنین توصیه میکند اقدامهای دارای پیامد زیاد، مانند ارسال انبوه ایمیل یا معاملهٔ مالی، نیازمند تأیید انسان باشند و تأکید میکند که ایجنت سادهتر معمولاً ارزانتر، قابلتوضیحتر و قابلاشکالزداییتر است.
یک چتبات اشتباه ممکن است پاسخ غلطی نشان دهد؛ اما یک ایجنت اشتباه میتواند همان پاسخ غلط را به ایمیل، حذف فایل، خرید، انتقال پول یا تغییر سیستم تبدیل کند.
اگر مسئله با فرمول، شرط، جدول تصمیم یا الگوریتم مشخص حل میشود، استفاده از AI معمولاً انتخاب نامناسبی است.
نمونهٔ نامناسب:
از LLM بخواهیم مبلغ نهایی یک فاکتور را با مالیات، تخفیف و گرد کردن محاسبه کند.
راهحل بهتر:
محاسبه با کد و استفاده از LLM فقط برای توضیح نتیجه به زبان طبیعی.
همین اصل دربارهٔ رمزنگاری، اعتبارسنجی امنیتی، کنترل دسترسی، محاسبهٔ حقوق و دستمزد و اجرای قوانین قراردادی صریح نیز صدق میکند.
در سیستمهای حساس، میانگین دقت کافی نیست. باید بدانیم:
مدل در بدترین حالت چه میکند
شکست آن چگونه کشف میشود
آیا سیستم افزونهٔ مستقل دارد
آیا امکان توقف یا بازگشت وجود دارد
آیا خطا میتواند به چند زیرسیستم سرایت کند
NASA در بررسی خطرهای نرمافزاری مأموریتهای فضایی، مواردی مانند فرمان اشتباه، دادهٔ ناوبری نادرست، خطای زمانبندی، خرابی پیکربندی و شکست مشترک میان سامانههای افزونه را از خطرهای تکرارشونده معرفی کرده است. نکتهٔ مهم این است که حتی احتمال پایین نیز در کنار پیامد فاجعهبار قابلچشمپوشی نیست.
در چنین محیطهایی AI میتواند نقش کمکی داشته باشد، اما سپردن تصمیم نهایی یا کنترل مستقیم بدون معماری ایمنی مستقل، معمولاً قابلدفاع نیست.
پیش از ساخت مدل باید بتوانیم بگوییم موفقیت چیست. برای مثال، جملهٔ «بهترین متقاضی را پیدا کن» تعریف کافی نیست. بهترین از چه نظر؟
عملکرد شغلی؟
ماندگاری؟
تطابق فرهنگی؟
سرعت استخدام؟
رضایت مدیر؟
کاهش هزینه؟
تنوع نیروی انسانی؟
اگر هدف مبهم باشد، مدل ناخواسته از جانشینهای ناقص استفاده میکند. ممکن است «شبیه کارکنان موفق گذشته بودن» را بهعنوان معیار موفقیت یاد بگیرد و تبعیض تاریخی را بازتولید کند.
مدل ضعیف را نمیتوان با Prompt Engineering نجات داد. اگر دادهها ناقص، قدیمی، جانبدارانه، اشتباه برچسبخورده یا مربوط به جمعیتی متفاوت باشند، مدل نیز همان محدودیتها را خواهد داشت.
در چنین شرایطی، انتخاب درست ممکن است یکی از اینها باشد:
فعلاً AI نسازیم
ابتدا فرآیند جمعآوری داده را اصلاح کنیم
دامنهٔ کاربرد را محدود کنیم
خروجی مدل را صرفاً بهعنوان سرنخ در اختیار متخصص بگذاریم
مدل AI محصولی نیست که یکبار ساخته و فراموش شود.
اگر سازمان نمیتواند موارد زیر را فراهم کند، احتمالاً هنوز برای استقرار آماده نیست:
ثبت ورودیها، خروجیها و نسخهٔ مدل
پایش دقت و خطا در محیط واقعی
شناسایی Drift
گزارش رخداد و Near Miss
امکان Rollback
فرآیند بهروزرسانی کنترلشده
مسئول مشخص برای عملکرد سیستم
مؤسسه ملی فناوری و استانداردهای آمریکا در سال ۲۰۲۶ نیز تأکید کرده است که ارزیابی پیش از استقرار در محیط کنترلشده، جای پایش پس از استقرار را نمیگیرد؛ زیرا شرایط ورودی، رفتار کاربران و خروجیهای غیرمنتظره میتوانند در محیط واقعی تغییر کنند.
تصمیمهایی مانند استخدام، اخراج، اعتباردهی، بیمه، پذیرش دانشگاه، خدمات عمومی، آزادی، درمان و مهاجرت فقط مسائل فنی نیستند. سیستم باید بتواند پاسخ دهد:
چرا این تصمیم گرفته شد؟
چه دادهای استفاده شد؟
چه کسی مسئول است؟
شخص آسیبدیده چگونه اعتراض میکند؟
آیا تصمیم توسط انسان قابلاصلاح است؟
آیا عملکرد برای گروههای مختلف ارزیابی شده است؟
اتحادیهٔ اروپا بعضی کاربردهای AI را بهدلیل تهدید حقوق بنیادین ممنوع و برخی دیگر، مانند AI در استخدام، آموزش، اعتباردهی، زیرساخت حیاتی و جراحی رباتیک را پرخطر طبقهبندی کرده است. نمونههای ممنوع شاملSocial Scoring، برخی انواع تشخیص احساسات در محل کار یا مراکز آموزشی و بعضی شکلهای پیشبینی جرم صرفاً بر اساس پروفایل شخصیتی است.
قانونگذار در واقع همان اصل مهندسی را بیان میکند: هرچه پیامد تصمیم بیشتر باشد، شواهد، کنترل و پاسخگویی بیشتری لازم است.
اگر کاربر یا سازمان هیچ راه مستقلی برای تشخیص پاسخ درست از غلط ندارد، استفاده از AI خطرناکتر میشود. هوش مصنوعی برای تهیهٔ پیشنویس در حوزهای که متخصص میتواند آن را بررسی کند مفید است. اما استفاده از آن بهعنوان «متخصص جایگزین» توسط کسی که توانایی ارزیابی پاسخ را ندارد، ریسک بیشتری دارد.
قاعدهٔ مفید این است:
AI را بیشتر در کارهایی به کار ببرید که خطایشان قابلتشخیص است، نه صرفاً کارهایی که تولید خروجی در آنها آسان است.
نباید اطلاعات پزشکی، اسرار تجاری، قراردادهای محرمانه، رمزها، دادههای هویتی یا کد اختصاصی را صرفاً به این دلیل که یک ابزار رابط کاربری جذابی دارد، در آن وارد کرد. پیش از استفاده باید مشخص باشد:
داده کجا ذخیره میشود؟
آیا برای آموزش استفاده میشود؟
چه مدت نگهداری میشود؟
چه اشخاص یا شرکتهایی به آن دسترسی دارند؟
آیا امکان حذف داده وجود دارد؟
آیا انتقال داده با قراردادها و قوانین سازگار است؟
اگر پاسخ این پرسشها مشخص نیست، گزینهٔ درست ممکن است استفاده نکردن، ناشناسسازی داده یا استفاده از زیرساخت سازمانی کنترلشده باشد.
به ایجنت نباید بیش از حد لازم مجوز داد.
ایجنتی که فقط پیشنویس ایمیل تولید میکند، ریسک محدودی دارد. ایجنتی که بتواند ایمیل را ارسال کند، فایلها را حذف کند، اطلاعات مشتری را تغییر دهد و تراکنش مالی انجام دهد، سطح کاملاً متفاوتی از ریسک دارد.
مؤسسه ملی فناوری و استانداردهای آمریکا NIST هشدار داده است که بسیاری از ایجنتها در برابر Agent Hijacking یا تزریق غیرمستقیم دستور آسیبپذیرند. در این حمله، مهاجم دستوری را داخل یک ایمیل، سند یا وبسایت قرار میدهد و ایجنت آن را بهجای داده، بهعنوان دستور اجرا میکند. بنابراین برای ایجنتها باید از این کنترلها استفاده شود:
اصل کمترین سطح دسترسی
جداسازی محیط اجرا
محدودیت مبلغ، تعداد و دامنهٔ اقدام
تأیید انسانی برای عملیات مهم
Allow list ابزارها و مقصدها
ثبت کامل فعالیتها
امکان توقف اضطراری
غیرقابلاعتماد فرض کردن متن ایمیل، وب و اسناد
بعضی پروژهها نه به دلیل نیاز واقعی، بلکه به دلیل فشار مدیریتی برای «داشتن AI» شروع میشوند. نشانههای این وضعیت عبارتاند از:
مسئله هنوز دقیق تعریف نشده است
معیار موفقیت وجود ندارد
روش سادهتر مقایسه نشده است
هزینهٔ نگهداری محاسبه نشده است
تیم نمیداند با خطا چه کند
تنها استدلال پروژه این است که رقبا نیز AI دارند
در این حالت بهتر است ابتدا یک Baseline ساده ساخته شود. اگر چند قانون، جستوجوی متنی یا فرم بهتر همان نتیجه را میدهد، AI ضرورت ندارد.
چتبات Air Canada اطلاعات نادرستی دربارهٔ تخفیف سفر در زمان فوت بستگان به یک مسافر داد. شرکت استدلال کرد که نباید مسئول اطلاعات ارائهشده توسط چتبات باشد.
دادگاه این استدلال را نپذیرفت و اعلام کرد چتبات بخشی از وبسایت و نمایندهٔ شرکت است؛ مشتری نیز نباید مجبور باشد بفهمد کدام قسمت وبسایت معتبر و کدام قسمت اشتباه است.
درس: AI مسئول حقوقی مستقلی نیست. مالک سیستم مسئول خروجی آن است. پاسخ تولیدشده دربارهٔ قیمت، بازپرداخت، ضمانت، قرارداد و سیاست سازمانی باید به منبع معتبر متصل و تحت کنترل باشد.
به گزارش رویترز Amazon یک سیستم آزمایشی برای امتیازدهی رزومهها ساخته بود. مدل از رزومههای تاریخی یاد گرفته بود و بهدلیل مردانهبودن بخش بزرگی از دادههای گذشته، نسبت به برخی نشانههای مرتبط با زنان امتیاز منفی ایجاد میکرد. شرکت در نهایت این ابزار را کنار گذاشت.
درس: مدل نه عدالت را میفهمد و نه هدف واقعی سازمان را؛ فقط الگوهای موجود در داده و معیار تعریفشده را دنبال میکند. «یادگیری از تصمیمهای گذشته» میتواند به معنی «خودکار کردن سوگیریهای گذشته» باشد.
Zillow اعلام کرد پیشبینی قیمت خانهها بسیار غیرقابلپیشبینیتر از انتظار شرکت بوده و ادامهٔ مقیاسدهی Zillow Offers نوسان بیشازحدی در سود و ترازنامه ایجاد میکرد. این شرکت فعالیت را متوقف کرد، حدود ۲۵ درصد نیروی کار مرتبط را کاهش داد و در سهماههٔ سوم ۲۰۲۱ حدود ۳۰۴ میلیون دلار کاهش ارزش موجودی ثبت کرد.
درس: مدل ممکن است در یک داشبورد «نسبتاً دقیق» به نظر برسد، اما هنگامی که خروجی آن مستقیماً تعیین کند شرکت چه تعداد خانه و با چه قیمتی بخرد، خطای کوچک در مقیاس بزرگ به زیان هنگفت تبدیل میشود.
در چندین پرونده، متن تولیدشده توسط AI شامل پروندهها یا استنادهای حقوقی غیرواقعی بوده است. در یک دستور قضایی سال ۲۰۲۶، دادگاه تصریح کرد که استفاده از محتوای AI که استنادهای خیالی ایجاد کرده، قواعد دادرسی را نقض کرده است.
درس: AI میتواند در تهیهٔ پیشنویس یا یافتن کلیدواژه کمک کند، اما هر استناد، نقلقول، عدد و ادعای حقوقی باید از منبع اصلی بررسی شود.
پاسخ دقیق این است:
Agile بهخودیخود مشکل نیست؛ Agile بدون مهندسی ایمنی مشکل است.
در یک اپلیکیشن معمولی، تیم ممکن است ویژگیای را سریع منتشر کند، بازخورد بگیرد و بعداً آن را اصلاح کند. اما در سامانهٔ کنترل پرواز، دستگاه پزشکی یا سیستم اضطراری نمیتوان همان معنا را برای «آزمایش در محیط واقعی» پذیرفت. در سیستمهای حساس، Agile باید درون یک چارچوب سختگیرانه قرار گیرد که شامل موارد زیر باشد:
تحلیل خطر پیش از پیادهسازی
تعریف نیازمندیهای قابلآزمون
ردیابی نیازمندی تا طراحی، کد و تست
بازبینی مستقل
آزمون واحد، یکپارچه، سیستمی و ایمنی
کنترل تغییرات
مستندسازی شواهد
تأیید و اعتبارسنجی مستقل
مدیریت پیکربندی
امکان بازگشت امن
در چنین محیطی میتوان کار را تکرارشونده و افزایشی انجام داد، اما «Definition of Done» فقط پایان کدنویسی نیست؛ اثبات رعایت نیازمندیهای ایمنی نیز بخشی از آن است. پس احتمالاً منظور درست استاد این بوده است:
در جایی که جان انسان یا پیامدهای جدی مطرح است، نمیتوان کیفیت را به چرخهٔ «سریع منتشر کن، خراب شد بعداً درست میکنیم» سپرد.
بسیاری از سیستمهای موفق نه کاملاً انسانیاند، نه کاملاً مبتنی بر قوانین و نه کاملاً هوشمند. آنها هر بخش را به ابزاری میسپارند که برای آن مناسبتر است.
یک سیستم خوب میتواند:
با کد، جمع مبالغ، مالیات و میانگینها را دقیق محاسبه کند
با ML، تراکنشهای غیرعادی یا الگوهای هزینه را شناسایی کند
با LLM، نتایج را به زبان ساده توضیح دهد
تصمیم مالی مهم را به خود کاربر بسپارد
در این معماری، LLM ماشینحساب نیست؛ رابط توضیحدهنده است.
سیستم میتواند:
با قوانین قطعی، علائم اضطراری را فوراً علامتگذاری کند
با ML، احتمال یک بیماری را تخمین بزند
با LLM، سوابق بیمار را خلاصه کند
تصمیم تشخیص و درمان را به پزشک واگذار کند
معماری مناسبتر:
LLM سؤال مشتری را تفسیر کند
RAG بخش مرتبط سیاست رسمی را پیدا کند
Policy Engine تعیین کند چه بازپرداختی مجاز است
کد مبلغ را دقیق محاسبه کند
درخواستهای حساس برای انسان ارسال شوند
ایجنت فقط در محدودهٔ مشخص اقدام کند
AI میتواند کد اولیه تولید کند، اما کیفیت باید با ابزارهای قطعی و انسانی کنترل شود:
Compiler
Type Checker
تستهای خودکار
Static Analysis
Dependency Scanner
Code Review
محدودیت دسترسی به محیط Production
اصل مشترک همهٔ این معماریها چنین است:
AI پیشنهاد میدهد، ابزار قطعی بررسی میکند و انسان عملیات پرخطر را تأیید میکند.
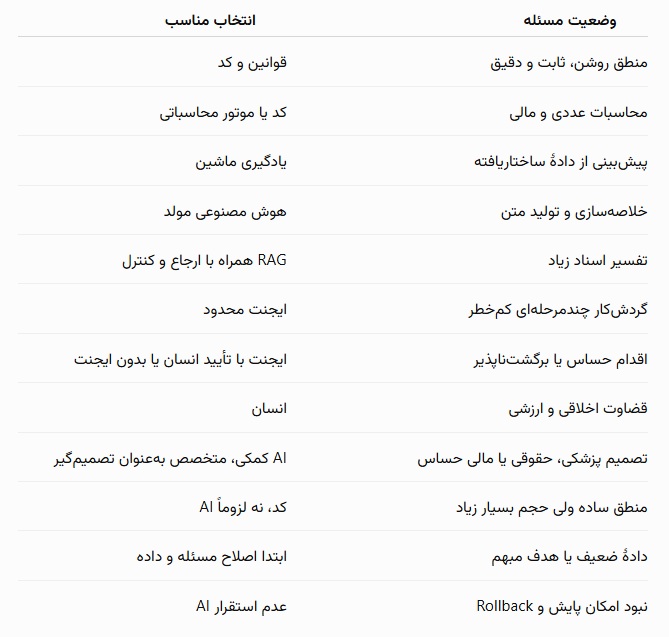
استفاده از AI نباید دوحالتی باشد؛ یعنی فقط میان «نداشتن AI» و «سپردن کامل کار به AI» انتخاب نکنیم.
کار با انسان یا کد قطعی انجام میشود.
مناسب برای محاسبات، کنترل دسترسی و وظایف ساده.
AI پیشنویس، خلاصه یا پیشنهاد ایجاد میکند، اما هیچ تصمیمی نمیگیرد.
نمونه: پیشنویس ایمیل.
AI چند گزینه یا امتیاز ارائه میکند و انسان مستقل تصمیم میگیرد.
نمونه: پیشنهاد اولویت تیکتها.
AI گردشکار را آماده میکند، ولی پیش از اجرا نیازمند تأیید انسان است.
نمونه: آمادهکردن بازپرداخت یا تغییر قرارداد.
ایجنت فقط در محدودهای کمخطر، قابلبازگشت و کاملاً ثبتشده اقدام میکند.
نمونه: تغییر برچسب تیکت یا زمانبندی یک گزارش داخلی.
ایجنت بدون تأیید اقدامهای مهم انجام میدهد. این سطح فقط زمانی قابلبررسی است که محیط محدود، عملکرد بهخوبی آزموده، خطا سریعاً قابلکشف، اقدام قابلبازگشت و پیامد شکست پایین باشد. در بسیاری از کاربردهای حساس، رسیدن به این سطح نه ضروری است و نه منطقی.
دو سؤال بسیار کاربردی بپرسید:
۱. پیامد خطا چقدر شدید است؟
۲. خطا چقدر آسان کشف میشود؟
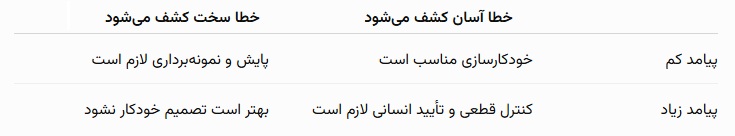
برای مثال، اشتباه AI در انتخاب یک Emoji معمولاً کمخطر و آشکار است. اما یک خلاصهٔ پزشکی که نکتهای حیاتی را حذف کرده باشد، ممکن است هم پرخطر باشد و هم در نگاه اول قابلتشخیص نباشد.
پیش از ساخت یا خرید یک سیستم AI، باید بتوانید به این پرسشها پاسخ دهید:
۱. مسئلهٔ دقیق چیست و معیار موفقیت چگونه اندازهگیری میشود؟
۲. آیا قوانین یا کد سادهتر همین مسئله را حل میکنند؟
۳. هزینهٔ یک پاسخ اشتباه چقدر است؟
۴. خطا پیش از ایجاد خسارت چگونه کشف میشود؟
۵. آیا عملیات قابلبازگشت است؟
۶. چه انسانی مالک نتیجه و مسئول رخدادهاست؟
۷. آیا دادهها نماینده، قانونی و باکیفیتاند؟
۸. آیا عملکرد برای گروهها و شرایط مختلف بررسی شده است؟
۹. آیا ورودی و خروجیها ثبت و قابلممیزی هستند؟
۱۰. آیا Drift و کاهش عملکرد پایش میشود؟
۱۱. آیا کاربر حق اعتراض و اصلاح تصمیم دارد؟
۱۲. آیا دسترسی ایجنت بر اساس اصل کمترین مجوز محدود شده است؟
۱۳. آیا برای عملیات مهم تأیید انسانی وجود دارد؟
۱۴. آیا Kill Switch و Rollback در نظر گرفته شده است؟
۱۵. آیا هزینه، تأخیر و پیچیدگی AI از ارزش واقعی آن کمتر است؟
۱۶. اگر مدل یا سرویس خارجی از دسترس خارج شود، سیستم چه میکند؟
۱۷. آیا پاسخها به منبع معتبر متصلاند؟
۱۸. آیا تیم میتواند سیستم را پس از شش ماه همچنان نگهداری و ارزیابی کند؟
اگر پاسخ چند سؤال مهم «نمیدانیم» باشد، پروژه احتمالاً هنوز آمادهٔ استقرار نیست.
سؤال درست این نیست:
آیا هوش مصنوعی میتواند این کار را انجام دهد؟
مدلها معمولاً میتوانند برای بسیاری از کارها خروجیای تولید کنند. سؤال مهمتر این است:
آیا استفاده از AI در اینجا از گزینههای سادهتر، ارزانتر، قابلاعتمادتر و قابلپاسخگوییتر بهتر است؟
از انسان استفاده کنید، وقتی قضاوت، مسئولیت، اخلاق و درک عمیق زمینه لازم است.
از کد استفاده کنید، وقتی منطق روشن و دقت قطعی اهمیت دارد.
از یادگیری ماشین استفاده کنید، وقتی دادهٔ مناسب و یک مسئلهٔ پیشبینی واقعی دارید.
از هوش مصنوعی مولد استفاده کنید، وقتی تفسیر و تولید محتوای بدون ساختار لازم است و امکان بررسی خروجی وجود دارد.
از ایجنت استفاده کنید، وقتی واقعاً به اقدام چندمرحلهای نیاز دارید و میتوانید مجوزها، ابزارها، دامنه، نظارت و امکان بازگشت را محدود کنید.
و در بیشتر سیستمهای مهم، از ترکیب این ابزارها استفاده کنید.
بهترین معماری معمولاً معماریای نیست که AI همهچیز را انجام دهد. بهترین معماری سیستمی است که در آن:
کد، کارهای قطعی را انجام میدهد؛
مدل، الگوها را پیدا میکند؛
LLM، اطلاعات را تفسیر و توضیح میدهد؛
ایجنت، فقط در محدودهٔ کنترلشده اقدام میکند؛
انسان، مسئولیت تصمیمهای مهم را بر عهده دارد.
در نهایت، مهمترین مهارت در عصر هوش مصنوعی، صرفاً توانایی استفاده از AI نیست؛ بلکه تشخیص این است که کجا باید از آن استفاده کرد، چه میزان اختیار باید به آن داد و چه زمانی بهتر است اصلاً از آن استفاده نکنیم.

