
یک فروشگاه آنلاین بزرگ را تصور کنید؛ در آن جستجو میکنید، سفارش میدهید، با پشتیبانی چت میکنید و در پایین صفحه، پیشنهادهایی با عنوان «شاید این محصولات را هم دوست داشته باشید» میبینید. به نظر شما چند دیتابیس در پشت صحنه این سیستم کار میکنند؟ فقط یکی؟
در اپلیکیشنهای بزرگ معمولاً چندین دیتابیس به صورت همزمان فعالیت میکنند که هرکدام برای هدف مشخصی انتخاب شدهاند. در این مقاله، میخواهیم همین فروشگاه آنلاین را از صفر بسازیم و هر جا که یک دیتابیس کم آورد، دیتابیس بعدی را وارد میدان کنیم. در پایان هم بررسی میکنیم که برای شروع پروژه شخصی خودتان، کدام گزینه بهترین انتخاب است.
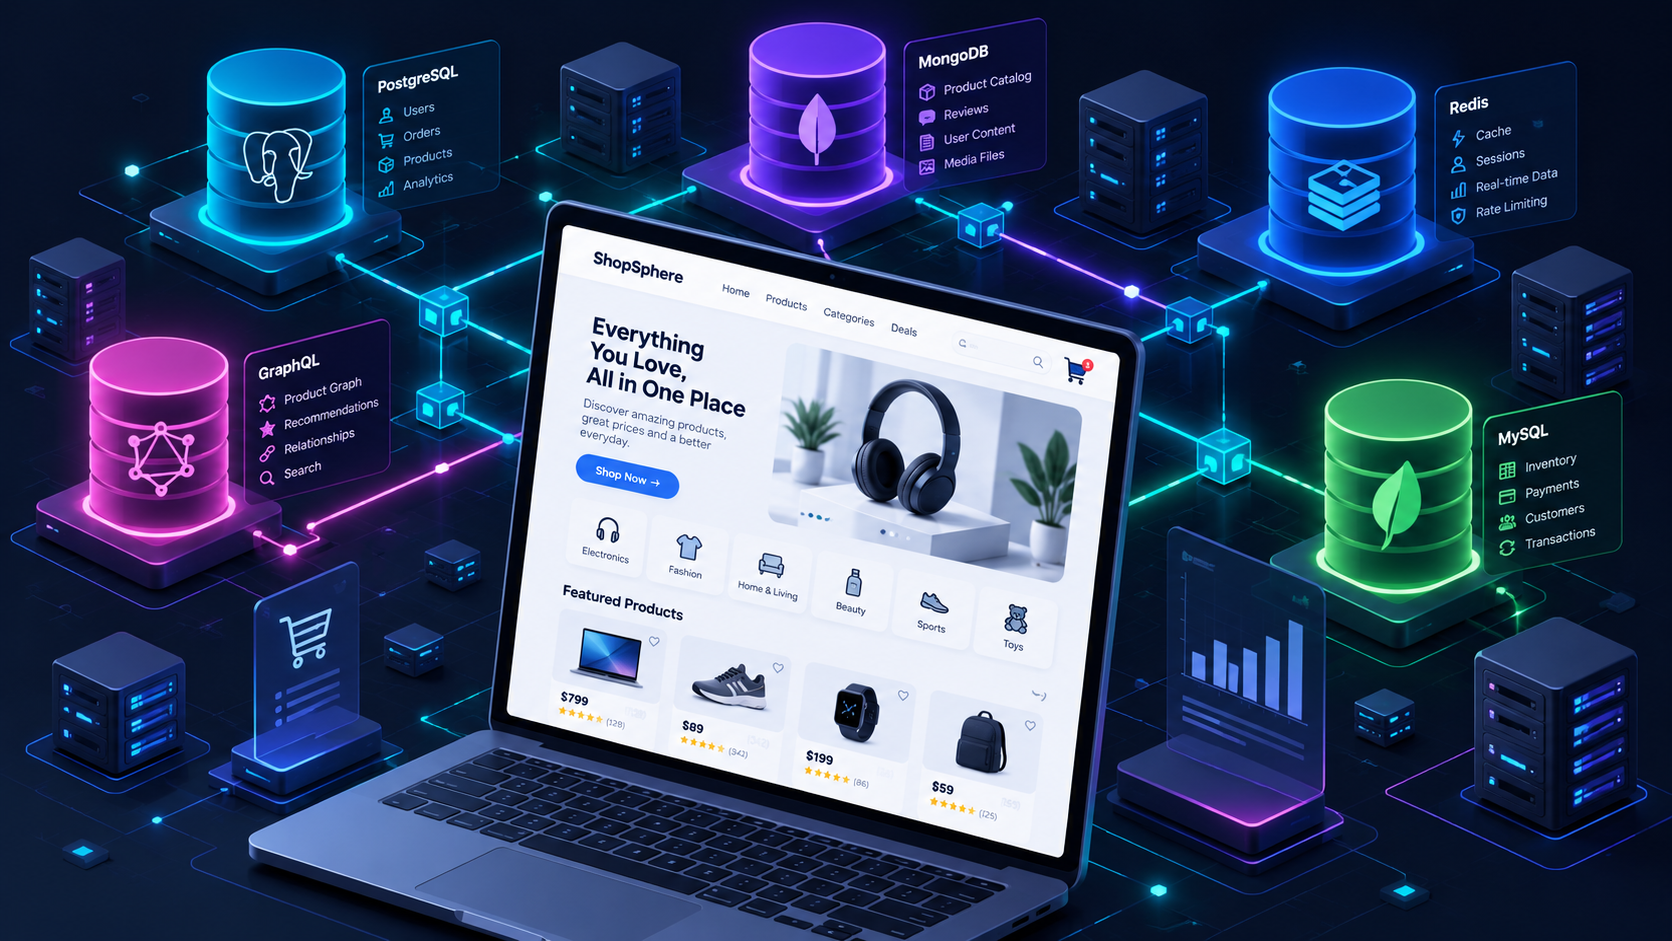
خیلی از ما برنامهنویسی را با MySQL شروع کردیم و تصور میکردیم دیتابیس یعنی همین جدولها (Tables). اما یک روز در یک آگهی شغلی نامهایی مثل Vector DB، Elasticsearch و Redis را میبینید و احساس میکنید یک دنیا از تکنولوژی عقب افتادهاید!
خبر خوب این است که تمام این نامهای پرطمطراق، در اصل فقط چند ایده متفاوت هستند؛ هرکدام برای یک شکل خاص از داده و پاسخ دادن به یک سؤال خاص ساخته شدهاند. اگر درک کنید هر دیتابیس به چه سؤالی سریعتر پاسخ میدهد، این اسامی دیگر ترسناک نخواهند بود.
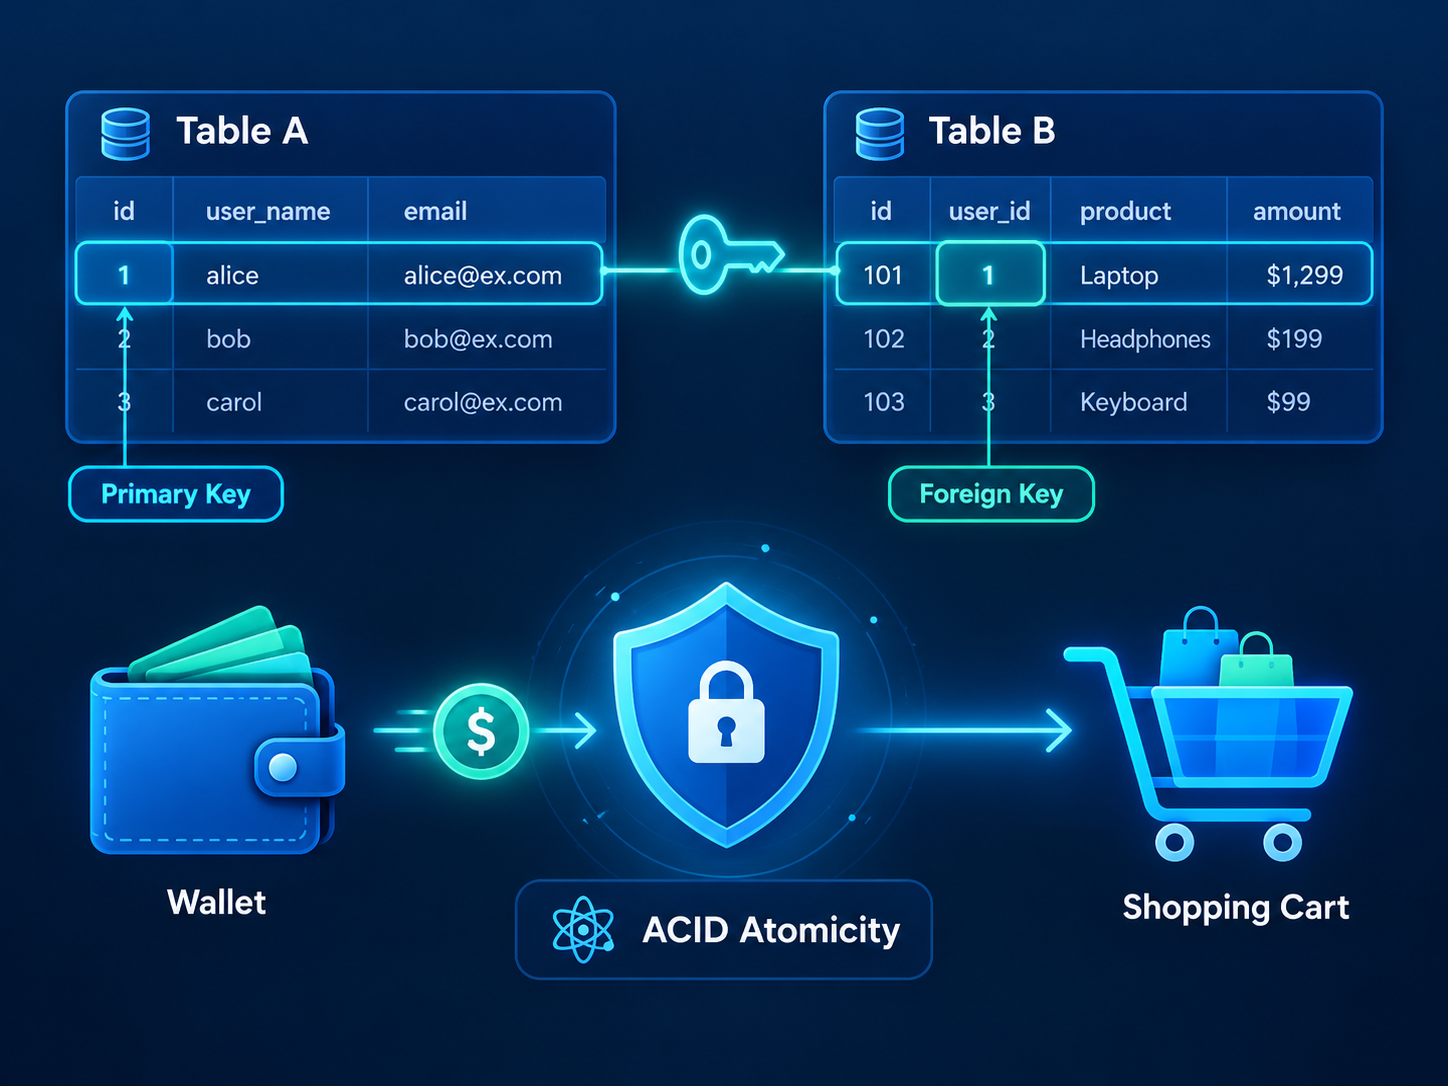
ساخت فروشگاه آنلاین را شروع میکنیم. در گام اول سه موجودیت اصلی داریم: کاربر، محصول و سفارش. این دادهها ساختار ثابتی دارند و به هم مرتبط هستند (هر سفارش متعلق به یک کاربر است و شامل چندین محصول میشود). اینجا دقیقاً جایگاه دیتابیس رابطهای است؛ همان دیتابیسی که با آن به زبان SQL صحبت میکنیم:
دادهها در جدول (Table) ذخیره میشوند.
هر سطر یک رکورد (Record) و هر ستون یک ویژگی (Attribute) است.
جدولها با استفاده از کلیدها (Keys) به هم متصل میشوند و با یک کوئری ساده SQL میتوانید بپرسید: «سفارشهای ماه گذشته علی که مبلغ آنها بالای ۱ میلیون تومان بوده را نمایش بده.»
نکته کلیدی دیتابیسهای رابطهای، مدیریت تراکنشها است. فرض کنید مشتری با موجودی کیف پولش خرید میکند؛ در این لحظه باید دو اتفاق بیفتد:
مبلغ از موجودی کیف پول کم شود.
سفارش در سیستم ثبت گردد.
حالا اگر درست در میانه این دو کار برق برود چه میشود؟ دیتابیس رابطهای تضمین میکند که یا هر دو کار با هم انجام شوند، یا هیچکدام انجام نشوند؛ یعنی امکان ندارد پول کم شود اما سفارش ثبت نشود. به این قانون «همه یا هیچ»، اتمیسیتی (Atomicity) میگویند که حرف A در اصول چهارگانه ACID است. به همین دلیل، اکثر سیستمهای مالی و حسابداری بر پایه دیتابیسهای رابطهای ساخته میشوند.
معروفترینها: MySQL ،PostgreSQL و SQL Server
نقطه ضعف: اگر ساختار دادهها مدام تغییر کند یا حجم داده بهقدری زیاد شود که دیگر روی یک سرور جا نشود، کار با آن دشوار میشود.
حالا میخواهیم محصولات متنوعی به فروشگاه اضافه کنیم:
گوشی موبایل: دارای ویژگیهای حافظه و کیفیت دوربین است.
کفش: دارای ویژگیهای سایز و جنس رویه است.
کتاب: دارای نام نویسنده و تعداد صفحه است.
اگر بخواهید تمام این محصولات را در یک جدول رابطهای بریزید، یا با انبوهی از ستونهای خالی مواجه میشوید، یا هر بار باید ساختار جدول را تغییر دهید.
دیتابیسهای داکیومنتبیس (Document-Based) میگویند اصلاً نیازی به ساخت جدول نیست! در این مدل، هر محصول یک سند (Document) مجزا شبیه به یک فایل JSON است و هر داکیومنت فقط فیلدهای مخصوص به خودش را دارد؛ گوشی فیلدهای خودش را دارد و کفش هم فیلدهای خودش را.
معروفترین: MongoDB
بهترین کاربرد: کاتالوگ محصولات، پروفایل کاربران و هر دادهای که ساختار یکدستی ندارد.
نقطه ضعف: این آزادی عمل هزینه دارد. وقتی دادهها وابستگی زیادی به هم پیدا میکنند (مثلاً گزارشگیری پیچیدهای که چندین نوع داکیومنت را به هم وصل میکند)، کار سختتر از SQL میشود. همچنین بهطور پیشفرض، دیتابیس ساختار داکیومنتها را بررسی نمیکند و منظم نگه داشتن آنها بر عهده خود برنامهنویس است.
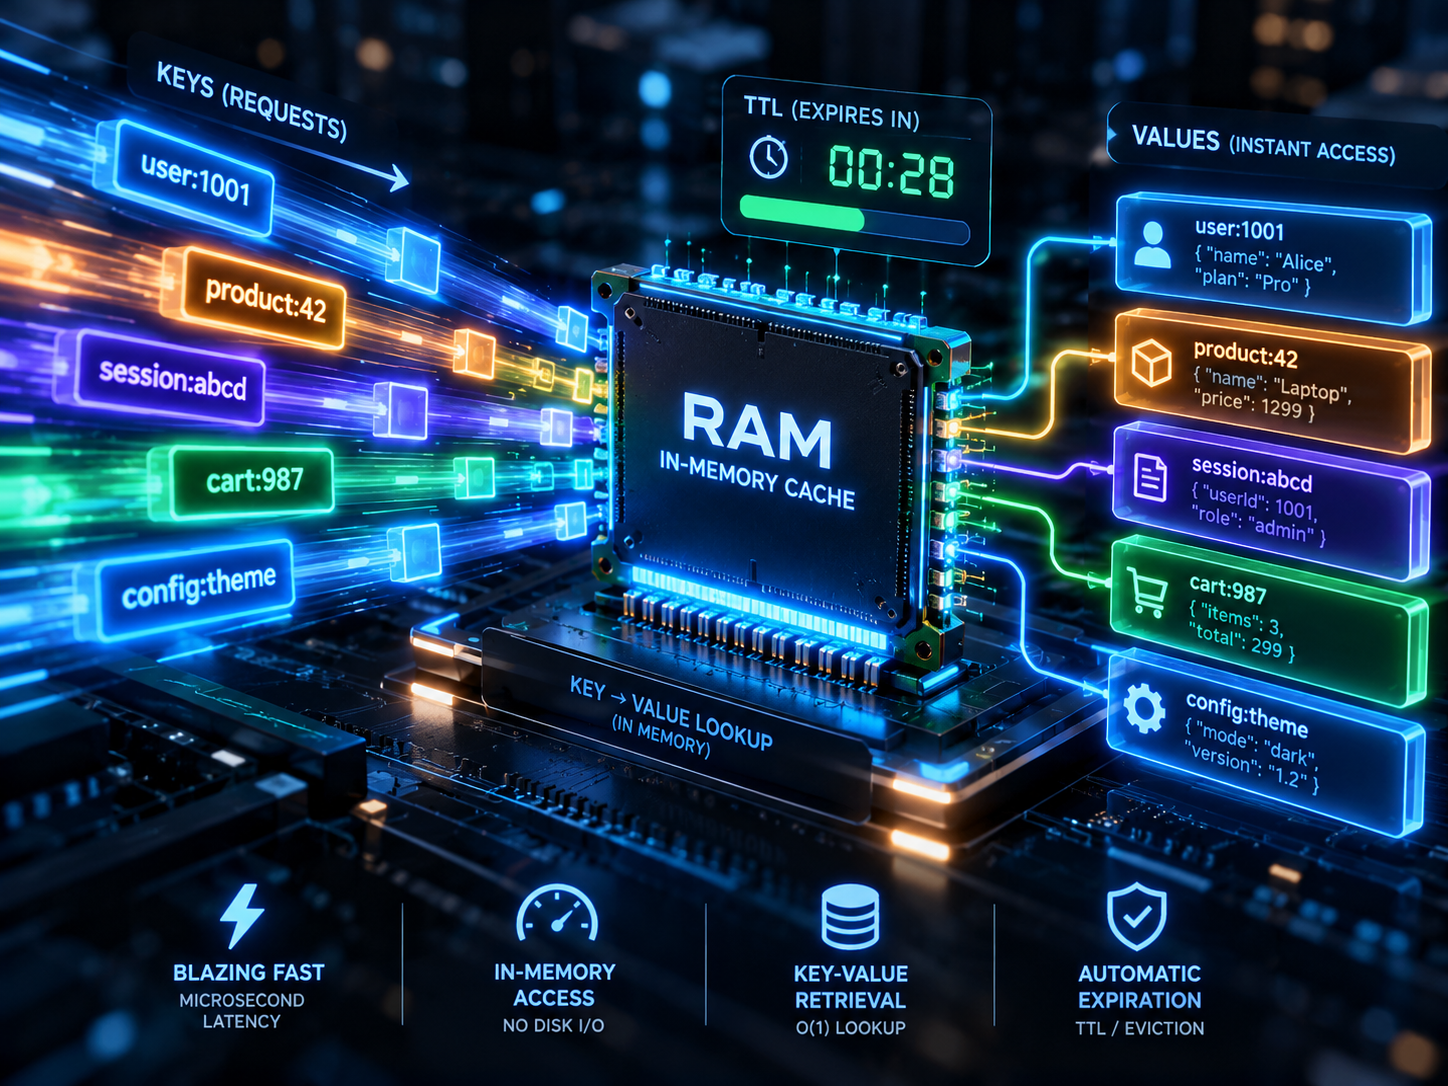
فروشگاه ما معروف شده و در یک حراج بزرگ، هزاران نفر همزمان صفحه اول را باز میکنند. مراجعه به دیتابیس اصلی به ازای هر بازدید، سیستم را بهشدت کند میکند. یا فرض کنید میخواهیم کد تأیید پیامکی (OTP) ارسال کنیم؛ عددی کوتاه که باید دقیقاً ۲ دقیقه بعد باطل شود.
اینجا سادهترین مدل دیتابیس یعنی کی-ولیو (Key-Value) وارد میدان میشود. این دیتابیس در اصل فقط به یک سؤال پاسخ میدهد: «مقدار مربوط به این کلید چیست؟» اما همین یک سؤال را با سرعتی فوقالعاده جواب میدهد، چون مستقیماً با داشتن کلید به سراغ مقدار میرود.
معروفترین دیتابیس این خانواده Redis است که دادهها را در حافظه رم (RAM) نگه میدارد (هرچند میتواند یک نسخه پشتیبان هم روی دیسک ذخیره کند). در این دیتابیس میتوانید تعیین کنید که یک کلید پس از ۲ دقیقه بهطور خودکار پاک شود.
معروفترین: Redis
بهترین کاربرد: کَش کردن (Caching)، مدیریت سشن کاربران (Session)، کدهای تأیید موقت و شمارندهها.
نقطه ضعف: از این دیتابیس نخواهید که مثلاً «تمام کاربران تهرانی بالای ۳۰ سال» را برایتان پیدا کند؛ چون اصلاً برای جستجوهای شرطی و پیچیده ساخته نشده است.
تا اینجا ۳ دیتابیس داریم، اما اپلیکیشن ما هنوز سیستم چت، جستجوی حرفهای و پیشنهاد هوشمند ندارد. حالا میخواهیم سیستم چت پشتیبانی را اضافه کنیم و فرض میکنیم اپلیکیشن آنقدر بزرگ شده که یک سرورِ تنها، کشش نوشتن این حجم از پیامها را ندارد.
پیامهای چت یک ویژگی خاص دارند: تعدادشان بسیار زیاد است، مدام در حال نوشته شدن هستند و تقریباً همیشه به یک شکل خوانده میشوند (نمایش پیامهای آخر یک گفتگو).
دیتابیسهای واید-کالم (Wide-Column) دقیقاً برای چنین باری طراحی شدهاند. آنها دادهها را بین دهها یا صدها سرور پخش میکنند و با اضافه کردن هر سرور جدید، ظرفیت نوشتن افزایش مییابد. شرط استفاده از آنها این است که از همان ابتدا بدانید چه سؤالی قرار است از دیتابیس بپرسید؛ بنابراین دادهها را دقیقاً به همان ترتیبی که قرار است خوانده شوند کنار هم میچینید (مثلاً پیامهای هر گفتگو پشت سر هم و به ترتیب زمان). پلتفرم دیسکورد (Discord) سالها پیامهایش را روی کسندرا نگه میداشت و بعدها به سراغ ScyllaDB رفت که از همین خانواده است.
معروفترینها: Cassandra و ScyllaDB
نقطه ضعف: کوئریهای دلخواه و عملیات Join را در این دیتابیسها تقریباً باید فراموش کنید.
نکته مهم: این دسته را با دیتابیسهای ستونی یا Columnar (مانند ClickHouse) اشتباه نگیرید! نام آنها شبیه است، اما دیتابیسهای Columnar برای گزارشگیری و تحلیل روی حجم بسیار بالای داده ساخته شدهاند.
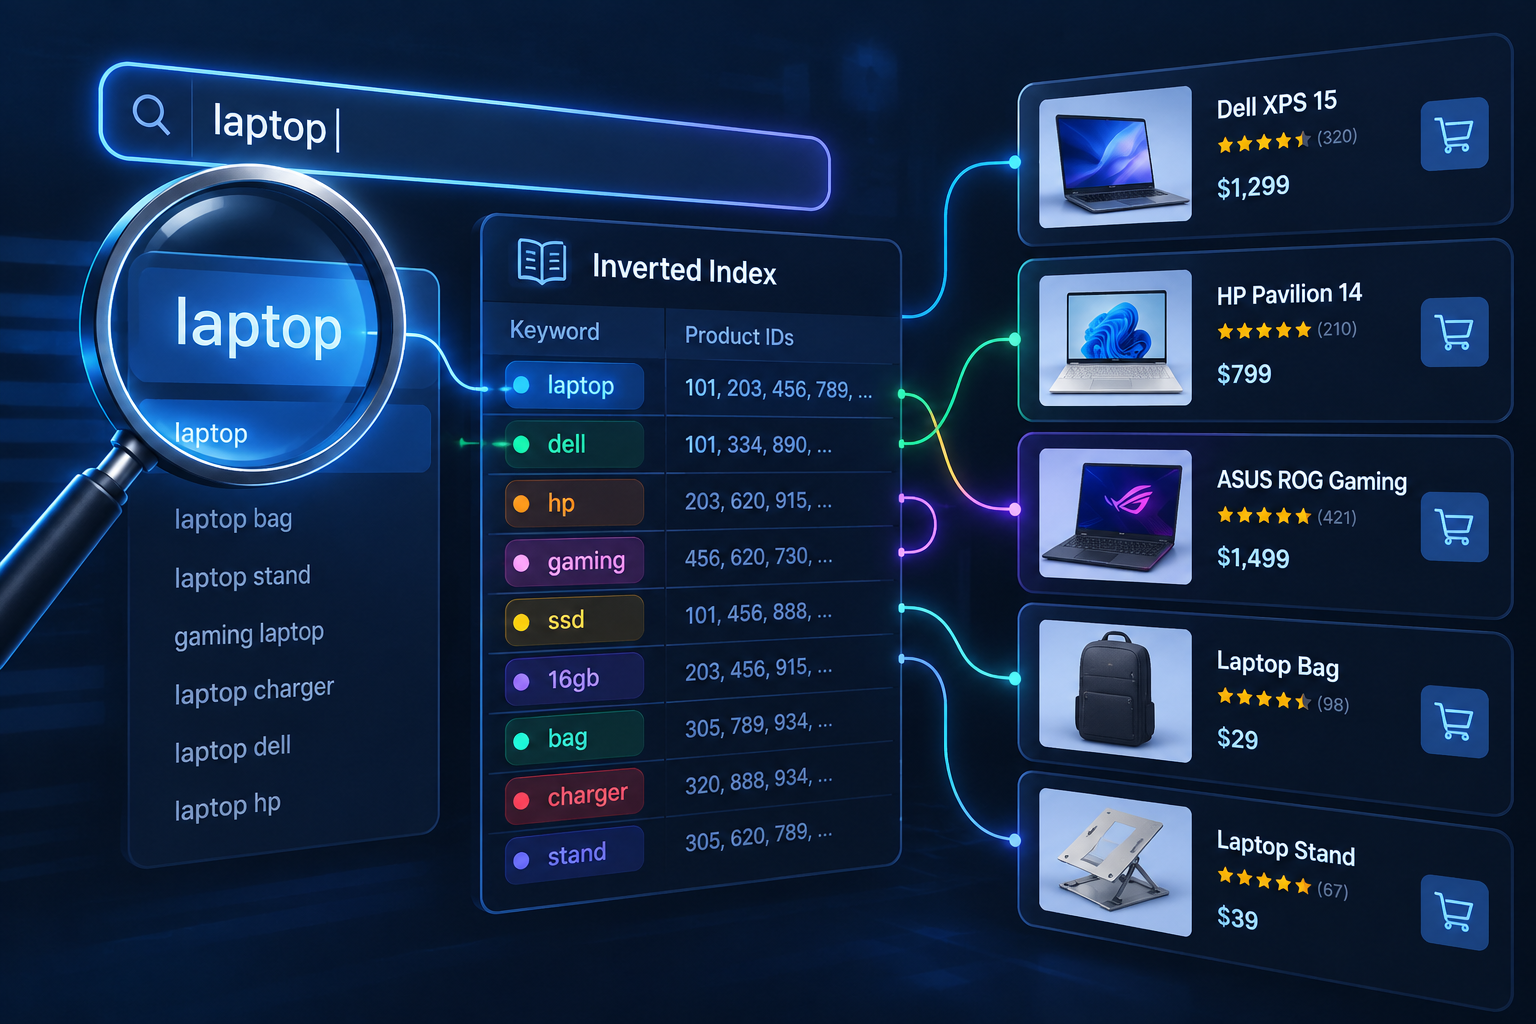
کاربر در بخش جستجوی سایت مینویسد: «گوشی سامسونگ با دوربین خوب» و تازه یک حرف آن را هم اشتباه تایپ میکند! اگر بخواهید با دستور ساده LIKE در SQL به دنبال این عبارت بگردید، فقط محصولاتی پیدا میشوند که دقیقاً همین جمله در آنها وجود داشته باشد و در بین میلیونها محصول، سیستم بهشدت کند خواهد شد.
موتورهای جستجو مثل Elasticsearch برعکس عمل میکنند. آنها به جای اینکه برای هر محصول بنویسند چه کلماتی دارد، یک فهرست میسازند که مشخص میکند هر کلمه در کدام محصولات به کار رفته است؛ درست مانند نمایه یا فهرست آخر کتابها. به این ساختار ایندکس معکوس (Inverted Index) میگویند.
نتیجه این رویکرد، جستجوی متنی فوقالعاده سریع است که قابلیتهای زیر را هم روی همان فهرست در اختیارتان میگذارد:
تحمل غلطهای املایی و تایپی (Fuzzy Search)
رتبهبندی نتایج بر اساس میزان ارتباط
موتورهای جستجو معمولاً به عنوان دیتابیس اصلی استفاده نمیشوند، بلکه یک نسخه کپی از دادهها را مخصوصِ عملیات گشتن نگه میدارند.
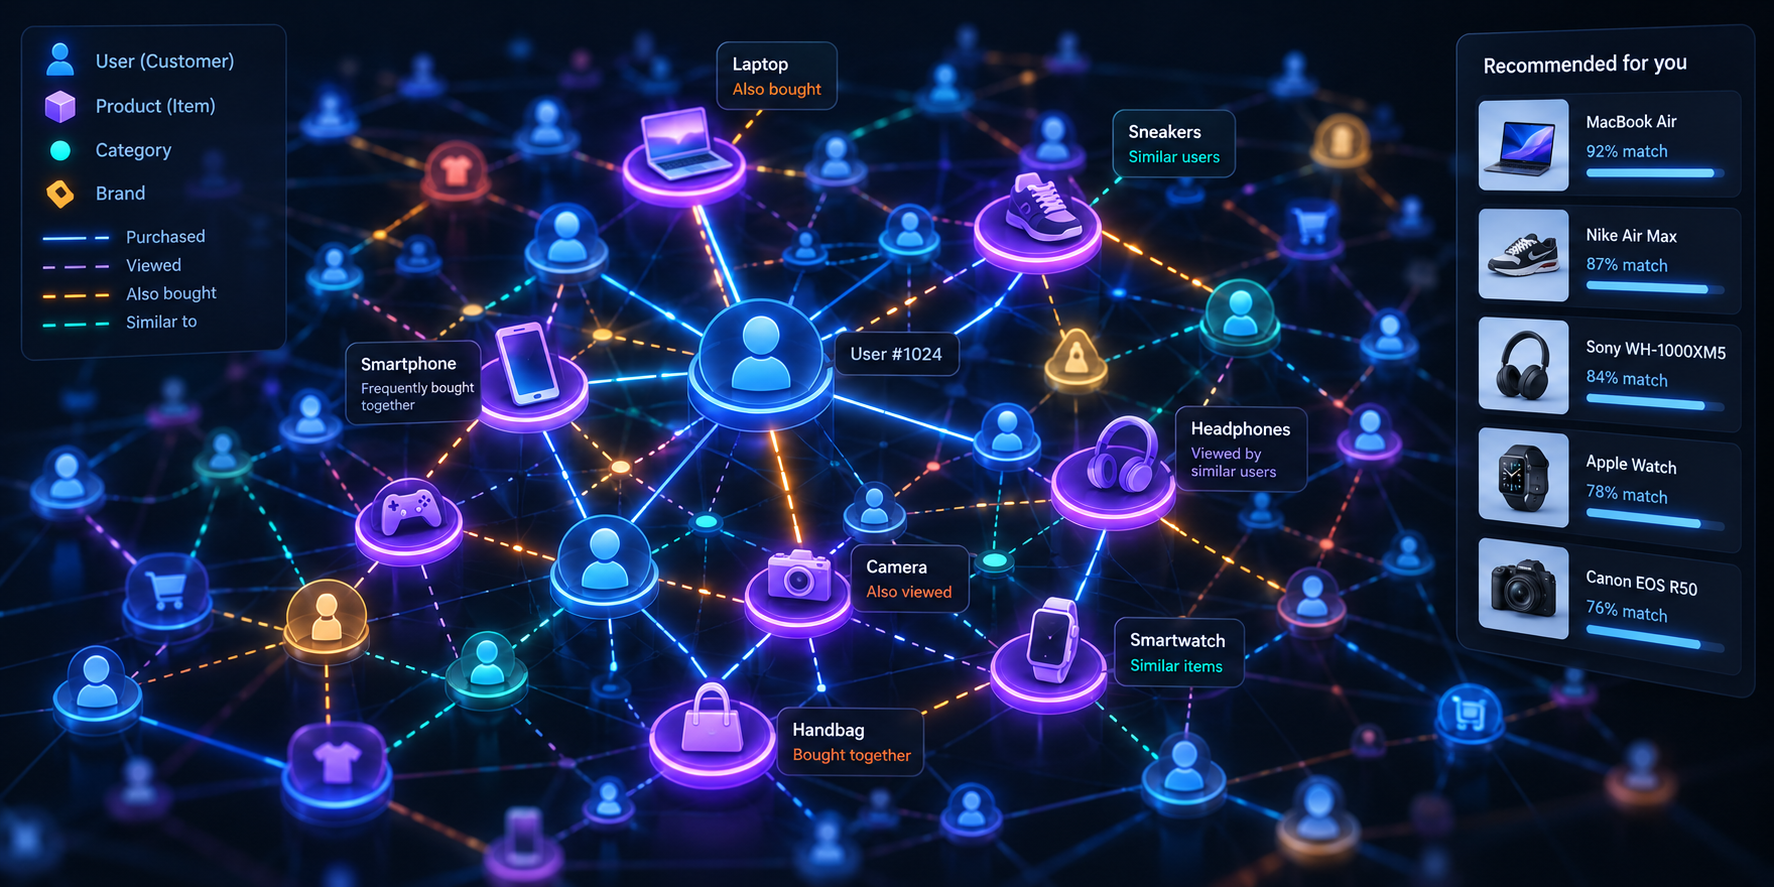
حالا میخواهیم زیر هر محصول بخش «کسانی که این محصول را خریدهاند، این موارد را هم خریدهاند» را پیادهسازی کنیم. یعنی باید از محصول به سراغ خریدارانش برویم، و از آنها به سراغ سایر خریدهایشان برویم.
در SQL، هرکدام از این قدمها به معنای یک Join جدید است. تا دو قدم، SQL بهراحتی از پس کار برمیآید؛ اما هرچه این زنجیره بلندتر شود، کوئری سنگینتر و پیچیدهتر خواهد شد.
دیتابیس گرافی مانند Neo4j، «رابطه» را جزئی از خودِ داده میداند:
هر موجودیت یک گره (Node) است.
هر رابطه یک یال (Edge) یا خطی است که دو گره را به هم وصل میکند.
در این ساختار، حرکت از یک گره به گره بعدی بسیار سریع و کمهزینه است. یک مثال جذاب با زنجیره طولانیتر، سیستم تشخیص تقلب (Fraud Detection) است: فرض کنید حساب اول با حساب دوم شماره موبایل مشترک دارد، حساب دوم با سومی آدرس مشترک، و سومی با چهارمی کارت بانکی مشترک دارد. در دیتابیس گرافی، این زنجیره مشکوک با یک کوئری کوتاه فوراً کشف میشود.
معروفترین: Neo4j
بهترین کاربرد: شبکههای اجتماعی، سیستمهای پیشنهاددهنده، تشخیص تقلب و گراف دانش (Knowledge Graph).
نقطه ضعف: اگر ماهیت دادههای شما بیشتر جدولی است تا شبکهای، استفاده از گراف فقط پیچیدگی اضافی به پروژه تحمیل میکند.
اکنون اپلیکیشن ما بسیار بزرگ شده و باید وضعیت سرورها را زیر نظر بگیریم: میزان مصرف CPU در هر ۱۰ ثانیه، تعداد سفارشها در هر دقیقه، و زمان پاسخگویی به هر درخواست.
این دادهها تقریباً همیشه یک الگوی ثابت دارند: یک زمان (Timestamp)، یک عدد، و چند برچسب (مثل نام سرور). همچنین دادههای جدید همیشه به انتهای دادههای قبلی اضافه میشوند.
دیتابیسهای سری زمانی (Time-Series) برای همین الگو بهینهسازی شدهاند. آنها اعداد پشت سر هم را به شکل فوقالعادهای فشرده میکنند و به سؤالاتی مثل «میانگین مصرف ۵ دقیقه اخیر چقدر بوده است؟» بسیار سریع پاسخ میدهند. حتی میتوانید تنظیم کنید که دادههای قدیمی بهطور خودکار به «میانگین ساعتی» خلاصه شوند و دادههای خام پس از یک هفته پاک گردند.
معروفترینها: InfluxDB و TimescaleDB
بهترین کاربرد: داشبوردهای مانیتورینگ، نمودارهای قیمت (بورس و ارز دیجیتال) و دادههای سنسورها (IoT).
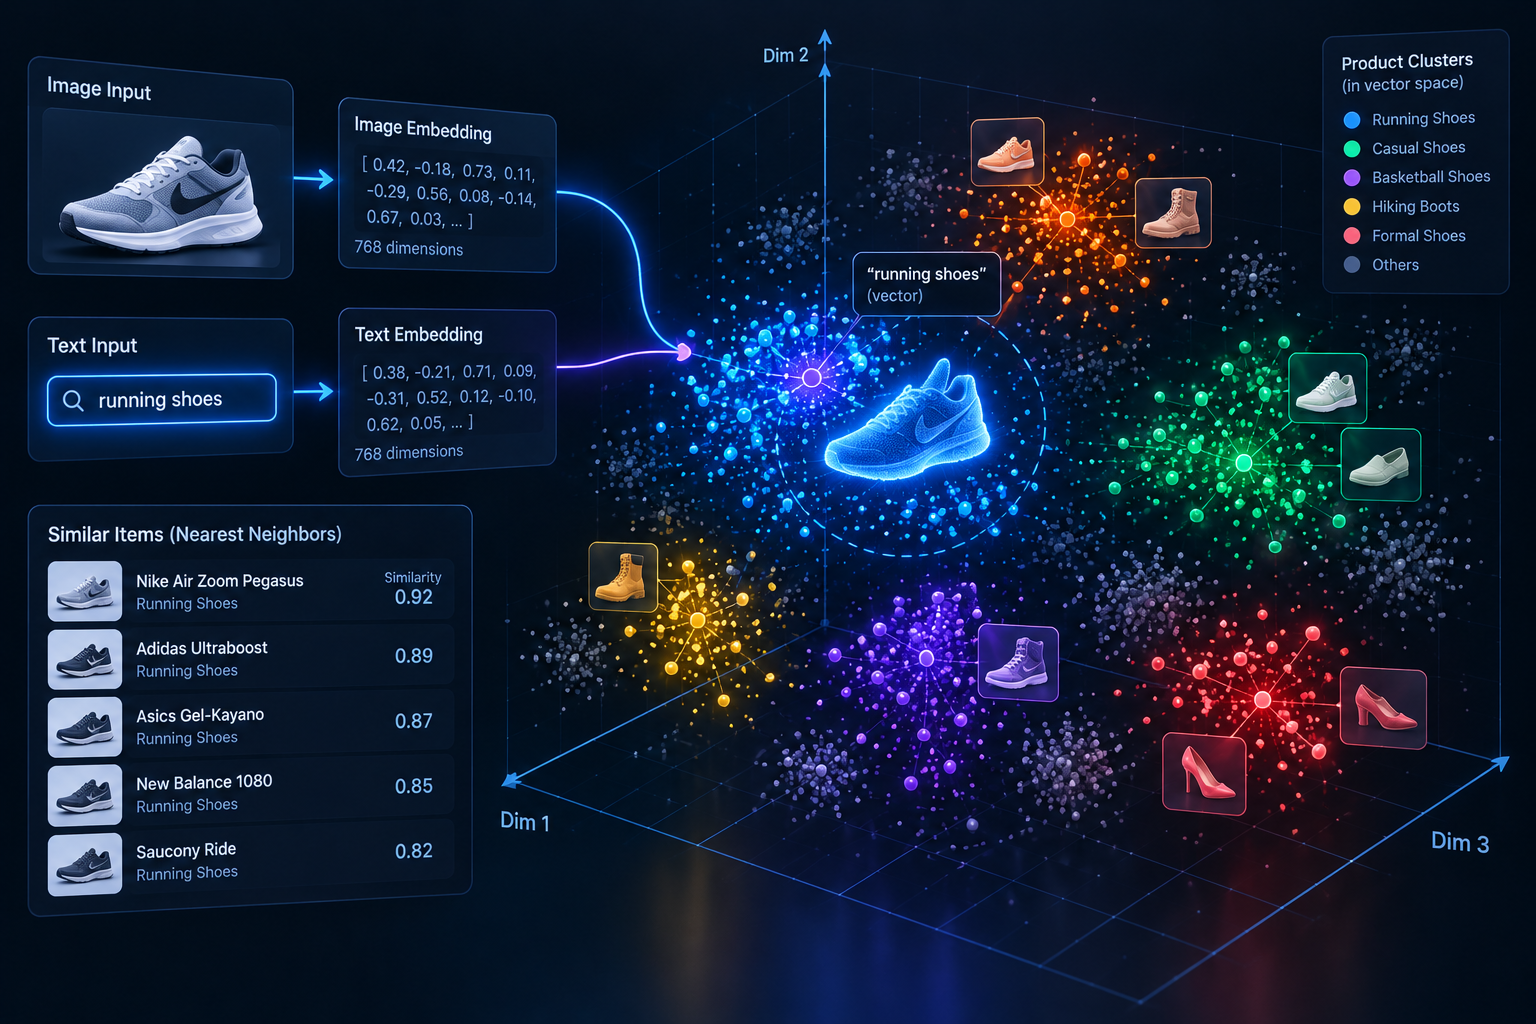
میرسیم به آخرین دیتابیس؛ همان تکنولوژی جذابی که این روزها پشت بسیاری از محصولات هوش مصنوعی قرار دارد. تصور کنید کاربر در سایت جستجو میکند: «یک کفش راحت برای پیادهروی طولانی»، اما در توضیحات هیچکدام از محصولات، دقیقاً این کلمات به کار نرفته است. اینجا جستجوی کلمهای کم میآورد!
راهحل این است که یک مدل هوش مصنوعی، هر متن یا تصویر را به یک وکتور (Vector) تبدیل کند؛ وکتور در واقع یک لیست بلند از اعداد است که به جای خودِ کلمات، معنی و مفهوم آنها را نمایندگی میکند. به این وکتورها امبدینگ (Embedding) میگویند. مفاهیمی که معنای نزدیکی به هم دارند، در این فضای عددی در کنار یکدیگر قرار میگیرند.
وظیفه اصلی وکتور دیتابیس پاسخ سریع به این سؤال است: «نزدیکترین وکتورها به این وکتور کدامها هستند؟» برای اینکه این جستجو در میان میلیونها وکتور سریع انجام شود، معمولاً «نزدیکترینهای تقریبی» را پیدا میکند که برای اکثر کاربردها کاملاً کافی است.
معروفترینها: Milvus ،Qdrant ،Pinecone و افزونه pgvector (برای PostgreSQL)
بهترین کاربرد: جستجوی معنایی (Semantic Search)، یافتن محصولات مشابه و از همه مهمتر معماری RAG (جایی که چتبات قبل از پاسخ دادن، در اسناد شرکت به دنبال بخشهای مرتبط میگردد و آنها را به همراه سؤال کاربر به مدل هوش مصنوعی میدهد).
حالا معماری فروشگاه آنلاین ما کامل شده است. بیایید ببینیم هر بخش روی چه دیتابیسی قرار گرفته است:
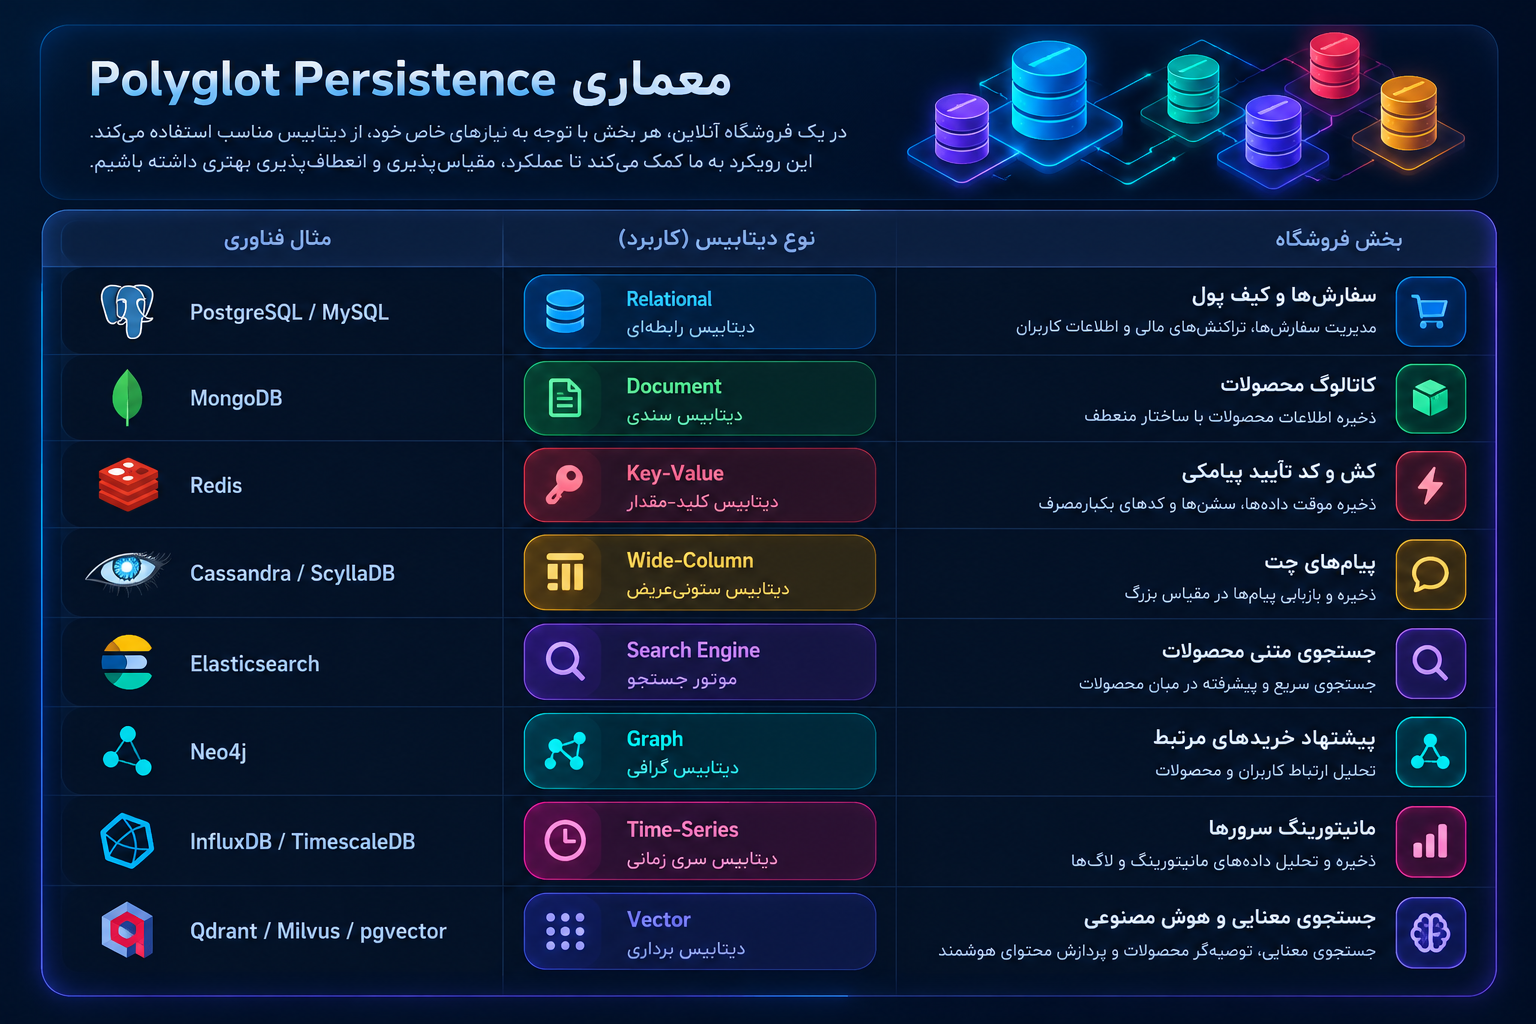
در مهندسی نرمافزار به این رویکرد Polyglot Persistence (چندزبانگی در ذخیرهسازی پایدار) میگویند؛ یعنی برای هر کار، از ابزار مخصوص به خودش استفاده کنیم.
پیش از آنکه سراغ نصب تمام این دیتابیسها بروید، یک هشدار بسیار مهم را جدی بگیرید: هر دیتابیس جدید یعنی یک سیستم جدید که باید از آن نگهداری کنید، بکآپ بگیرید، مانیتورش کنید و دادههایش را با سایر دیتابیسها هماهنگ (Sync) نگه دارید.
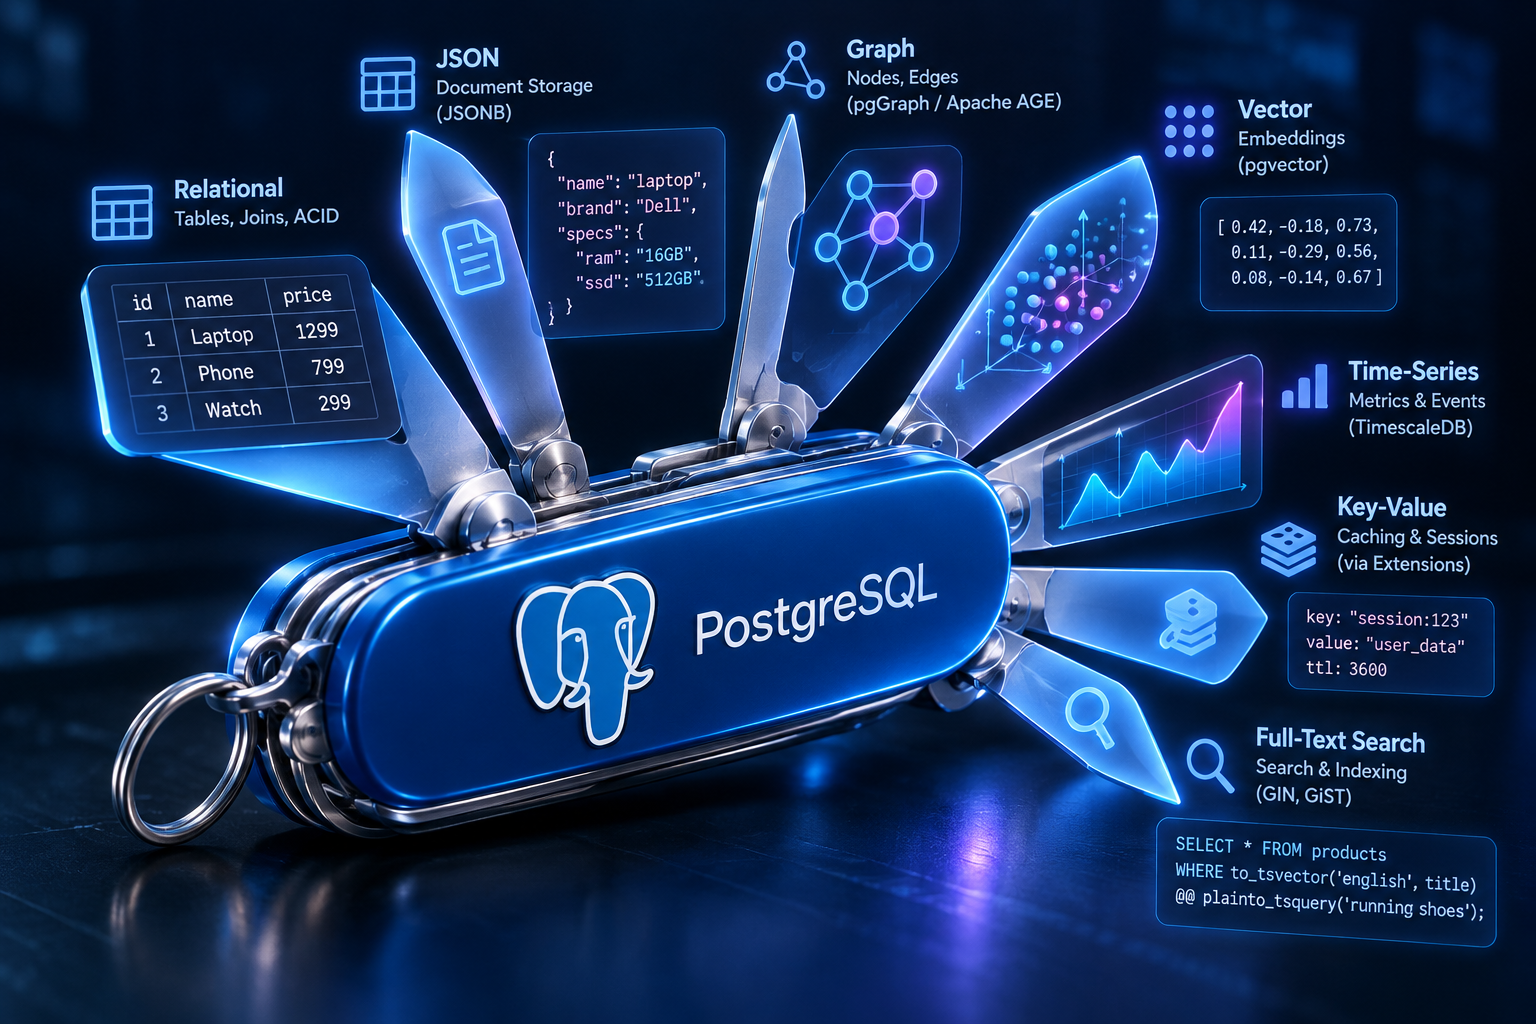
بنابراین اگر قرار است فردا پروژه جدیدتان را شروع کنید، بهترین توصیه این است که کار را با یک دیتابیس رابطهای قدرتمند مثل PostgreSQL شروع کنید. پستگرس بسیاری از این نیازها را به تنهایی یا به کمک افزونههایش تا مقیاس بسیار خوبی پوشش میدهد:
با قابلیت JSONB کار دیتابیسهای داکیومنت و جستجوی متنی را راه میاندازد.
با افزونه pgvector نقش یک وکتور دیتابیس را بازی میکند.
با افزونه TimescaleDB حتی دادههای سری زمانی را هم پشتیبانی میکند.
هر زمان که PostgreSQL در یک قابلیت خاص واقعاً کم آورد و به گلوگاه خوردید، آن موقع دیتابیس تخصصی آن بخش را به معماری خود اضافه کنید، نه زودتر!
همیشه به یاد داشته باشید که سؤال درست، «بهترین دیتابیس کدام است؟» نیست؛ بلکه سؤال درست این است: «داده من چه شکلی دارد و قرار است چه سؤالی از آن بپرسم؟»
منبع: ویدیو یوتوب «۸ نوع اصلی دیتابیس در ۱۰ دقیقه | هر کدوم برای چه کاری مناسبه؟»

