بسیاری از مسائل ماشین لرنینگ شامل هزاران یا حتی میلیونها فیچر برای هر نمونهی آموزشی میشن. نه تنها همهی این فیچرها باعث میشن فرآیند آموزش بهشدت آهسته بشه، بلکه پیدا کردن یک راهحل مناسب رو هم سختتر میکنن. به این مشکل اغلب Curse of Dimensionality (مشقت بعدچندی) میگن.
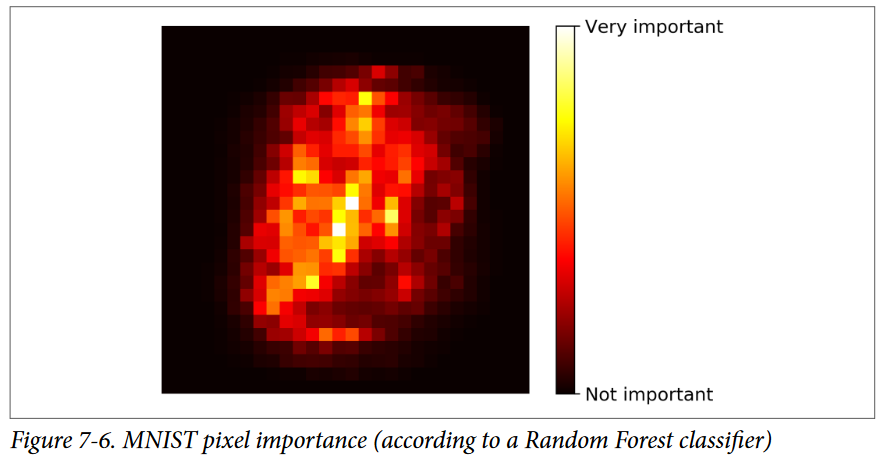
خوشبختانه در مسائل واقعی، اغلب این امکان وجود داره که تعداد فیچرها رو کاهش داد بهطوری که یک مسئلهی رامنشدنی تبدیل به یک مسئلهی رامشدنی بشه. برای مثال تصاویر MNIST رو در نظر بگیرید (طبقهبندی اعداد با MNIST) پیکسلهایی که در گوشههای تصویر قرار دارن تقریبا همیشه سفید هستند، در نتیجه میتونید بدون از دست دادن اطلاعات زیاد، این پیکسلها رو از مجموعهی آموزشی حذف کنید. عکس زیر تایید میکنه که این پیکسلها برای طبقهبندی، کاملا بیاهمیت هستن. همچنین، دو پیکسل ِکنار هم، اغلب بهشدت با هم همبستگی دارن: اگر این دو رو تبدیل به یک پیکسل کنید (برای مثال میانگین دو پیکسل رو بگیرید)، اطلاعات زیادی رو از دست نمیدید.
کاهش ابعاد باعث از دست رفتن اطلاعات میشه (درست مثل کم حجم کردن یک عکس با تبدیل اون به JPEG که میتونه کیفیت اون رو کم کنه) پس درسته که این کار باعث میشه فرآیند آموزش سریعتر بشه، اما شاید باعث بشه که سیستم شما عملکرد بدی داشته باشه. همچنین پایپلاینهای شما رو کمی پیچیده میکنه و بههمین خاطر نگهداری از اونها سختتر میشه. پس، اگر فرآیند آموزش آهسته هست، بهتره قبل از کاهش ابعاد، اول سیستم خودتون رو با مجموعهی دادهی اصلی آموزش بدید. در بعضی مواقع، کاهش ابعاد مجموعهی دادهی آموزشی ممکنه بعضی نویزها و اطلاعات غیرضروری رو حذف کنه و باعث بشه عملکرد افزایش پیدا کنه اما عموما این اتفاق نمیفته؛ این کار فقط باعث میشه سرعت آموزش بیشتر بشه.
جدای از افزایش سرعت آموزش، کاهش ابعاد میتونه بهشدت توی مصورسازی داده کاربردی باشه. کاهش ابعاد به دو یا سه بعد، رسم یک نمای متراکم از یک مجموعهی داده با ابعاد بالا رو امکان پذیر میکنه و باعث میشه با تشخیص الگوهایی مثل خوشهها، بینشهای مهمی رو بهدست بیاریم. همچنین، مصورسازی داده برای انتقال نتیجه گیریها به افرادی که دانشمند داده نیستند، ضروری هست؛ بهطور دقیقتر، افراد تصمیمگیرندهای که از نتایج شما قراره استفاده بکنند.
در این فصل قراره Curse of Dimensionality رو بررسی کنیم و بفهمیم که در فضاهای با ابعاد زیاد چه اتفاقهایی میفته. بعد دو رویکرد اصلی برای کاهش ابعاد و سه روش محبوب برای کاهش ابعاد رو بررسی میکنیم.
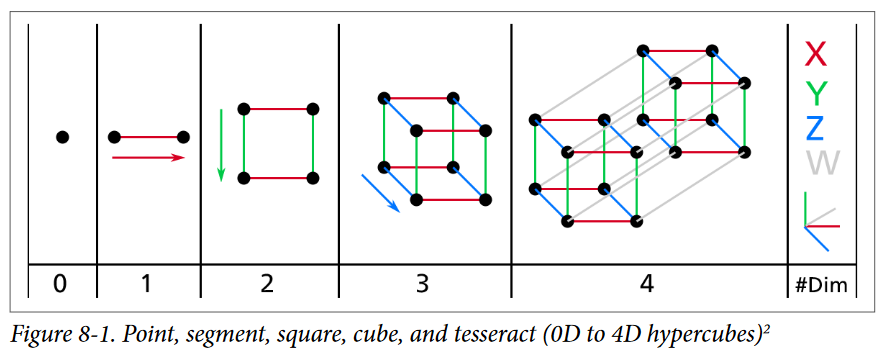
ما به قدری به زندگی کردن در سه بعد عادت کردیم که وقتی میخوایم یک فضا با ابعاد بالا رو تصور کنیم، شهود ما ناکام میمونه. حتی تصور یک ابرمکعب 4 بعدی ساده هم برای ذهن ما سخت هست، چه برسه به یک بیضوی که در یک فضای 1000 بعدی خم شده.
بهنظر میرسه که خیلی از چیزها در فضای با ابعاد بالا، رفتار متفاوتی دارن. برای مثال، اگر یک نقطهی تصادفی در یک مربع واحد انتخاب کنید (مربعی با ابعاد 1×1) احتمال اینکه فاصلهاش از گوشهها کمتر از 0.001 باشه، حدودا برابر 0.4 هست ( به عبارت دیگه، احتمال کمی وجود داره که یک نقطهی تصادفی در طول هر بعدی، دورترین نقطه باشه) اما در یک ابرمکعب با 10000 بعد، این احتمال بیش از 99.99999 درصد هست. در یک ابرمکعب با ابعاد بالا، بیشتر نقاط نزدیک به گوشهها هستند.
این هم یک تفاوت سخت دیگه: اگر دو نقطهی تصادفی در یک مربع واحد انتخاب کنید، فاصلهی بین این دو نقطه بهطور میانگین برابر 0.52 خواهد بود. اگر دو نقطهی تصادفی در یک مکعب 3 بعدی انتخاب کنید، فاصلهی میانگین تقریبا 0.66 خواهد بود. اما دو نقطهی تصادفی در یک ابرمکعب 1000000 بعدی چی ؟ فاصلهی میانگین، باور کنید یا نه، حدودا برابر 408.02 خواهد بود ! این تناقض هست: چطور دو نقطه میتونن انقدر از هم دور باشن درحالی که هر دو در یک ابرمکعب واحد یکسان هستند ؟ خب، در ابعاد بالا فضای زیادی هست. در نتیجه، مجموعه دادههای با ابعاد بالا، در معرض خطر پراکندگی هستند: بیشتر نمونههای آموزشی احتمالا در فاصلهی زیادی از هم باشن. این همچنین به این معناست که یک نمونهی جدید بسیار دورتر از نمونههای آموزشی خواهد بود که باعث میشه این پیشبینیها به نسبت پیشبینی در ابعاد کم، کمتر قابل اعتماد باشه چون این پیشبینیها قراره بر اساس یک برونیابی بزرگتر انجام بشن. خلاصه که، هرچقدر ابعاد مجموعهی آموزشی بیشتر باشه، خطر اورفیت شدن هم بیشتر میشه.
در تئوری، یک راه حل برای Curse of Dimensionality، افزایش اندازهی مجموعهی آموزشی هست بهطوریکه نمونههای آموزشی به یک چگالی کافی برسن. متاسفانه در عمل، تعداد نمونههای لازم برای رسیدن به یک چگالی، بهطور نمایی با تعداد ابعاد افزایش پیدا میکنه. با تنها 100 فیچر (کمتر از مسئلهی MNIST) تعداد نمونههای آموزشی برای اینکه نمونهها بهطور میانگین در فاصلهی 0.1 یکدیگه باشن، بیشتر از اتمهای موجود در جهان ِ قابل مشاهده هست - با فرض اینکه اونها در تمام ابعاد بهطور یکنواخت پخش شدند.
قبل از بررسی الگوریتمهای کاهش بعد، بیاید یک به دو رویکرد اصلی برای کاهش ابعاد نگاهی بندازیم: تصویر (Projection) و Manifold Learning
در مسائل دنیای واقعی، نمونههای آموزشی در طول تمام ابعاد، بهطور یکنواخت پخش نشدند. بسیاری از فیچرها تقریبا ثابت هستند در حالیکه بعضیهاشون بهشدت با هم همبستگی دارن (همونطور که درمورد MNIST گفتیم) در نتیجه، تمام نمونههای آموزشی در یک زیرفضای با ابعاد کمتر از فضای چند بعدی قرار میگیرن ( یا نزدیک به اون ). این به نظر خیلی انتزاعی میاد، بیاید یک مثال رو بررسی کنیم. در شکل زیر میتونید یک مجموعهی دادهی 3 بعدی رو که با دایرهها نشون داده شدن ببینید.
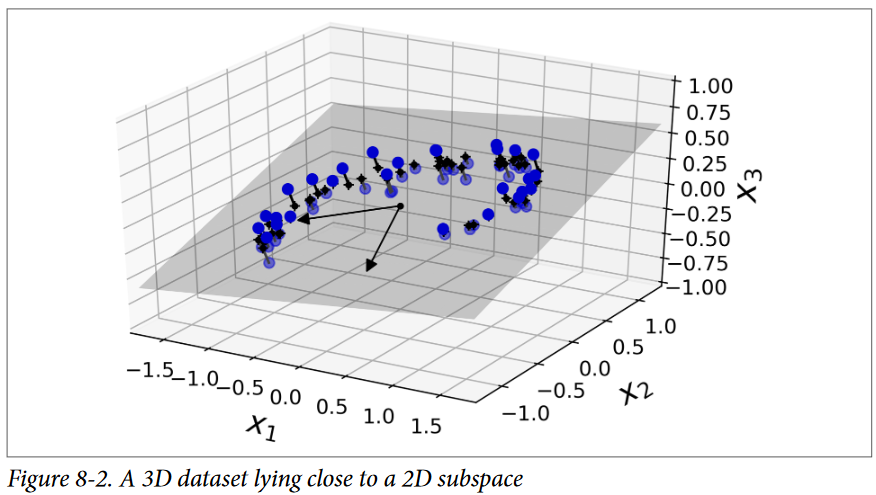
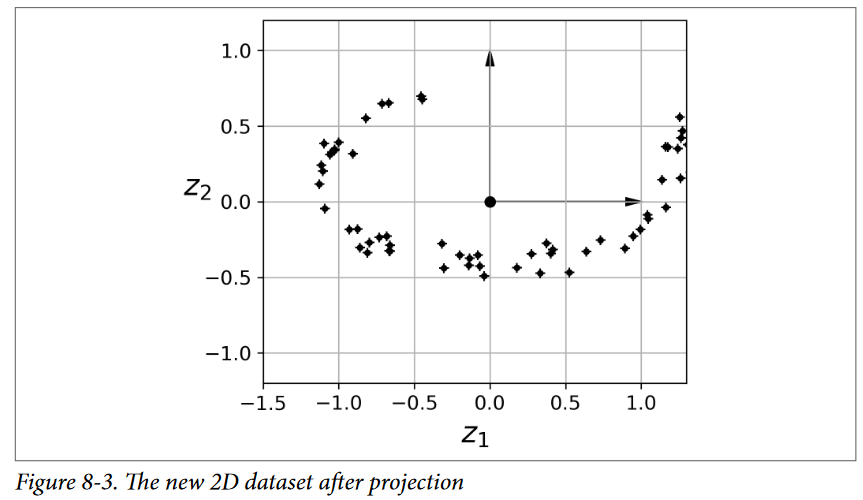
دقت کنید که همهی نمونههای آموزشی در نزدیکی یک صفحه قرار دارن: این یک زیرفضای با ابعاد کمتر ( 2 بعدی ) از فضای با ابعاد بالا هست ( 3 بعدی ) اگر همهی نمونههای آموزشی رو بهطور عمودی به این زیرفضا تصویر کنیم مجموعهی دادهی 2 بعدی شکل زیر بهدست میاد.( این کار با خطهای کوتاهی که نمونههارو به صفحه وصل میکنن نشون داده شده ) ما همین الان ابعاد مجموعهی داده رو از 3 بعدی به 2 بعدی کاهش دادیم. دقت کنید که محورها نشون دهندهی فیچرهای جدید z_1 و z_2 هستند ( مختصات تصویرها روی صفحه )
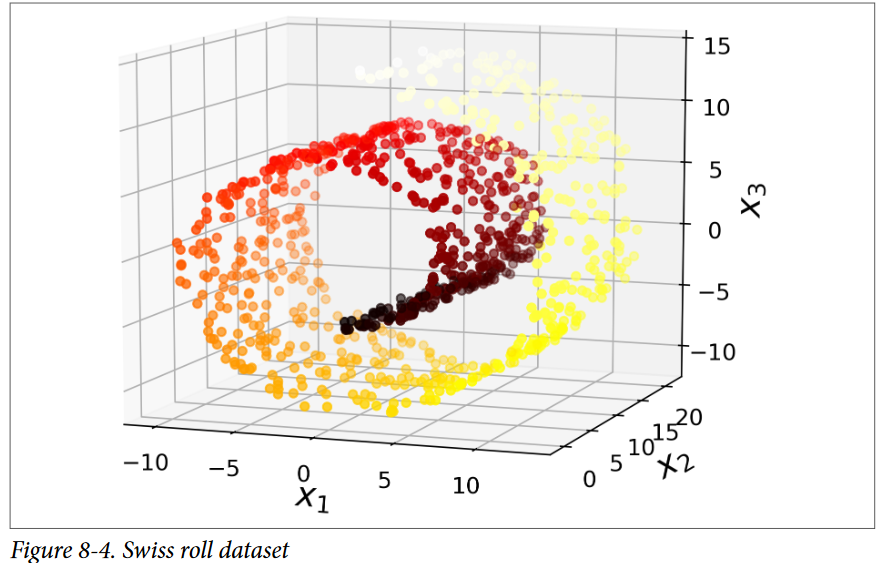
اگرچه، تصویر کردن همیشه بهترین روش برای کاهش ابعاد نیست. در بسیاری از مواقع زیرفضا ممکنه پیچ و تاب و چرخش داشته باشه، مثل مجموعهی دادهی Swiss roll که در شکل زیر میبینید.
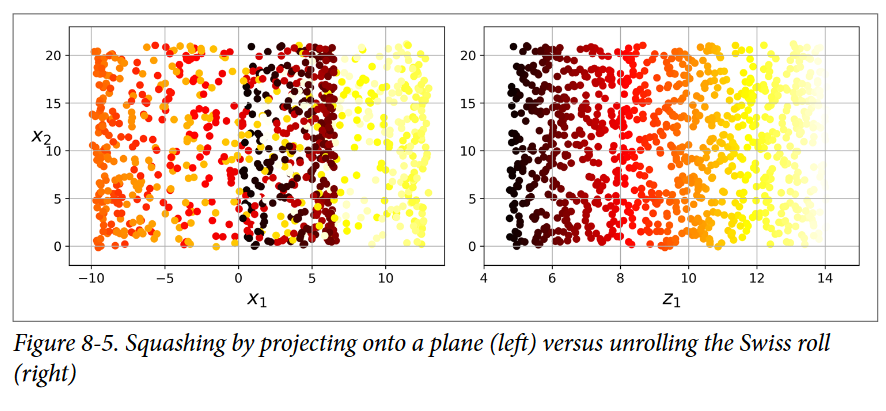
تصویر اون به یک صفحه ( مثلا با حذف فیچر x_3 ) باعث میشه لایههای متفاوتی از مجموعهی داده با هم قاطی بشن که در سمت چپ شکل میبینید. چیزی که ما واقعا میخوایم اینه که مجموعهی داده رو تبدیل به شکل سمت راست کنیم که 2 بعدی هست.
مجموعهی دادهی Swiss roll یک نمونه از یک منیفلد دو بعدی هست. سادهتر، یک منیفلد دو بعدی یک شکل 2 بعدی هست که میتونه در یک فضا با ابعاد بالاتر، خمیده و پیچیده بشه. بهطور عمومیتر، یک منیفلد d-بعدی یک بخشی از یک فضای n-بعدی هست (d < n) که بهصورت محلی نشون دهندهی یک ابرصفحهی d-بعدی هست. در مثالی که زدیم، d=2 و n=3 هست که بهطور محلی نشون دهندهی یک صفحهی دو بعدی هست اما در بعد سوم پیچیده شده.
بسیاری از الگوریتم های کاهش بعد با مدل سازی منیفولدی که نمونههای آموزشی روی آن قرار دارند کار می کنند؛ به این کار میگن Manifold Learning. این بر فرض Manifold تکیه میکنه (نام دیگر: Manifold Hypothesis): در دنیای واقعی، اکثر مجموعه های داده با ابعاد بالا نزدیک به یک منیفلد با ابعاد پایینتر قرار دارن. این ادعا اغلب بهصورت تجربی مشاهده میشه.
یکبار دیگه MNIST رو در نظر بگیرید: بیشتر عکسهای دستنویس اعداد شباهتهایی به هم دارن. همشون از خطوط متصل بههم ساخته شدن، حاشیهها سفید هستند و تقریبا در مرکز قرار دارن. اگر بهصورت تصادفی عکسهایی تولید کنید، فقط یک کسر بسیار کمی از اونها شبیه به اعداد دستنویس خواهند شد. به عبارت دیگه، اگر بخواید عکس یک عدد رو درست کنید، نسبت به موقعی که بخواید هر تصویری درست کنید، درجهی آزادی کمتری خواهید داشت. این محدودیتها باعث میشن که مجموعهی داده به یک منیفلد با ابعاد کمتر، فشرده بشن.
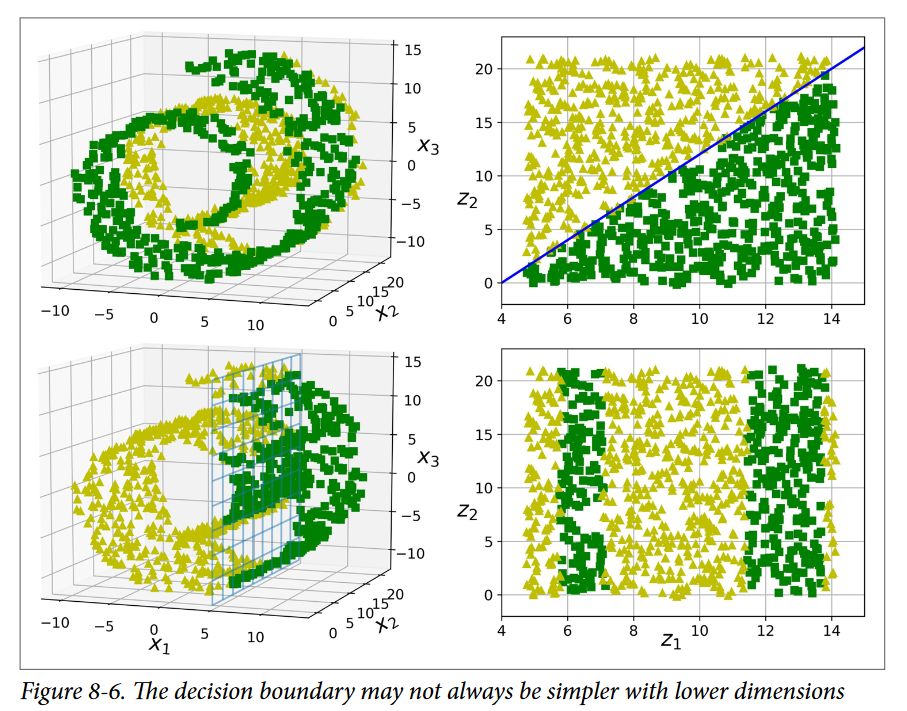
فرض منیفلد اغلب با یک فرض ضمنی دیگه هم همراه هست: کاری که میخوایم انجام بدیم ( طبقهبندی یا رگرسیون ) آسون تر خواهد شد اگر در فضای ِ با بعد ِ کمتر ِ منیفلد بیان بشه. برای مثال در شکل زیر، مجموعهی داده تبدیل به دو کلاس شده: در فضای 3 بعدی ( سمت چپ ) مرز تصمیم بسیار پیچیده خواهد بود اما در فضای منیفلد 2 بعدی ( سمت راست ) مرز تصمیم گیری یک خط صاف خواهد بود.
اگرچه این فرض ضمنی همیشه صادق نیست. برای مثال، در ردیف آخر همین شکل مرز تصمیم در x_1 = 5 واقع شده. این مرز تصمیم در فضای 3 بعدی بسیار ساده بهنظر میاد ( یک خط عمودی ) اما در منیفلد پیچیدهتر هست (مجموعهای از 4 خط مستقل از هم )
بهطور خلاصه، کاهش ابعاد مجموعهی داده قبل از آموزش مدل، معمولا سرعت رو افزایش میده اما همیشه ما رو به یک راه حل بهتر یا سادهتر نمیرسونه؛ همه چیز بسته به مجموعهی داده داره.
خوشبختانه حالا به درک خوبی از Curse of Dimensionality و طرز مقابلهی الگوریتمها با اونها رسیدید؛ مخصوصا وقتی که فرض منیفلد صادق هست. بقیهی این مطلب دربارهی الگوریتمهای محبوب هست.
تحلیل مولفههای اصلی یا Principal Component Analysis محبوبترین الگوریتم برای کاهش ابعاد هست. PCA ابتدا ابرصفحهای رو که در نزدیکترین فاصله با دادهها قرار داره شناسایی میکنه و بعد دادههارو به اون تصویر میکنه؛ درست مثل شکل 2-8
قبل از اینکه بتونید مجموعهی دادههای آموزشی رو به یک ابرصفحهی با ابعاد پایینتر تصویر کنید، ابتدا باید ابرصفحهی مناسب رو انتخاب کنید. برای مثال، در شکل پایین سمت چپ یک مجموعهی دادهی 2 بعدی با 3 محور مختلف نمایش داده شده ( ابرصفحههای 1 بعدی ) در سمت راست نتیجهی تصویر مجموعهی داده به هر محور قرار داره. همونطور که میبینید، تصویر به خط تو پر بیشترین واریانس رو حفظ میکنه، درحالیکه تصویر به خط نقطهای واریانس کمی رو حفظ میکنه و تصویر به خط بریده مقدار متوسطی از واریانس رو حفظ میکنه.
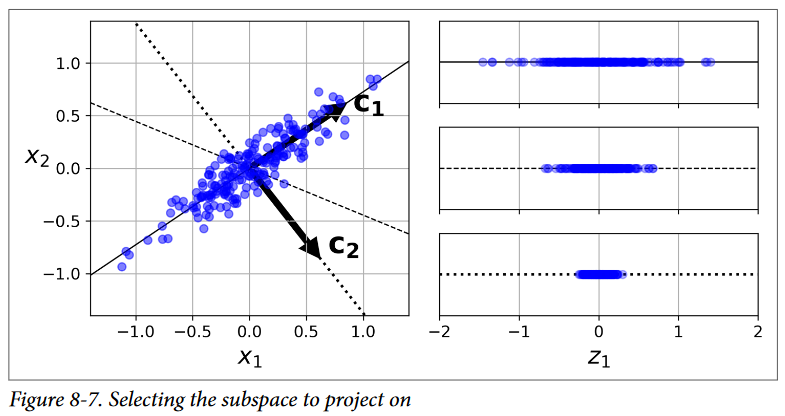
منطقی هست که محورهایی رو انتخاب کنیم که بیشترین مقدار واریانس رو حفظ میکنه چون به نسبت بقیه تصویرها، اطلاعات کمتری رو از دست خواهیم داد. یک راه دیگه برای توجیه این انتخاب اینه که این محور محوری هست که فاصلهی میانگین مربعات رو بین مجموعهی دادهی اصلی و تصویر رو به حداقل میرسونه. این ایدهی سادهی پشت PCA هست.
روش PCA محوری رو شناسایی میکنه که بیشترین مقدار واریانس رو در مجموعهی دادهی آموزشی داره. در شکل بالا این محور، خط تو پر هست. همچنین یک محور دوم هم پیدا میکنه که قائم بر محور اول هست. این محور دوم نشون دهندهی بیشترین مقدار واریانس باقی مونده هست. در این مثال 2 بعدی انتخاب دیگهای وجود نداره: خط نقطهای هست. اگر مجموعهی داده ابعاد بیشتری داشت، PCA یک محور سوم هم انتخاب میکرد که قائم بر دو محور قبلی بود و یک محور چهارم و یک محور پنجم و الی آخر؛ تا تعداد محورها برابر ابعاد مجموعهی داده بشه.
به i-امین محور میگن i-امین جزء اصلی داده (i^th Principal Component) در شکل بالا اولین PC محوری هست که بردار c_1 روی اون قرار داره و دومین PC محوری هست که بردار c_2 روی اون قرار داره. در شکل 2-8 دو PC اول محورهای عمودی هستند که دو پیکان روی اونها قرار داره و سومین PC محور عمودی روی صفحه هست.
برای هر جزء اصلی، PCA یک بردار واحد به مرکز صفر پیدا میکنه که در جهت PC هست. از اونجایی که دو بردار واحد مخالف در یک محور قرار دارند، جهت بردارهای واحدی که PCA برمیگردونه ثابت نیست: اگر کمی مجموعهی دادههای آموزشی رو کمی تغییر بدید و دوباره PCA رو اجرا کنید، بردارهای واحد ممکنه در جهت مخالف بردارهای اصلی قرار بگیرن. اگرچه، اونها عموماً همچنان روی یک محور یکسان قرار خواهند گرفت. در بعضی مواقع، جفتهایی از بردارهای واحد ممکنه حتی بچرخن یا جابجا بشن ( اگر واریانس بین این دو محور نزدیک هم باشن ) اما صفحهای که تعریف میکنن عموماً یکسان باقی میمونه.
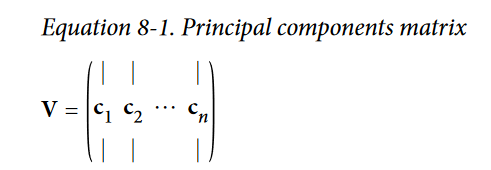
خب حالا چطور میتونیم اجزای اصلی یک مجموعهی دادهی آموزشی رو پیدا کرد؟ خوشبختانه یک تکنیک فاکتورگیری استاندارد از ماتریس وجود داره به نام Singular Value Decomposition (SVD) که میتونه ماتریس مجموعهی آموزشی X رو تجزیه کنه به ضرب 3 ماتریس U, E, V که V شامل بردارهای واحدی هست که تمام اجزای اصلی رو تعریف میکنن. این ماتریس رو میتونید در زیر ببینید:
کدی که در زیر میبینید از تابع svd در کتابخانهی NumPy استفاده میکنه تا تمام اجزای اصلی مجموعهی آموزشی رو بدست بیاره بعد دو بردار واحدی رو که دو جز اصلی اول رو تعریف میکنن، استخراج میکنه:
X_centered = X - X.mean(axis=0) U, s, Vt = np.linalg.svd(X_centered) c1 = Vt.T[:, 0] c2 = Vt.T[:, 1]
روش PCA فرض میکنه که مجموعهی داده در اطراف مبدا قرار دارد. خواهیم دید که کلاس PCA در Scikit-Learn خودش در مرکز بودن دادهها رو مدیریت میکنه. اگر PCA رو خودتون پیادهسازی میکنید یا اگر از کتابخانههای دیگه استفاده میکنید، فراموش نکنید که ابتدا دادهها در مرکز قرار گرفته باشن.
وقتی همهی اجزای اصلی رو شناسایی کردید، میتونید ابعاد مجموعهی داده رو به d بعد کاهش بدید. این کار با تصویر کردن مجموعهی داده به ابرصفحهای که با d جز اصلی اول تعریف شدند، انجامپذیر هست. انتخاب این ابرصفحه تضمین میکنه که این تصویر تا جای ممکن واریانس رو حفظ میکنه. برای مثال در تصویر 2-8 که مجموعهی دادهی 3 بعدی به ابرصفحهی 2 بعدی که با دو جزء اصلی اول تعریف شده، تصویر شده، قسمت بزرگی از واریانس رو حفظ میکنه. به همین خاطر، تصویر 2 بعدی شباهت زیادی به مجموعه دادهی 3 بعدی داره.
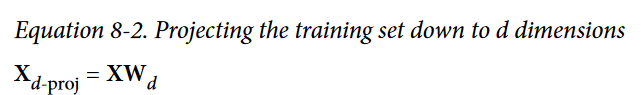
برای تصویر دادهها به ابرصفحه و بهدست آوردن یک مجموعهی دادهی کاهش یافته به نام X_d-proj با d-بعد، ضرب ماتریسی مجموعه داده X رو با W_d محاسبه کنید. W_d یعنی d ستون اول ماتریس V
کد زیر دادهها رو به صفحهای که توسط دو جزء اصلی اول تعریف شده، تصویر میکنه.
W2 = Vt.T[:, :2]
X2D = X_centered.dot(W2)
این هم از این! حالا یاد گرفتید که ابعاد هر مجموعه دادهای رو به هر تعداد بعدی کاهش بدید و همزمان، واریانس رو هم حفظ کنید.
کلاس PCA کتابخانه Scikit-Learn از تجزیهی SVD برای پیادهسازی PCA استفاده میکنه، مثل کاری که قبلا اینجا انجام دادیم. کد زیر PCA رو برای کاهش ابعاد مجموعه داده به 2 بعد، اعمال میکنه. ( دقت کنید که به صورت خودکار دادهها رو به مرکز میاره )
from sklearn.decomposition import PCA

pca = PCA(n_components = 2)
X2D = pca.fit_transofrm(X)
یکی دیگه از اطلاعات بهدرد بخور، Explained Variance Ratio برای هر جزء اصلی هست که از طریق explained_variance_ratio_ قابل دسترسی هست. این نسبت نشوندهندهی نسبت واریانس مجموعهی دادهها هست که در طول هر جزء اصلی قرار داره. برای مثال بیاید این مقدار رو برای دو جز اصلی اول شکل 2-8 بررسی کنیم:
pca.explained_variance_ratio_
# array([0.84248607, 0.14631839])
این خروجی یعنی 84.2 درصد واریانس دادهها در طول اولین PC و 14.6 درصد دادهها در طول PC دوم قرار داره. باقیمونده میشه 1.2 درصد که برای PC سوم هست. پس میشه نتیجه گرفت که PC سوم حاوی اطلاعات کمی هست.
بهجای انتخاب خودسرانهی تعداد ابعاد مورد نظر برای کاهش، ساده تره که تعدادی از ابعاد رو انتخاب کنیم که انتخاب اونها باعث میشه مقدار زیادی به واریانس اضافه بشه. ( برای مثال 95درصد ) مگر اینکه هدف شما از کاهش ابعاد، مصورسازی داده هست؛ که در اون صورت بهتره که ابعاد رو به 2 یا 3 بعد کاهش بدید.
کد زیر PCA رو بدون کاهش ابعاد اجرا میکنه، سپس کمترین تعداد ابعاد لازم رو برای حفظ 95 درصد از واریانس مجموعهی داده، محاسبه میکنه:
pca = PCA()
pca.fit(X_train)
cumsum = np.cumsum(pca.explained_variance_ratio_)
d = np.argmax(cumsum >= 0.95) + 1
بعد میتونید n_components=d قرار بدید و PCA رو دوباره اجرا کنید. اما یک گزینهی بهتر هم هست: بهجای اینکه تعداد اجزای اصلی رو مشخص کنید، میتونید n_components رو برابر یک مقدار اعشاری بین0.0 و 1.0 قرار بدید که نشوندهندهی واریانسی هست که میخواید حفظ بشه:
pca = PCA(n_components = 0.95)
X_reduced = pca.fit_transform(X_train)
یه گزینهی دیگه هم اینهکه نمودار Eplained Variance رو برای تعداد ابعاد رسم کنیم ( یعنی رسم cumsum - شکل 8-8) معمولاً یک آرنجشکل در منحنی ایجاد خواهد شد، جایی که رشد سریع EV متوقف میشه. در این حالت، میبینید که با کاهش ابعاد تا حدود 100 تا، EV زیادی رو از دست نخواهد رفت.
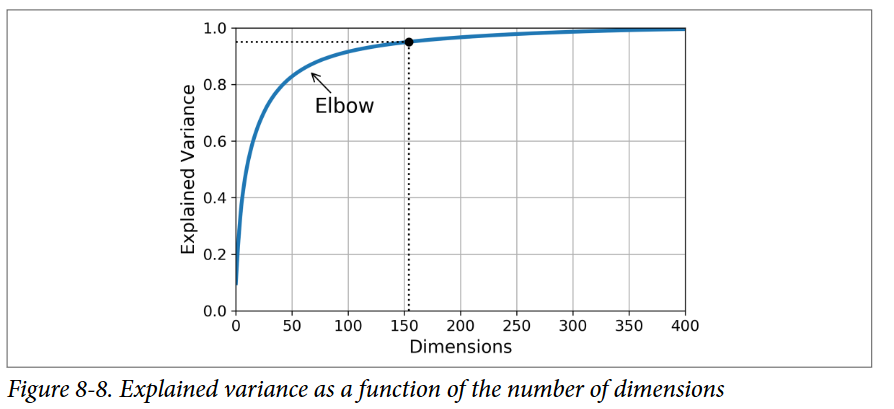
بعد از کاهش ابعاد، مجموعهی دادهی آموزشی فضای کمتری خواهد گرفت. برای مثال، PCA رو روی MNIST با حفظ واریانس 95 درصد امتحان کنید. ملاحظه خواهید کرد که هر نمونه کمی بیش از 150 فیچر خواهد داشت، بهجای 784 فیچر اصلی. پس، درحالیکه بیشتر واریانس حفظ شده، حالا مجموعهی دادههای ما 20 درصد اندازه اصلی هست! این یک نسبت فشردهسازی معقول هست و میتونید ببینید که این کاهش اندازه چقدر یک الگوریتم طبقهبندی رو سریعتر میکنه. ( مثل SVM )
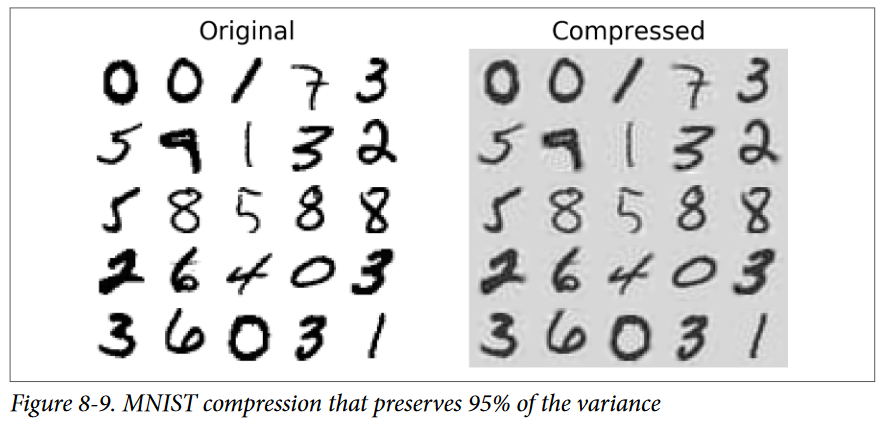
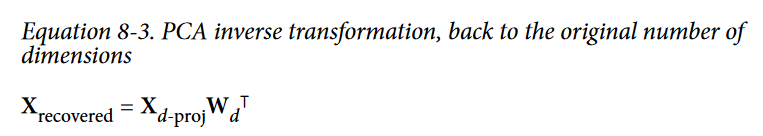
همچنین این امکان وجود داره که این مجموعهی دادهی فشرده شده رو نافشرده کرد تا به 784 بعد اصلی برسه. این کار با تبدیل معکوس تصویر PCA امکان پذیر هست. با این کار مجموعهی دادهی اصلی برنخواهد گشت چون با تصویر کردن مقداری از اطلاعات رو از دست خواهیم داد ( با اون 5 درصد واریانسی که حذف کردیم ) اما احتمالا شبیه به نسخهی اصلی خواهد بود. فاصلهی مربع میانگین بین دادههای اصلی و دادههای بازسازی شده ( قبل و بعد از فشردهسازی ) Reconstruction Error یا خطای بازسازی نام داره.
کد زیر MNIST رو به 154 بعد کاهش میده و سپس با استفاده از تابع inverse_transofrm اون رو 784 بعد برمیگردونیم:
pca = PCA( n_components = 154 )
X_reduced = pca.fit_transform(X_Train)
X_recovered = pca.inverse_transform(X_reduced)
شکل 9-8 تعدادی عدد رو از مجموعهی دادهی اصلی ( در سمت چپ ) و عدد متناظر بعد از فشردهسازی و نافشردهسازی رو نشون میده. ملاحظه میکنید که کمی کاهش کیفیت در عکسها وجود داره اما اعداد همچنان اکثرا دستنخورده هستند.
معادله تبدیل معکوس رو در زیر میبینید:
اگر هایپرپارامتر svd_solver رو برابر "randomized" قرار بدید، Scikit-Learn از یک الگوریتم تصادفی به نام Randomized PCA استفاده میکنه که بهسرعت تعداد حدودی اولین d جزء اصلی رو پیدا میکنه. پیچیدگی محاسباتی اون برابر O(m × d^2) + O(d^3) هست. پیچیدگی محاسباتی روش SVD کامل برابر (m × n^2) + O(n^3) هست. پس اگر d خیلی کوچکتر از n باشه این روش سریعتر هست:
rnd_pca = PCA(n_components = 154, svd_solver = "randomized")
X_reduced = rnd_pca.fit_transform(X_train)
بهصورت دیفالت، svd_solver="auto" هست: اگر m یا n بزرگتر از 500 و d کمتر از 80 درصد از m یا n باشه، Scikit-Learn از Randomized PCA استفاده خواهد کرد و در غیر این صورت از Full SVD استفاده خواهد کرد. اگر میخواهید کتابخونه رو مجبور کنید که از Full SVD استفاده کنه، میتونید svd_solver="full" قرار بدید.
یک مشکل با پیادهسازی قبلی PCA اینه که برای اجرای الگوریتم ابتدا باید تمام مجموعهی داده در حافظه قرار بگیره. خوشبختانه الگوریتمهای PCA افزایشی یا Incremental PCA برای رفع این مشکل گسترش یافته. این الگوریتمها به ما اجازه میدن تا مجموعهی داده رو به چند دستهی کوچک تقسیم کنیم و به یک الگوریتم IPCA هر دفعه یک دستهی کوچک بدیم. این برای مجموعهی دادههای بزرگ و پیادهسازی PCA بهصورت برخط کاربرد داره. ( بر خطی یعنی همون لحظه که نمونههای جدید میرسن )
کد زیر مجموعهی داده MNIST رو به 100 دستهی کوچک تقسیم میکنه ( با استفاده از تابع array_split ) و اونها رو وارد کلاس IncrementalPCA میکنه تا ابعاد MNIST رو به 154 تا کاهش بده ( مثل قبل ) دقت کنید که باید بهجای تابع fit که با کل مجموعهی داده سروکار داشت، تابع partial_fit رو فراخوانی کنید که مناسب دادههای دستهای هست:
from sklearn.decomposition import IncrementalPCA

n_batches = 100
inc_pca = IncrementalPCA(n_components = 154)
for X_batch in np.array_split(X_train, n_batches):
         inc_pca.partial_fit(X_batch)
X_reduced = inc_pca.transform(X_train)
بهعنوان گزینهی دیگه میتونید از کلاس memmap کتابخونهی NumPy استفاده کنید که به شما اجازه میده یک آرایهی بزرگ رو که در یک فایل باینری روی دیسک ذخیره شده، دستکاری کنید، طوری که انگار تمام اون در حافظه قرار داره؛ این کلاس در صورت نیاز، فقط دادههای مورد نیاز رو در حافظه بارگزاری میکنه. از اونجایی که کلاس IncrementalPCA فقط از قسمت کوچکی از آرایه استفاده میکنه، مصرف حافظه تحت کنترل قرار میگیره. این کار این امکان رو میده که از تابع fit استفاده کنیم
X_mm = np.memmap(filname, dtype="float32", mode="readonly", shape=(m,n))

batch_size = m // n_batches
inc_pca = IncrementalPCA(n_components=154, batch_size=batch_size)
inc_pca.fit(X_mm)
در فصل 5 درباره Kernel Trick خوندیم: یک روش ریاضیاتی برای نگاشت نمونهها به یک فضای با ابعاد بالا ( به نام فضای فیچر ) این روش اجازه میداد که طبقهبندیهای غیرخطی و رگرسیون با SVM انجام بشه. بهیاد بیارید که یک مرز تصمیم خطی در یک فضای فیچر با ابعاد بالا برابر هست با یک مرز تصمیم پیچیدهی غیر خطی در فضای اصلی.
اینطور که پیداست از همین روش میشه توی PCA هم استفاده کرد که این امکان رو فراهم میکنه که برای کاهش ابعاد، از تصویرهای پیچیدهی غیرخطی استفاده کرد. به این روش میگن Kernel PCA یا kPCA. این روش اغلب اوقات در حفظ خوشههای نمونهها بعد از تصویر و بعضی اوقات باز کردن مجموعهی دادههایی که در نزدیکی یک منیفلد پیچخورده هستند، خوب عمل میکنه.
کد زیر از کلاس KernelPCA برای پیادهسازی kPCA با RBF Kernel استفاده میکنه.
from sklearn.decomposition import KernelPCA
rbf_pca = KernelPCA(n_components = 2, kernel = "rbf", gamma = 0.04)
X_reduced = rbd_pca.fit_transform(X)
شکل زیر مجموعهی دادهی Swill Roll رو نشون میده که با استفاده از یک کرنل خطی ( معادل با کلاس PCA عادی )، یک RBF Kernel و یک Sigmoid Kernel به دو بعد کاهش یافته.
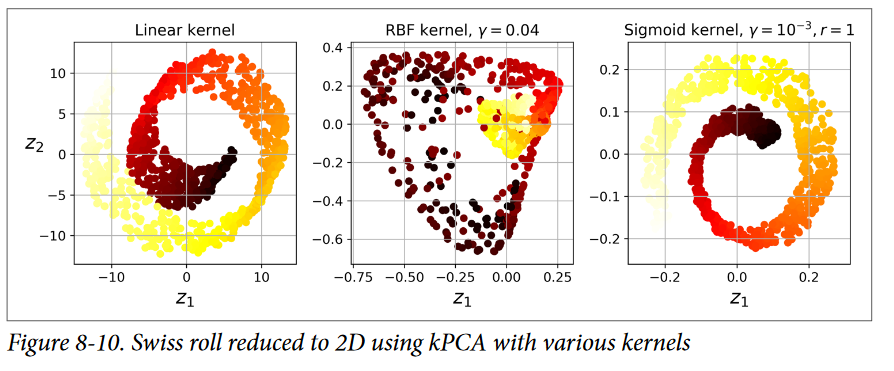
از اونجایی که kPCA یک الگوریتم یادگیری بدون نظارت هست، برای انتخاب بهترین کرنل و هایپرپارامترها هیچ روش اندازهگیری عملکردی وجود نداره. از اونجایی که کاهش ابعاد معمولاً یک مرحلهی آمادهسازی برای یادگیری با نظارت هست، میتونید از Grid Search برای پیدا کردن کرنل و هایپرپارامترهایی که عملکرد رو افزایش میدن، استفاده کنید. کد زیر یک پایپلاین دو مرحلهای درست میکنه، ابتدا ابعاد رو به 2 بعد با استفاده از kPCA کاهش میده و سپس برای طبقهبندی از Logistic Regression استفاده میکنه. بعد از GridSearchCV برای پیدا کردن بهترین کرنل و gamma برای kPCA استفاده میکنه:
from sklearn.model_selection import GridSearchCV
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline

clf = Pipeline([
     ("kpca", KernelPCA(n_components=2)),
     ("log_reg", LogisticRegresion())
])
param_grid = [{
     "kpca__gamma":np.linspace(0.03, 0.05, 10),
      "kpca__kernel":["rbf", "sigmoid"]
}]
grid_search = GridSeachCV(clf, param_grid, cv=3)
grid_search.fit(X, y)
از طریق best_params_ هم میتونید بهترین هایپرپارامتر و کرنل رو ببینید:
grid_search.best_params_
# {'kpca__gamma': 0.043333333333333335, 'kpca__kernel': 'rbf'}
یک روش بدون نظارت هم اینه که کرنل و هایپرپارامترهایی رو که کمترین نرخ بازسازی رو دارن انتخاب کنیم. دقت کنید که بازسازی به سادگی PCA خطی نیست. علتش رو در شکل 11-8 میبینید. در بالا سمت چپ میتونید مجموعهی دادهی اصلی رو ببینید. در بالا سمت راست مجموعهی دادهی 2 بعدی بعد از اعمال kPCA با RBF Kernel هست. به لطف Kernel Trick این تبدیل از لحاظ ریاضی معادل هست با استفاده از تابع نگاشت فی برای نگاشت نمونههای آموزشی به یک فضای فیچر بینهایتبعدی ( پایین سمت راست ) و سپس تصویر مجموعهی دادهی آموزشی به 2 بعد با استفاده از PCA خطی.
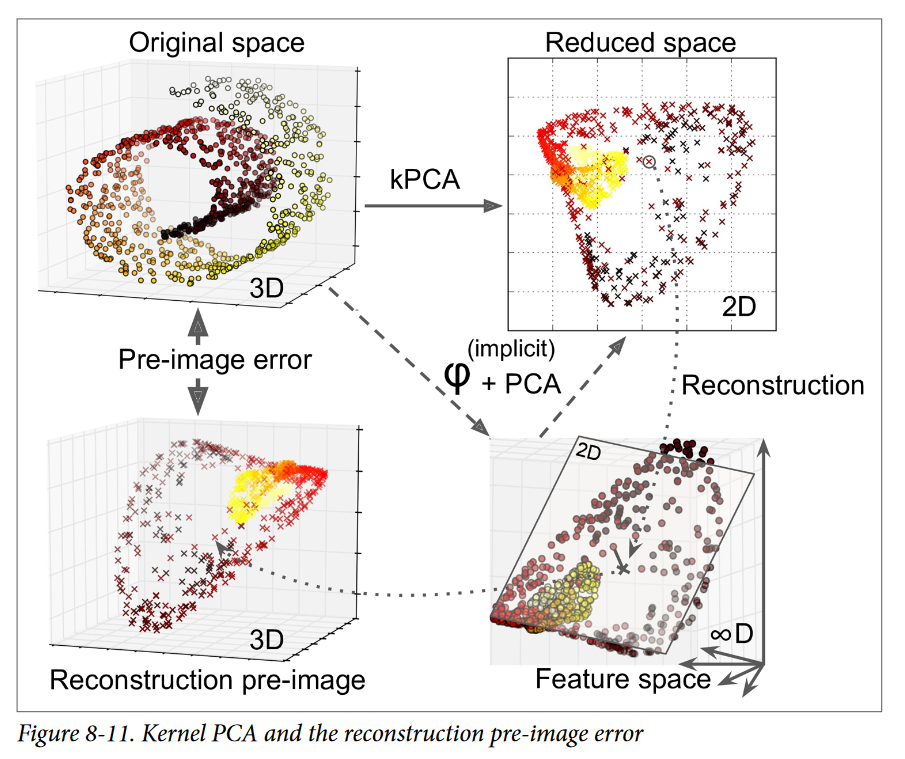
دقت کنید که اگه میتونستیم مرحلهی PCA خطی رو برای یک نمونهی داده شده در فضای کاهش یافته، معکوس کنیم، نقطهی بازسازی شده در فضای فیچر قرار میگرفت نه در فضای اصلی. ( بهعنوان مثال نقطهای که با X نشون داده شده ) از اونجایی که فضای فیچر بینهایت-بعدی هست، ما نمیتونیم نقطهی بازسازی شده رو محاسبه کنیم و در نتیجه نمیتونیم مقدار حقیقی نرخ بازسازی رو محاسبه کنیم. خوشبختانه، این امکان هست که یک نقطه رو در فضای اصلی پیدا کنیم که نگاشت نزدیکی به نقطهی بازسازی شده داشته باشه. این نقطه پیش-تصویر بازسازی نام داره. وقتی این پیش-تصویر رو داشته باشید، میتونید فاصلهی مربع اون رو با مجموعهی دادهی اصلی محاسبه کنید. بعد میتونید کرنل و هایپرپارامترهایی رو انتخاب کنید که این خطای پیش-تصویر بازسازی رو به حداقل برسونه.
ممکنه براتون سوال پیش بیاد که چطور این بازسازی رو انجام بدیم. یک راه آموزش یک مدل رگرسیون با استفاده از نمونههای تصویر شده بهعنوان مجموعهی دادهی آموزشی و نمونههای اصلی بهعنوان اهداف. اگر fit_inverse_transform=True قرار بدید، این کار بهصورت خودکار اتفاق میفته:
rbf_pca = KernelPCA(n_components = 2, kernel = "rbf", gamma=0.0433,
                     fit_inverse_transform = True)
X_reduced = rbf_pca.fit_transform(X)
X_preimage = rbf_pca.inverse_transform(X_reduced)
بهصورت دیفالت fit_inverse_transform=False هست و KernelPCA هیچ تابعی به نام inverse_transform نداره. این تابع فقط موقعی ایجاد میشه که fit_inverse_transform=True باشه.
میزان خطای پیش-تصویر بازسازی رو میتونید با کد زیر محاسبه کنید:
from sklearn.metrics import mean_squared_error

mean_squared_eror(X, X_preimage)
# 32.786308795766132
حالا میتونید از Grid Search با Cross-Validation استفاده کنید تا کرنل و هایپرپارامتری رو پیدا کنید که این خطا رو به حداقل میرسونه.
یک تکنیک غیرخطی قدرتمند دیگه برای کاهش بعد(NLDR)، Locally Linear Embedding(LLE) نام داره. این یک تکنیک Manifold Learning هست که برخلاف الگوریتمهای دیگه، متکی بر تصویر کردن نیست. بهطور خلاصه، LLE با اندازهگیری نحوهی ارتباط خطی هر نمونهی آموزشی با نزدیکترین همسایههای خود کار میکنه. سپس دنبال یک نمایش با ابعاد کم از نمونههای آموزشی هست که در اون روابط محلی به بهترین شکل حفظ میشود.
کد زیر از کلاس LocallyLinearEmbedding برای باز کردن Swiss Roll استفاده میکنه:
from sklearn.manifold import LocallyLinearEmbedding

lle = LocallyLinearEmbedding(n_component = 2, n_neighbors = 10)
X_reduced = lle.fit_transofrm(X)
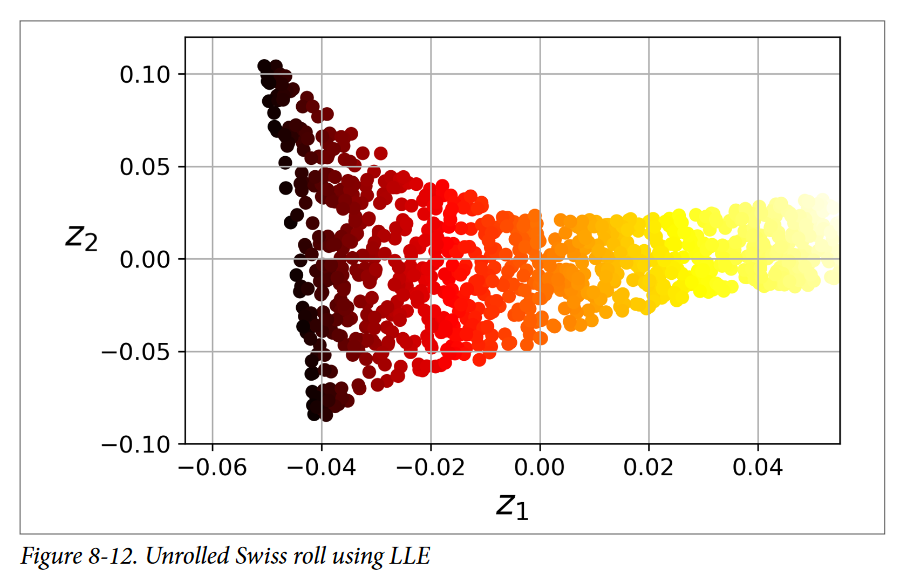
مجموعهی دادهی 2 بعدی به دست اومده رو در شکل 12-8 میبینید. همونطور که میبینید، این مجموعه داده کاملا باز شده و فاصلهی بین نمونهها بهصورت محلی به خوبی حفظ شده. اگرچه، فاصلهها در یک مقیاس بزرگتر حفظ نشدند: سمت چپ شکل کشیده شده در حالی که سمت راست فشرده شده. با این حال LLE در مدل کردن منیفلد عملکرد خوبی داشته.
طرز کار LLE به این صورت هست:برای هر نمونهی آموزشی x^(i)، الگوریتم k تا نزدیکترین همسایهها رو شناسایی میکنه ( در کد قبل این مقدار 10 بود ) بعد سعی میکنه x^(i) رو بهصورت یک تابع خطی از این همسایهها بازسازی کنه. بهطور دقیقتر، وزنهای w_i,j رو طوری پیدا میکنه که مربع فاصله بین x^(i) و سامیشن w_i,jx^(j) از j=1 تا m تا جای ممکن کوچیک باشه؛ با فرض اینکه w_i,j=0 ، اگر x^(j) یکی از k نزدیکترین همسایههای x^(i) نباشه. بهاین ترتیب اولین قدم LLE مسئلهی بهینهسازی محدود شدهای هست که در معادلهی 4-8 معرفی شده. در این معادله W ماتریس وزنی شامل تمام وزنهای w_i,j هست. دومین اعمال محدودیت، نرمال کردن تمام وزنها برای هر نمونهی آموزشی x^(i) هست.
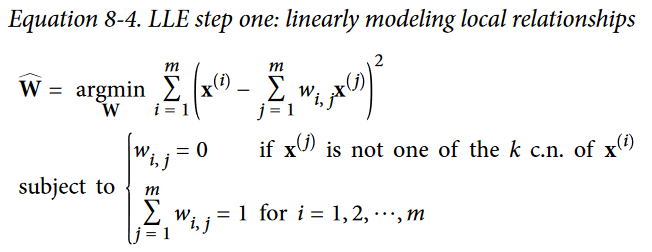
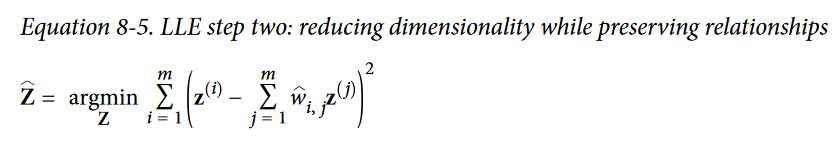
بعد از این قدم، ماتریس وزن W که شامل وزن های w_i,j هست، رابطههای خطی میان نمونههای آموزشی رو رمزگذاری میکنه. دومین قدم نگاشت نمونههای آموزشی به یک فضای d-بعدی هست ( d < n ) بهطوری که تا جای ممکن این روابط محلی حفظ بشن. اگر z^(i) تصویر x^(i) در این فضای d-بعدی باشه، آنگاه میخوایم که فاصلهی مربع بین z^(i) و سامیشن w_i,jz^(j) از j=1 تا m تاجای ممکن کوچیک باشه. این ایده به مسئلهی بهینهسازی بدون محدودیتی منتهی میشه که در تساوی 5-8 میبینید. شباهت زیادی داره به قدم اول اما بهجای اینکه نمونههارو ثابت نگه داریم و وزنهای مناسب رو پیدا کنیم، داریم برعکس این کار رو انجام میدیم: وزنهارو ثابت نگه میداریم و مکان مناسب تصویر نمونههارو در فضای با ابعاد کم پیدا میکنیم. دقت کنید که Z ماتریس شامل تمام z^(i) هاست.
پیادهسازی LLE در Scikit-Learn این پیچیدگی محاسباتی رو داره: O(mlog(m)n log(k)) برای پیدا کردن k تا نزدیک ترین همسایهها، O(mnk^3) برای بهینهسازی وزنها و O(dm^2) برای ساختن نمایشهای با ابعاد کم. متاسفانه m^2 باعث میشه که این الگوریتم عملکرد ضعیفی در مجموعهی دادههای بسیار بزرگ داشته باشه.
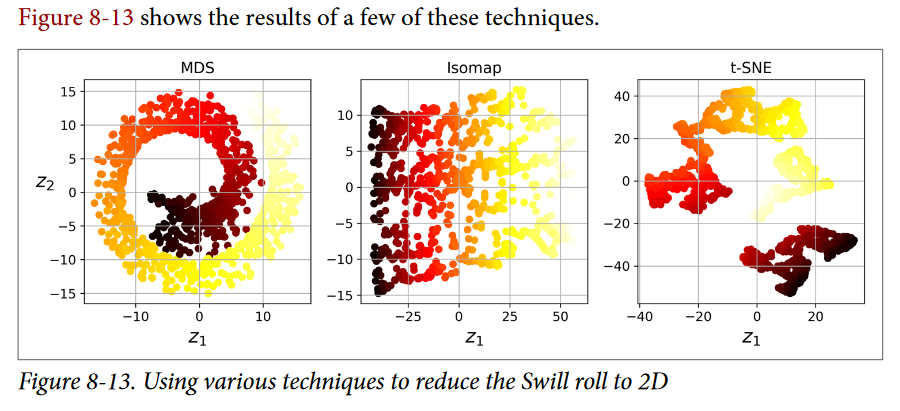
تعداد زیادی تکنیک برای کاهش بعد وجود داره که چندتایی هم در Scikit-Learn موجود هستند. در اینجا چندتا از محبوبترینهارو میبینید:
Random Projection:
همونطور که از اسم پیداست، با استفاده از یک تصویر خطی تصادفی، دادهها به یک فضای با بعد کم تصویر میشن. شاید عجیب باشه اما معلوم میشه که یک همچین تصویر تصادفیای به احتمال زیاد فاصلههارو بهخوبی حفظ میکنه؛ همونطور که William B. Johnson و Joram Lindenstrauss بهصورت ریاضی در یک لم معروف نشون دادند. کیفیت این کاهش بعد بسته به تعداد نمونهها و بعد مورد نظر داره اما بهطرز حیرت آوری به بعد اولیه بستگی نداره. میتونید داکیومنت sklearn.random_projection رو برای اطلاعات بیشتر مطالعه کنید.
Multidimensional Scaling (MDS):
این روش همزمان با حفظ فاصلهی بین نمونهها، بعد رو کاهش میده.
Isomap:
این روش با اتصال هر نمونه به نزدیکترین همسایه یک گراف درست میکنه و همزمان با حفظ فاصلهی ژئودزیک بین نمونهها، بعد رو کاهش میده.
t-Distributed Stochastic Neighbor Embedding (t-SNE):
این روش با کنار هم نگهداشتن نمونههای شبیه به هم و دور نگهداشتن نمونههای متفاوت از هم، بعد رو کاهش میده. این روش بیشتر برای مصورسازی کاربرد داره مخصوصا در مصورسازی خوشههایی از نمونهها در فضای با ابعاد بالا. ( برای مثال مصورسازی MNIST در 2 بعد )
Linear Discriminant Analysis (LDA):
یک الگوریتم طبقهبندی هست اما حین آموزش یادمیگیره که متمایزکنندهترین محورها رو بین کلاسها پیدا کنه. بعد از این محورها میشه استفاده کرد تا یک ابرصفحه برای تصویر داده تعریف کرد. خوبی این روش این هست که تصویر داده تا جای ممکن کلاس ها رو از هم دور خواهد کرد پس LDA یک تکنیک خوب برای کاهش بعد قبل از اجرای یک الگوریتم طبقهبندی مثل SVM هست.
در این تصویر نتیجهی هرکدوم از این روش ها رو میبینید.