با افزایش حجم دادهها در جهان، بهترین شیوهی یادگیری استفاده از الگوریتمهای یادگیری برخط است. روشهای برخط گروهی (Online Ensemble Methods) الگوریتمهایی هستند که از یک گروه طبقهبندی کننده (Classifier) برای پیشبینی استفاده میکنند. در یادگیری برخط گروهی، پیشبینی با استفاده از خبره (Expert)، مسئلهای است که بسیار مورد مطالعه قرار گرفته است. الگوریتمهای Weighted Majority و Randomized Weighted Majority از معروفترین راهحلها برای این مسئله هستند که هدف آنها همگرایی به نظر بهترین خبره است. در میان خبرگان، آنهایی که عملکرد عالیای دارند لزوماً در تمام مناطق فضای داده کمترین میزان خطا را ندارند؛ در نتیجه باید مناطق خاصی را تعریف کنیم و در هر یک از این مناطق، به خبرهای رجوع کنیم که بهترین عملکرد را دارد. در این مقاله میخواهیم این نقص الگوریتمهای RWM را با ارائه یک نسخهی آبشاری/دنبالهای حل کنیم. Cascading RWM نه تنها عملکرد خوبی دارد بلکه در دیتاستهای بسیار بزرگ هم مقدار خطای کمی دارد.
این مطلب فقط قسمتهایی از مقالهی Cascading Randomized Weighted Majority را پوشش میدهد. برای مطالعهی بیشتر به لینک مقاله مراجعه کنید.
در الگوریتمهای یادگیری با نظارت، دادهها از قبل لیبلگذاری شدهاند. در این الگوریتمها هر نمونه یک لیبل دارد که نشاندهندهی کلاسی است که آن داده متعلق به آن است. در یادگیری با نظارت هدف این است که یک فرضیهی کلی از تعدادی نمونهی لیبلشده به منظور پیشبینی استخراج کنیم. هر الگوریتم از تعدادی فرض استفاده میکند؛ در نتیجه در بعضی از زمینهها خوب عمل میکند و در بعضی دیگر عملکرد مناسبی ندارد. در نتیجه، برای افزایش عملکرد دستهبندی، Classifier هارا با هم ترکیب میکنیم. چارچوب پیشبینی با خبره سعی میکند در میان دستهای از خبرگان، به آنهایی همگرا شود که کمترین میزان خطا یا Misclassification را دارد. این مفهوم در ماشین لرنینگ بسیار مورد مطالعه قرار گرفته است و توجههای زیادی را به خود جلب کرده است.
در بسیاری از زمینهها، الگوریتمهای گروهی عملکرد بسیار خوبی دارند؛ برای مثال در تشخیص اسپم، نفوذ و ردیابی اشیاء. از روشهای گروهی معروف میتوان به Bagging و Boosting اشاره کرد. این روشها از ترکیب تعدادی مدل ضعیف استفاده میکنند تا عملکرد کلی مدل را افزایش دهند. روشهای برخطی مثل Online Bagging و Online Boosting در مواقعی کاربرد دارند که تمام دیتاست در حافظه جای نمیگیرد یا ماهیت دادهها جریانی است. اگرچه الگوریتمهای اشاره شده از تعدادی مدل ضعیف تشکیل شدهاند اما آنها هر مدل را برای ناحیهای از دادهها انتخاب میکنند که آن مدل در آن ناحیه خبره محسوب میشود.
در پیشبینی با نظر خبرگان، هدف این است که لیبل یک نمونه را با خطایی نزدیک به بهترین خبره پیشبینی کنیم. یک راه حل ساده برای این مسئله نصفکردن (Halving) است. Weighted Majority و Randomized Weighted Majority معروفترین راه حل ها برای این مسئله هستند. اساس این الگوریتم ها نصفکردن (Halving) است اما بسته به تعداد خبرگان و میزان خطای بهترین خبره، کران خطای بهتری دارند. یک راه حل دیگر برای این مسئله Exponential Weighted Average است که اساس آن شبیه به RWM است. در RWM از تابع هزینهای استفاده میکنیم که فقط شامل 0 و 1 است ولی در EWA از تابع هزینهی محدبی استفاده میکنیم (Convex Function)
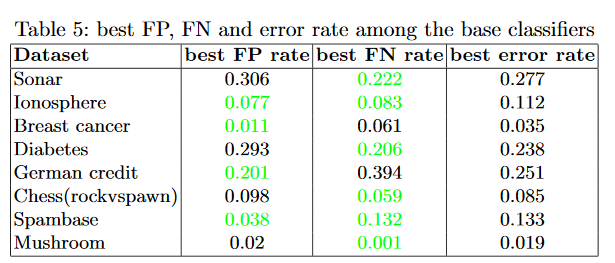
اساس تمام الگوریتمهای اشاره شده، تعریف بهترین خبره است. بهترین خبره خبرهای است که میانگین خطای کمتری در طول آزمایش داشته باشد. بههمین دلیل، بهترین خبره لزوما هم بیشترین میزان منفی واقعی و مثبت واقعی را ندارد. (برای مطالعه بیشتر درباره True Positive Rate و True Negative Rate کلیک کنید). آزمایشهای انجام شده نشان میدهند که پیدا کردن بهترین Classifier برای هر ناحیه بهصورت جداگانه و پیشبینی بر اساس آنها، عملکرد کلی طبقهبندی را افزایش میدهد.
در این مطلب یک راه ساده و کارا برای پیدا کردن خبرگان ارائه شده است. این خبرگان کمترین False Positive و False Negative را دارند. روش ارائه شده Cascading Randomized Weighted Majority یا CRWM نام دارد و نسخهی آبشاری/دنبالهای RWM است.
در تقریباً تمام الگوریتمهای یادگیری برخط برای طبقهبندی، یک سناریوی کلی وجود دارد که از این بخشها تشکیل شده است: در ابتدا یک نمونه به یادگیرنده داده میشود، یادگیرنده یک لیبل را به آن اختصاص میدهد و در نهایت لیبل صحیح آن نمونه به یادگیرنده داده میشود. یادگیرنده این نمونه لیبل شده را یاد میگیرد تا عملکرد را افزایش دهد. در ادامه، پیشبینی با استفاده از رای خبرگان را معرفی خواهیم کرد که سناریویی شبیه به این دارد.
برای شهود بهتر این مثال را در نظر بگیرید. یک الگوریتم یادگیرنده وظیفه حدس زدن آبوهوای هر روز را دارد؛ باید بگوید امروز باران میبارد یا نه. برای انجام این پیشبینی، نظر چندین خبره به الگوریتم داده میشود. هر روز هر خبره بله یا خیر میگوید و الگوریتم یادگیرنده باید این اطلاعات را بهکار ببرد تا پیشبینی نهایی را درباره آبوهوا انجام دهد. بعد از انجام پیشبینی، به الگوریتم گفته میشود که امروز هوا چگونه بود. حالت خوب این است که یادگیرنده بتواند تشخیص بدهد کدام خبره بهترین است و نظر بهترین خبره را بهعنوان خروجی پیشبینی کند. از آنجایی که ما نمیدانیم کدام خبره بهترین است، در عوض هدف ما تا اینجا این است که تا جای ممکن عملکردی نزدیک به عملکرد بهترین خبره داشته باشیم. این یعنی یک یادگیرنده خوب باید تضمین کند که در هیچ زمانی، عملکردی بدتر از هیچکدام از خبرگان ندارد. یک الگوریتم که بتواند این مشکل را حل کند، شامل این مراحل است: اول پیشبینیهای خبره را دریافت میکند، دوم پیشبینیهای خود را انجام میدهد و سوم پاسخ درست به آن گفته میشود.
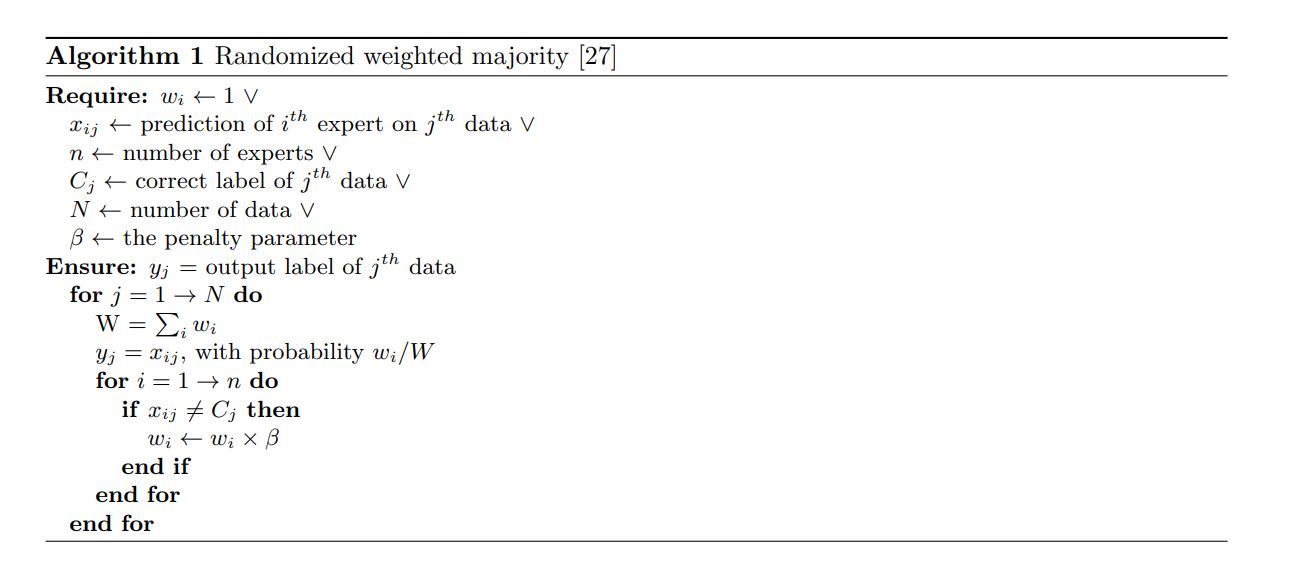
الگوریتم اکثریت وزندار و نسخه تصادفی آن، مشهورترین راهحل برای پیشبینی با نظر خبرگان است. RWM از چند Classifier پایه تشکیل شده است (همان خبرگان) و هر Classifier یک فاکتور وزن دارد. هر بار که یک نمونه جدید دریافت میشود، هرکدام از آن Classifierها یک لیبل را برای آن نمونه پیشبینی میکند و الگوریتم بر اساس این پیشبینیها و وزن هر Classifier، یک لیبل را انتخاب میکند. هر زمان که الگوریتم لیبل درست آن نمونه را دریافت میکند، فاکتور وزن هر Classifier باید طوری تغییر کند که اگر یک Classifier غلط پیشبینی کرده است با یک ضریب ثابت جریمه شود. ثابت شده است که این الگوریتم در میان همهی خبرگان، به بهترین خبره همگرا میشود. شبهکد این الگوریتم را میتوانید ببینید:
نشان داده شده است که تعداد اشتباهاتی که انتظار میرود این الگوریتم انجام بدهد در این نامساوی صدق میکند:
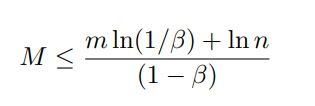
که در آن m تعداد اشتباههایی است که بهترین خبره تا بهاینجای کار انجام داده است و بتا یک مقدار ثابت برای جریمه است.
وقتی حجم دادهها زیاد است، الگوریتم RWM بر اساس نظر بهترین خبره، پیشبینی میکند. این الگوریتم به زمان زیادی احتیاج دارد تا به بهترین خبره همگرا شود و یادگیرنده ممکن است نسبت به بهترین خبره، اشتباهات بیشتری انجام دهد. اگرچه، وقتی بهترین خبره توسط یادگیرنده پیدا میشود، باید مطمئن شویم که تعداد اشتباهات الگوریتم بیشتر از بهترین خبره نیست و باید بتوانیم بگوییم که از حالا به بعد همان چیزی را پیشبینی میکند که بهترین خبره میگوید.
در این بخش یک الگوریتم یادگیری برخط معرفی میکنیم که ایده اصلی آن، معرفی بیش از یک خبره است؛ برای هر دسته از دادهها، یک خبره. در واقع این الگوریتم سعی میکند که بهترین خبرهها را پیدا کند و برای هر نمونه جدید تصمیم بگیرد که کدام خبره مناسبتر است و بر اساس نظر آن خبره پیشبینی کند.
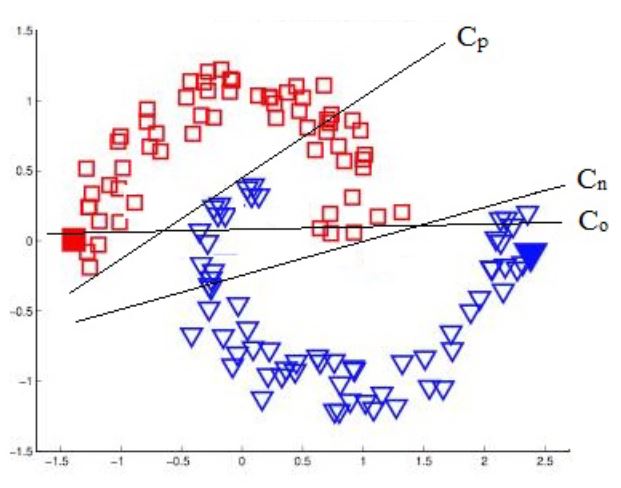
هر خبره در واقع یک Classifier است. بعد از مطالعهی Classifierهای متعدد، مشاهده شد که آنها معمولا همزمان هم FP و هم FN کم ندارند. شکلی که در زیر میبینید یک دیتاست با دو کلاس را به همراه سه Classifier نشان میدهد. اگرچه C_0 کمترین مقدار خطا را دارد اما FP و FN آن در میان سه Classifier بهترین نیست. همانطور که در شکل نشان داده شده است، C_p مقدار FP کمتری نسبت به C_0 و C_n مقدار FN کمتری نسبت به C_0 دارد. در نتیجه، بهجای اینکه بهدنبال خبرهای با کمترین میزان خطا باشیم، به دنبال خبرهای با کمترین FP و FN میگردیم.
هدف الگوریتم WM ، پیدا کردن بهترین خبره در یک گروه از Classifierهای برخط است؛ اما پیدا کردن بهترین خبرهی مثبت و بهترین خبرهی منفی، بهطور همزمان همچنان یک مشکل است و برای حل آن، راه حل زیر را ارائه میدهیم.
همانطور که در شکل زیر میبینید، الگوریتم ارائه شده n Classifier و سه یادگیرنده با مکانیسم RWM دارد که از این Classifierها استفاده میکند. به عبارت دیگر، برای هر یادگیرنده n فاکتور وزن وجود دارد یعنی n × 3. برای هر نمونه جدید، هر کدام از این n Classifier ها یک لیبل را پیشبینی میکنند. با استفاده از فاکتورهای وزن، این پیشبینیها به یادگیرندهها داده میشود تا آنها هم پیشبینی خود را کنند. از آنجایی که الگوریتم اول وظیفه پیشبینی لیبلهای منفی را دارد، اگر این الگوریتم لیبل را منفی پیشبینی کند آنگاه لیبل منفی در نظر گرفته میشود؛ در غیر این صورت الگوریتم دوم به کار گرفته میشود.اگر الگوریتم دوم لیبل را مثبت پیشبینی کند آنگاه لیبل خروجی مثبت خواهد بود؛ در غیر این صورت الگوریتم سوم به کار گرفته میشود و لیبل پیشبینی این الگوریتم لیبل خروجی برای آن نمونه خواهد بود.
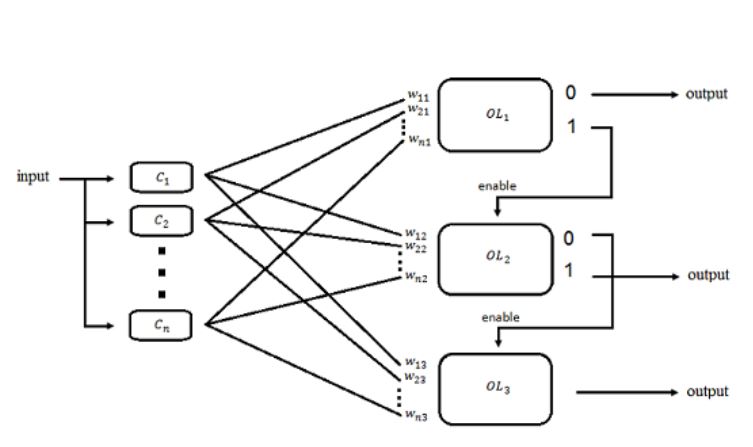
اگرچه این سناریو برای دیتاست با دو کلاس گفته شد اما برای دیتاستهای چندکلاسی هم صادق است. برای یک دیتاست چندکلاسی، الگوریتم همچنان از n Classifier استفاده خواهد کرد اما به L + 1 یادگیرنده احتیاج خواهد داشت که L تعداد کلاسهای متفاوت است؛ برای هر کلاس یک یادگیرنده + یک یادگیرنده نهایی. پس در یک دیتاست با L کلاس ، الگوریتم به n × (L + 1) فاکتور وزن احتیاج خواهد داشت. باقی الگوریتم، مانند الگوریتم برای دیتاست دوکلاسی است.
هرگاه لیبل صحیح یک نمونه دریافت شود، این لیبل صحیح فقط به یادگیرندهای داده خواهد شد که لیبل خروجی را تولید میکنید. در نتیجه برای هر نمونه جدید، فاکتورهای وزن فقط یک یادگیرنده میتواند بهروزرسانی شود. از آنجایی که یادگیرندهها از مکانیسم RWM استفاده میکنند، فاکتور وزن Classifier ای که پیشبینی اشتباهی انجام داده بود، بهوسیله ثابت بتا جریمه میشود. الگوریتم CRWM از سه یادگیرندهی RWM در سه مرحله استفاده میکند و با توجه به ساختار آبشاری/دنبالهای آن، Cascading Randomized Weighted Majority نامگذاری شده است.
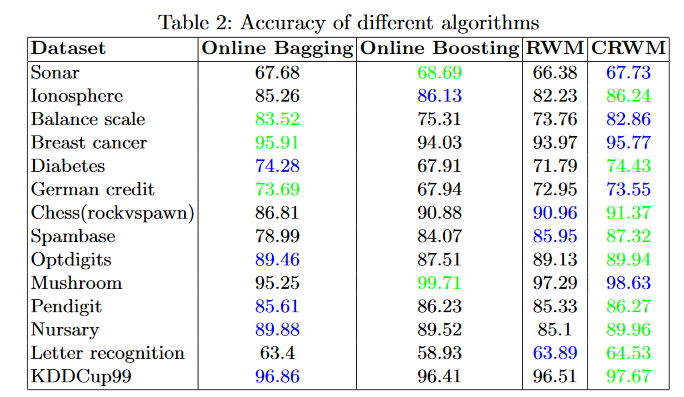
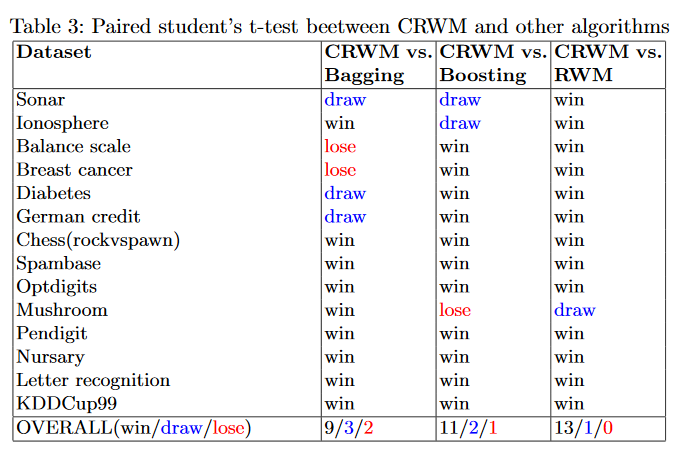
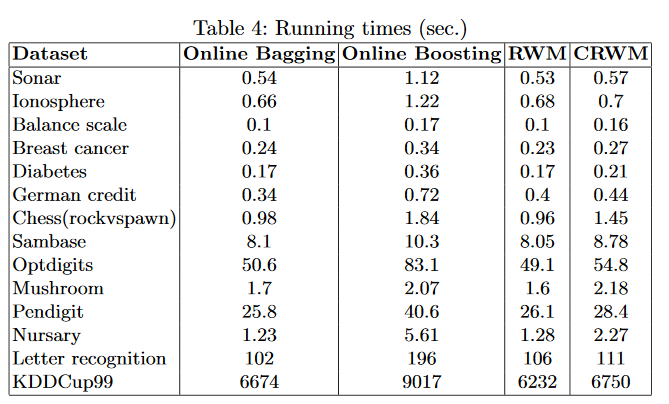
در تصاویر زیر میتوانید عملکرد این الگوریتم را مشاهده کنید.