
برای چی از Regularization در دیپ لیرنینگ استفاده میکنیم؟ جواب خیلی ساده است. Regularization ها برای جلوگیری از Overfitting در مدل های Machen Learning و Deep Learning استفاده میشود. خب الان ما یک مفهوم اضافه Overfitting کنار Regularization داریم.
خب Overfitting چیه؟ قبل از نشون دادن مدل نموداری و ریاضی یک مثال از دنیای واقعی مطرح کنم. تصور کنید که شما در ایران به دنیا آمدید و هیچ ارتباطی با دنیای خارج به هیچوجه ندارید. از نظر شما در چنین شرایطی همه انسانهای ایرانی هستند. مدل تفکر شما در واقع همه انسان ها را ایرانی میدونه! در حالیکه در دنیای خارج انسان هایی وجود دارند که ژاپنی، اروپایی، روسیه ای و غیره میتونند باشند. در چنین شرایطی میتونیم بگیم که مدل فکر ما دچار Overfitting شده. چرا؟ چون ما تنها با داده های کشور ایران همه انسان ها را ایرانی میدونستیم ولی وقتی این مدل فکری را در همه دنیا تست کردیم، فهمیدیم همه انسان ها ایرانی نیستند. این مثال مفهوم پایه ای Overfitting را واسه ما شرح میده. خب برای این حل مسئله ی Overfitting چه کار میتونیم انجام بدیم؟ ساده ترین راهحلی که به نظر میاد اینه که در مدل فکری ما، چند عدد انسان غیرایرانی مثل ژاپنی و روسیه ای و اروپایی و غیره اضافه کنیم. با اضافه کردن این انسان ها به مدل فکری، ما میتونیم مسئله Overfitting را حل کنیم.
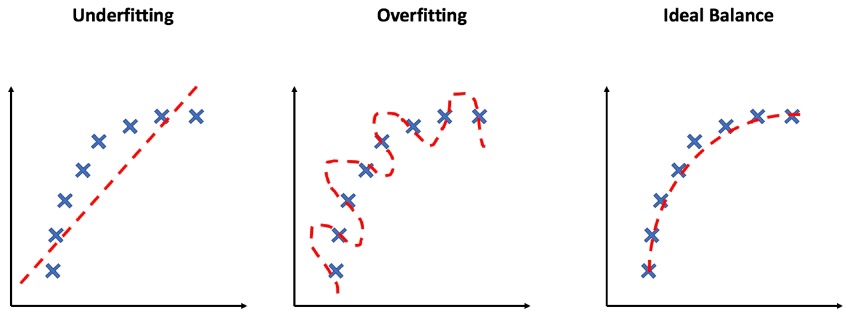
حالا بیایم در مدل ریاضی ببینیم Overfitting چگونه مطرح میشود( همان معنای مثال بالارو میده ولی خب با زبان انتزاع ریاضی). نمودار پایین یک نمودار Overfitting است خطر نمودار سعی کرده به شکل دقیق روی داده ها قرار بگیره. در دنیای واقعی همچین مدلی به درد ما نمیخوره. بنابراین ما با اضافه کردن «نویز» یا «همون انسان های غیرایرانی» سعی میکنیم مدل را از Overfitting رها کنیم! برای اینکار ما از روش های L1 و L2 , Dropout استفاده میکنیم که در مدل های Deep Learning همانند ANN استفاده میشود.
نوع اول : Regularization L1 L2
از نظر محاسبات ریاضی این دو با هم تفاوت دارند ولی در این نوشته قصد وارد شدن به مباحث ریاضی نیستم و مهم کاربرد و درک کاربردی از مسئله است. ما از این دو Regularization استفاده میکنیم که مسئله Overfitting را حل کنیم ولی خب این دو چرا به درد ما میخورند؟
وقتی از L2 استفاده میکنیم این تکنیک باعث میشود Weight Value ما متمایل به صفر شود البته صفر نمیشود و هنگامی که از L1استفاده میکنیم باعث میشود که Weight ٰValue به صفر تمایل پیدا کند. این دو گزاره پایه اصلی این دو تکنیک است. خب مسلما بهتره وارد جزییات ریاضی این مفهوم بشید ولی با یادگرفتن مفهوم این دو تکنیک در دنیای واقعی ( همون مثال ایرانی ها از انسان!)
نوع دوم: Dropout
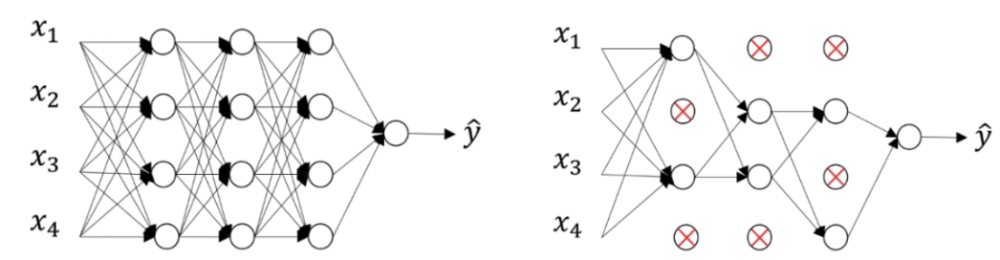
برای درک این روش فک کنم کافی باشه به عکس پایین نگاه کنید همونطور که میبینید در این روش مدل در هریک از لایه ها نودهایی را حذف میکنه این باعث میشه که مدل از Overfitting رها بشه!
من در زمینه یادگیری عمیق، کاربرد هوش مصنوعی یادگیری ماشین و یادگیری عمیق در علوم اجتماعی، فلسفه هوش مصنوعی،زبان و جامعه کار میکنم. برام کامنت بذارید اگه به این مباحث علاقه دارید.

