پردازش زبان طبیعی تلاش میکند ماشینهایی بسازد که متن یا دادههای صوتی را بفهمند و به آنها پاسخ دهند و با متن یا گفتار خودشان پاسخ دهند. تقریباً به همان روشی که انسانها انجام میدهند.
پردازش زبان طبیعی چیست؟
پردازش زبان طبیعی (NLP) به شاخه ای از علوم کامپیوتر و به طور خاص تر، شاخه هوش مصنوعی یا AI اشاره دارد که به رایانه ها توانایی درک متن و کلمات گفتاری را به همان روشی که انسان می تواند انجام می دهد، مربوط می شود.
ان ال پی NLP زبانشناسی محاسباتی مدلسازی مبتنی بر قواعد زبان انسانی را با مدلهای آماری، یادگیری ماشینی و یادگیری عمیق ترکیب میکند. این فناوریها با هم، رایانهها را قادر میسازند تا زبان انسان را در قالب متن یا دادههای صوتی پردازش کنند و معنای کامل آن را با هدف و احساسات گوینده یا نویسنده «درک» کنند.
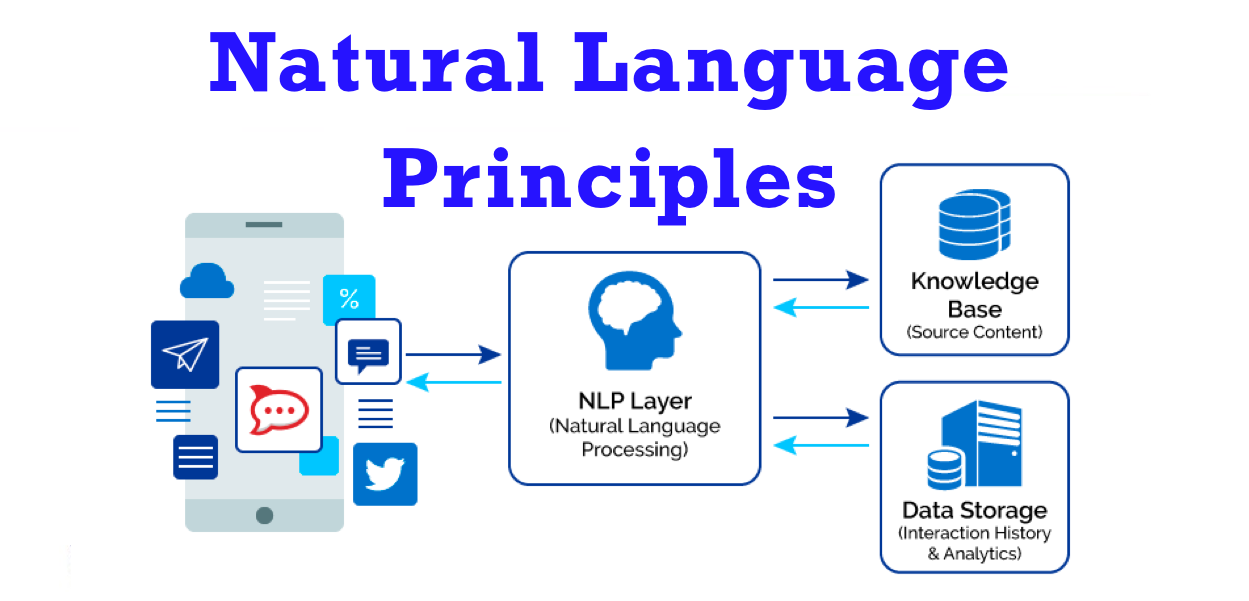
ان ال پی NLP برنامههای کامپیوتری را هدایت میکند که متن را از یک زبان به زبان دیگر ترجمه میکنند، به دستورات گفتاری پاسخ میدهند و حجم زیادی از متن را به سرعت خلاصه میکنند حتی در زمان واقعی. احتمال زیادی وجود دارد که با NLP به شکل سیستمهای جیپیاس صدادار، دستیارهای دیجیتال، نرمافزار دیکته گفتار به متن، چترباتهای خدمات مشتری و سایر امکانات رفاهی مصرفکننده تعامل داشته باشید. اما NLP همچنین نقش رو به رشدی در راهحلهای سازمانی ایفا میکند که به سادهسازی عملیات تجاری، افزایش بهرهوری کارکنان و سادهسازی فرآیندهای کسبوکار حیاتی کمک میکند.
وظایف NLP - پردازش زبان های طبیعی - مهدی مشایخی
وظایف NLP
زبان انسان مملو از ابهاماتی است که نوشتن نرم افزاری را که دقیقاً معنای متن یا داده های صوتی را تعیین می کند، بسیار دشوار می کند. همنام ها، هم آواها، کنایه ها، اصطلاحات، استعاره ها، گرامر و استثناهای کاربرد، تغییرات در ساختار جملات اینها تنها تعداد کمی از بی نظمی های زبان انسانی هستند که یادگیری آن سال ها طول می کشد، اما برنامه نویسان باید برنامه های کاربردی مبتنی بر زبان طبیعی را آموزش دهند تا تشخیص دهند و از همان ابتدا به درستی درک کنید که آیا آن برنامه ها قرار است مفید باشند.
چندین کار NLP متن و دادههای صوتی انسان را به روشهایی تجزیه میکنند که به رایانه کمک میکند تا آنچه را که بلعیده است درک کند. برخی از این وظایف شامل موارد زیر است:
تشخیص گفتار که گفتار به متن نیز نامیده می شود، وظیفه تبدیل مطمئن داده های صوتی به داده های متنی است. تشخیص گفتار برای هر برنامهای که از دستورات صوتی پیروی میکند یا به سؤالات گفتاری پاسخ میدهد، لازم است. چیزی که تشخیص گفتار را بهویژه چالشبرانگیز میکند، نحوه صحبت کردن افراد است سریع، لغزش کلمات با هم، با تأکید و لحن مختلف، با لهجههای مختلف و اغلب با استفاده از دستور زبان نادرست.
بخشی از برچسبگذاری گفتار که برچسبگذاری گرامری نیز نامیده میشود، فرآیند تعیین بخشی از گفتار یک کلمه یا قطعه متن خاص بر اساس کاربرد و زمینه آن است. بخشی از گفتار «ساختن» را به عنوان یک فعل در «من می توانم یک هواپیمای کاغذی بسازم» و به عنوان اسم در «ماشین چه مدلی دارید؟» مشخص می کند.
ابهامزدایی از معنای کلمه، انتخاب معنای یک کلمه با معانی چندگانه از طریق فرآیند تحلیل معنایی است که کلمهای را که بیشترین معنا را در زمینه داده شده تعیین میکند، تعیین میکند. برای مثال، ابهامزدایی از معنای کلمه کمک میکند تا معنای فعل «ساختن» را در «نمرهسازی» (بهدست آوردن) در مقابل «شرطبندی» (مکان) تشخیص دهد.
شناسایی موجودیت نامگذاری شده یا NEM، کلمات یا عبارات را به عنوان موجودیت های مفید شناسایی می کند. NEM "کنتاکی" را به عنوان یک مکان یا "فرد" را به عنوان نام یک مرد شناسایی می کند.
رزولوشن همارجاع وظیفه شناسایی این است که آیا و چه زمانی دو کلمه به یک موجودیت اشاره میکنند. رایج ترین مثال، تعیین شخص یا شیئی است که یک ضمیر معین به آن اشاره دارد (مثلاً «او» = «مریم»)، اما می تواند شامل شناسایی یک استعاره یا یک اصطلاح در متن نیز باشد (مثلاً مثالی که در آن « خرس یک حیوان نیست بلکه یک فرد پر مو است).
تجزیه و تحلیل احساسات سعی می کند کیفیت های ذهنی - نگرش ها، احساسات، کنایه، سردرگمی، سوء ظن را از متن استخراج کند.
تولید زبان طبیعی گاهی اوقات به عنوان مخالف تشخیص گفتار یا گفتار به متن توصیف می شود. این وظیفه قرار دادن اطلاعات ساختاریافته به زبان انسان است.
ابزارها و رویکردهای NLP - پردازش زبان های طبیعی - مهدی مشایخی
ابزارها و رویکردهای NLP
زبان برنامه نویسی پایتون طیف وسیعی از ابزارها و کتابخانه ها را برای حمله به وظایف خاص NLP فراهم می کند. بسیاری از این موارد در Natural Language Toolkit یا NLTK، مجموعه ای منبع باز از کتابخانه ها، برنامه ها و منابع آموزشی برای ساخت برنامه های NLP یافت می شوند.
ان ال تی کی (NLTK) شامل کتابخانههایی برای بسیاری از وظایف NLP ذکر شده در بالا، به علاوه کتابخانههایی برای وظایف فرعی، مانند تجزیه جملات، تقسیمبندی کلمات، ریشهگذاری و واژهسازی (روشهای کوتاه کردن کلمات تا ریشه آنها) و نشانهسازی (برای شکستن عبارات، جملات، پاراگرافها) است. و قسمت هایی به نشانه هایی که به کامپیوتر کمک می کند متن را بهتر درک کند). همچنین شامل کتابخانههایی برای پیادهسازی قابلیتهایی مانند استدلال معنایی، توانایی رسیدن به نتایج منطقی بر اساس حقایق استخراجشده از متن است.
ان ال پیNLP آماری، یادگیری ماشینی و یادگیری عمیق
اولین برنامههای NLP، سیستمهای مبتنی بر قواعد و کدگذاری دستی بودند که میتوانستند وظایف NLP خاصی را انجام دهند، اما نمیتوانستند به راحتی مقیاس شوند تا جریان به ظاهر بیپایانی از استثناها یا حجم فزاینده متن و دادههای صوتی را در خود جای دهند.
ان ال پی NLP آماری را وارد کنید، که الگوریتمهای کامپیوتری را با مدلهای یادگیری ماشینی و یادگیری عمیق ترکیب میکند تا به طور خودکار عناصر متن و دادههای صوتی را استخراج، طبقهبندی و برچسبگذاری کند و سپس احتمال آماری را به هر معنای احتمالی آن عناصر اختصاص دهد. امروزه، مدلهای یادگیری عمیق و تکنیکهای یادگیری مبتنی بر شبکههای عصبی کانولوشن (CNN) و شبکههای عصبی مکرر (RNN) سیستمهای NLP را قادر میسازند که در حین کار، «یاد بگیرند» و معنای دقیقتری را از حجم عظیمی از متن خام، بدون ساختار و بدون برچسب استخراج کنند.
موارد استفاده از NLP - پردازش زبان های طبیعی - مهدی مشایخی
موارد استفاده از NLP
پردازش زبان طبیعی نیروی محرکه پشت هوش ماشینی در بسیاری از کاربردهای دنیای واقعی مدرن است. در اینجا چند نمونه هستند:
تشخیص اسپم: ممکن است تشخیص هرزنامه را به عنوان یک راه حل NLP در نظر نگیرید، اما بهترین فناوری های تشخیص هرزنامه از قابلیت های طبقهبندی متن NLP برای اسکن ایمیل ها برای یافتن زبانی استفاده می کنند که اغلب نشان دهنده هرزنامه یا فیشینگ است. این شاخصها میتوانند شامل استفاده بیش از حد از اصطلاحات مالی، گرامر بد مشخصه، زبان تهدید، فوریت نامناسب، نامهای شرکتها و غیره باشد. تشخیص هرزنامه یکی از معدود مشکلات NLP است که کارشناسان آن را "بیشتر حل شده" میدانند (اگرچه ممکن است استدلال کنید که این با تجربه ایمیل شما مطابقت ندارد).
ترجمه ماشینی: Google Translate نمونه ای از فناوری NLP به طور گسترده در دسترس در محل کار است. ترجمه ماشینی واقعاً مفید بیش از جایگزینی کلمات در یک زبان با کلمات زبان دیگر است. ترجمه مؤثر باید معنی و لحن زبان ورودی را به دقت دریافت کند و آن را به متنی با همان معنا و تأثیر دلخواه در زبان خروجی ترجمه کند. ابزارهای ترجمه ماشینی از نظر دقت پیشرفت خوبی دارند. یک راه عالی برای آزمایش هر ابزار ترجمه ماشینی، ترجمه متن به یک زبان و سپس بازگشت به اصل است. یک مثال کلاسیک که اغلب ذکر شده است: چندی پیش، ترجمه « روح میخواهد، اما گوشت ضعیف است» از انگلیسی به روسی و برگردانده شد: « ودکا خوب است اما گوشت گندیده است»." امروز، نتیجه « روح میخواهد، اما جسم ضعیف است » است، که کامل نیست، اما اعتماد بسیار بیشتری را در ترجمه انگلیسی به روسی القا میکند.
عوامل مجازی و رباتهای گفتگو: عوامل مجازی مانند سیری اپل و الکسای آمازون از تشخیص گفتار برای تشخیص الگوهای دستورات صوتی و تولید زبان طبیعی استفاده میکنند تا با اقدامات مناسب یا نظرات مفید پاسخ دهند. چت بات ها در پاسخ به نوشته های متنی تایپ شده همان جادو را انجام می دهند. بهترین آنها همچنین یاد می گیرند که سرنخ های متنی در مورد درخواست های انسانی را تشخیص دهند و از آنها برای ارائه پاسخ ها یا گزینه های بهتر در طول زمان استفاده کنند. پیشرفت بعدی برای این برنامه ها پاسخگویی به سؤالات است، توانایی پاسخگویی به سؤالات ما - پیش بینی شده یا نه - با پاسخ های مرتبط و مفید به قول خودشان.
تجزیه و تحلیل احساسات رسانه های اجتماعی: NLP به یک ابزار تجاری ضروری برای کشف بینش داده های پنهان از کانال های رسانه های اجتماعی تبدیل شده است. تجزیه و تحلیل احساسات میتواند زبان مورد استفاده در پستهای رسانههای اجتماعی، پاسخها، بررسیها و موارد دیگر را برای استخراج نگرشها و احساسات در پاسخ به محصولات، تبلیغات و رویدادها تجزیه و تحلیل کند - شرکتها میتوانند اطلاعاتی را در طراحی محصول، کمپینهای تبلیغاتی و موارد دیگر استفاده کنند.
خلاصهسازی متن: خلاصهسازی متن از تکنیکهای NLP برای هضم حجم عظیمی از متن دیجیتالی و ایجاد خلاصهها و خلاصههایی برای نمایهها، پایگاههای اطلاعاتی پژوهشی یا خوانندگان پرمشغلهای که وقت خواندن متن کامل را ندارند، استفاده میکند. بهترین برنامههای خلاصهسازی متن از استدلال معنایی و تولید زبان طبیعی (NLG) برای افزودن زمینه و نتیجهگیری مفید به خلاصهها استفاده میکنند.
ممنون که تا انتهایی مقاله با ما همراه بودید. خوشحال میشم نظرات ، سوالات و انتقادات خود را با ما به اشتراک بذارید :)
مهدی مشایخی هستم. برنامه نویس هوش مصنوعی و پایتون در زمینه یادگیری ماشینی و عمیق. به همه کمک میکنم تا با هم رشد کنیم! من در توییتر: https://twitter.com/Mashayekhi_AI