
تصور کنید یک مدل هوش مصنوعی داشته باشیم که نهتنها یک کار خاص را انجام میدهد، بلکه یاد میگیرد که چگونه بهطور مؤثرتر و سریعتر یاد بگیرد. این ایده، پایه و اساس متالرنینگ است؛ شاخهای پیشرفته از یادگیری ماشین که به جای حل مستقیم یک مسئله، روی سازگاری سریع و مؤثر با مسائل جدید تمرکز میکند. در متالرنینگ، مدل از تجربههای گذشته خود استفاده میکند تا حتی با دادههای محدود، بتواند تصمیمات دقیق و هوشمندانه بگیرد و با هر مواجههٔ جدید، تواناییهای یادگیریاش را بهبود بخشد.
به زبان ساده، متالرنینگ به مدلها آموزش میدهد که از «متادیتا» (اطلاعاتی که دربارهٔ تجربهٔ یادگیری خود و سایر مدلها دارند) استفاده کنند تا انعطافپذیرتر شوند. این انعطافپذیری به مدل اجازه میدهد که حتی وقتی با دادهها یا وظایف کاملا جدید روبرو میشود، سریعتر و دقیقتر عمل کند.
متالرنینگ، یا یادگیری یادگیری (Learning to learn)، شاخهای از یادگیری ماشین است که هدف آن آموزش مدلها برای یادگیری مؤثرتر است.
در این رویکرد، الگوریتمها نه فقط از دادههای خام، بلکه از متادیتا نیز استفاده میکنند. هدف اصلی این است که الگوریتم بتواند انعطافپذیر باشد، یعنی وقتی با مسئله یا داده جدید روبرو میشود، سریعتر و دقیقتر عمل کند. به همین دلیل، به این روش گاهی «یادگیری برای یادگیری» (learning to learn) هم گفته میشود.
اهمیت انعطافپذیری در این است که هر الگوریتم یادگیری بر اساس فرضهایی دربارهٔ دادهها ساخته شده که به آن سوگیری استنتاجی (inductive bias) میگوییم. اگر سوگیری الگوریتم با مسئله همخوانی نداشته باشد، عملکرد خوبی نخواهد داشت. به عبارت دیگر، ممکن است الگوریتم در یک مسئله عالی عمل کند اما در مسئلهٔ دیگر ضعیف باشد.
در متالِرنینگ، فرآیند یادگیری به دو مرحله اصلی تقسیم میشود: meta-training و meta-testing. در مرحله meta-training، مدل روی مجموعهای از تسکها و دادههای متنوع آموزش میبیند تا الگوهای مشترک میان آنها را شناسایی کند و «یاد بگیرد چگونه یاد بگیرد». هدف این است که مدل با تسکهای جدید سریعتر و دقیقتر سازگار شود. مرحله meta-testing، مرحله ارزیابی است که در آن عملکرد مدل روی تسکهای کاملا جدید سنجیده میشود؛ به عبارت دیگر، مدل باید نشان دهد که با دادههایی که قبلا ندیده است، چقدر میتواند سریع و درست یاد بگیرد و تصمیمگیری کند. این دو مرحله با هم، توانایی مدل در یادگیری انعطافپذیر و تطبیقی را تضمین میکنند.
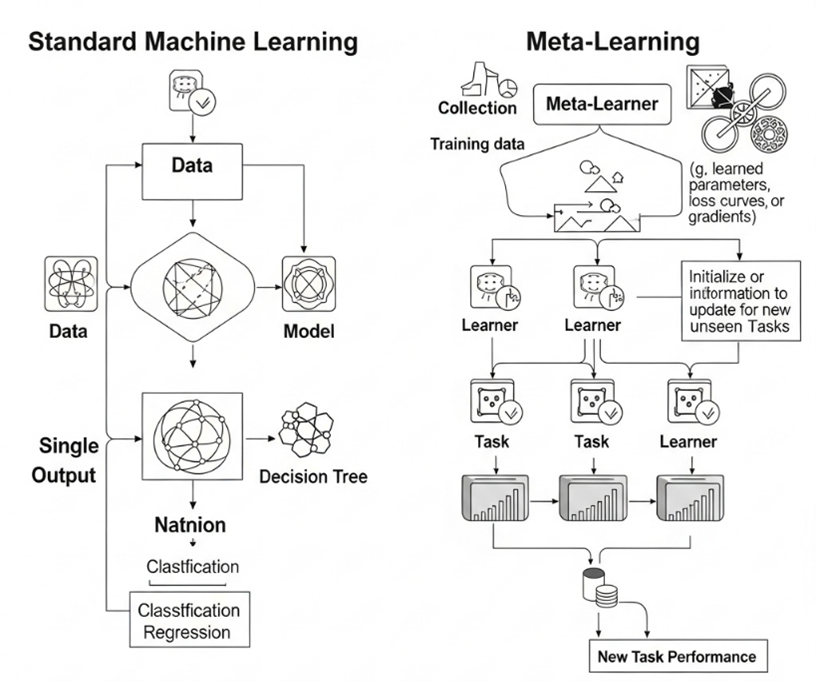
تصور کنید یک دانشگاه بزرگ داریم که چند استاد با تخصصهای مختلف در آن فعالیت میکنند. هر استاد معیارهای خودش را برای ارزیابی دانشجویان دارد و تجربه هر استاد با دیگری متفاوت است. حال یک استاد جدید (که نقش مدل متالرنینگ را دارد) وارد دانشگاه میشود و وظیفهاش این است که بتواند ارزیابیهای دقیق و منصفانهای در درسهای مختلف انجام دهد، حتی در درسهایی که قبلا هیچ تجربهای درباره آنها ندارد.
Meta-training (مرحله آموزش متا):
استاد جدید ابتدا دادهها و ارزیابیهای انجامشده توسط استادان قبلی را بررسی میکند. او تلاش میکند الگوهای مشترک میان روشهای ارزیابی را شناسایی کند: مثلا در درس ریاضی، استادان به دقت در محاسبات اهمیت میدهند، در درس ادبیات، تحلیل و خلاقیت مهم است و در درس فیزیک، توانایی حل مسئله و درک مفاهیم بنیادی کلیدی است. این مرحله شبیه فرآیند متا-تکامل (Meta-evolution) است که در آن استاد جدید یاد میگیرد چگونه ارزیابیها را انجام دهد و روشهای خود را بر اساس تجربه جمعآوریشده توسعه دهد.
Meta-testing (مرحله آزمون متا):
وقتی یک دانشجوی جدید یا درس جدید (استاد پیش از این هیچ برخوردی با آن نداشته) ارائه میشود، استاد جدید باید بر اساس تجربههای گذشته و دانشی که از ارزیابیهای قبلی به دست آورده، تصمیم بگیرد. حتی اگر اطلاعات محدودی درباره دانشجو یا درس جدید داشته باشد، میتواند سریع و دقیق عمل کند، زیرا توانایی یادگیری یادگیری (learning to learn) را کسب کرده است.
الهام از تکامل ژنتیکی و خودارجاعی:
درست مثل تکامل ژنتیکی که فرایند یادگیری را در ژنها رمزگذاری میکند و نسلهای بعدی از تجربههای گذشته بهره میبرند، استاد جدید نیز از تجربههای گذشته خود و دیگر استادان دانش متا جمعآوری میکند. این دانش متا به او کمک میکند که در هر سطحی، روشهای یادگیری و تصمیمگیری خود را بهبود دهد. اگر استاد جدید به مرور روشهای بهینهتری برای ارزیابی پیدا کند، میتوان گفت او «متا-تکامل» کرده است.
روشهای متالرنینگ معمولاً در چهار دسته اصلی طبقهبندی میشوند: مبتنی بر معیار که یاد میگیرند نمونهها را با هم مقایسه کنند، مبتنی بر بهینهسازی که مدل را برای سازگاری سریع با وظایف جدید آماده میکنند، مبتنی بر مدل که ساختار مدل توانایی تعمیم سریع پیدا کند، و مبتنی بر حافظه که از تجربیات گذشته برای حل مسائل جدید استفاده میکنند.
۱. یادگیری متا بدون وابستگی به مدل (Model-Agnostic Meta-Learning – MAML)
MAML یکی از شناختهشدهترین چارچوبها در متالرنینگ است که با هدف افزایش توانایی مدلها در سازگاری سریع با تسکهای جدید طراحی شده است، بهویژه زمانی که دادههای آموزشی بسیار محدود هستند. ویژگی متمایزکننده MAML، ماهیت مدل-ناوابسته (Model-Agnostic) آن است؛ به این معنا که این روش را میتوان بدون نیاز به تغییر در ساختار الگوریتمهای یادگیری مختلف به کار گرفت. ایده اصلی در MAML یافتن مجموعهای از پارامترهای عمومی است که امکان تطبیق سریع با تسکهای جدید را تنها با چند بهروزرسانی گرادیانی فراهم کند. در نتیجه، مدل پس از مشاهده تعداد اندکی نمونه، میتواند عملکرد مطلوبی داشته باشد و نیاز به دادههای گسترده کاهش مییابد.
۲. روشهای مبتنی بر بهینهسازی (Optimization-Based Meta-Learning)
در این دسته، تمرکز بر بهبود فرایند بهینهسازی است تا سازگاری سریعتر با تسکهای جدید امکانپذیر شود. برخلاف روشهای سنتی که از ابرپارامترهای ثابت (مانند نرخ یادگیری ثابت) استفاده میکنند، در این رویکرد، خود فرایند بهینهسازی پویا و قابل یادگیری است. یکی از نمونههای برجسته، یادگیری متای بیزی (Bayesian Meta-Learning) است که عدم قطعیت را وارد فرایند یادگیری کرده و به مدل کمک میکند در شرایط دادههای ناقص یا پرنویز، تصمیمگیری بهتری داشته باشد. رویکرد دیگر استفاده از وزنهای سریع و کند است؛ ایدهای الهامگرفته از سازوکار مغز انسان که در آن برخی پارامترها به سرعت با اطلاعات جدید سازگار میشوند و برخی دیگر برای الگوهای پایدارتر بهتدریج تغییر میکنند. این انعطافپذیری سبب میشود مدل بدون نیاز به بازآموزی کامل، کارآمدتر به تسکهای تازه پاسخ دهد.
۳. روشهای مبتنی بر متریک (Metric-Based Meta-Learning)
در این روش، بهجای تغییر مستقیم پارامترهای مدل، سیستم یاد میگیرد شباهت میان تسکها یا نمونهها را اندازهگیری کند. در واقع، قلب این رویکرد تعریف و یادگیری یک تابع فاصله است که تعیین میکند دادههای جدید تا چه حد با نمونههای قبلی مرتبط هستند. یکی از مثالهای مشهور این دسته، شبکههای تطبیقی (Matching Networks) است که با یادگیری یک تابع شباهت مبتنی بر شبکه عصبی، امکان دستهبندی یا پیشبینی را تنها بر اساس تعداد محدودی نمونه فراهم میکند. این روش بهویژه در مسائل Few-shot کاربرد دارد و با وجود دادههای اندک، میتواند تعمیمپذیری مناسبی ارائه دهد.
۴. شبکههای عصبی تقویتشده با حافظه (Memory-Augmented Neural Networks – MANNs)
شبکههای عصبی تقویتشده با حافظه، رویکردی پیشرفته در متالرنینگ هستند که در آن مدل به یک حافظهٔ خارجی برای ذخیرهسازی و بازیابی اطلاعات دسترسی دارد. این حافظه همانند یک مخزن عمل میکند که تجربههای گذشتهٔ مدل را نگه میدارد و امکان انتقال دانش میان تسکهای مختلف را فراهم میسازد. به کمک این قابلیت، مدل میتواند وابستگیهای بلندمدت را بهتر بیاموزد و از تجربههای گذشته برای حل مسائل جدید استفاده کند. چنین سیستمی در شرایطی که تنها دادههای اندکی برای تسک جدید وجود دارد اما دانش پیشین ارزشمندی در دسترس است، بسیار مؤثر عمل میکند. در واقع، MANNs با ترکیب انعطافپذیری شبکههای عصبی و توانایی حافظه بیرونی، سیستمی شبیه به حافظه انسانی ایجاد میکنند که قادر است از تجربیات گذشته برای تصمیمگیریهای کنونی بهره ببرد.
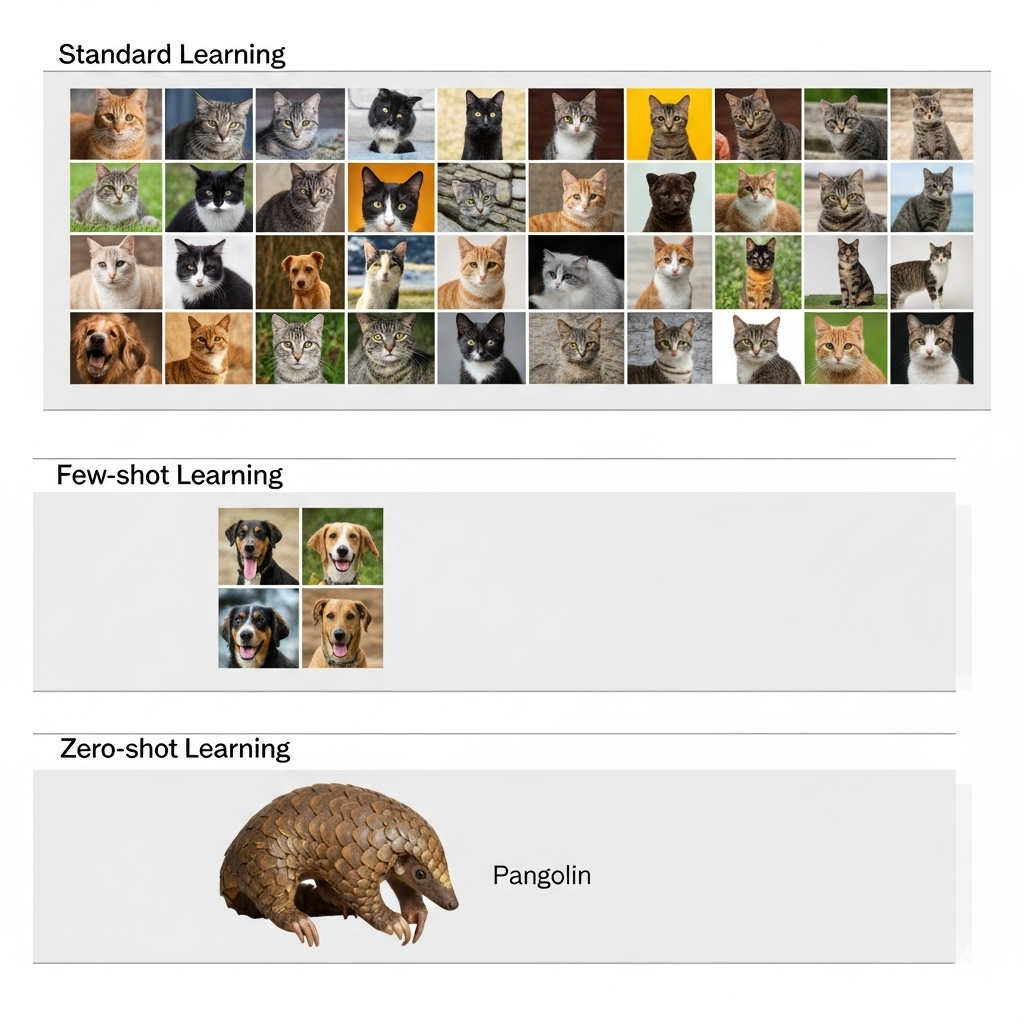
متا لرنینگ، بهعنوان رویکردی برای «یادگیری نحوهی یادگیری»، در حوزههای مختلف یادگیری ماشین و هوش مصنوعی نقش کلیدی ایفا میکند. یکی از مهمترین کاربردهای آن در Few-shot و Zero-shot Learning است؛ جایی که مدلها با استفاده از دادههای بسیار محدود قادر به یادگیری میشوند. در حالی که Few-shot با چند نمونهی برچسبخورده آموزش میبیند، Zero-shot بر پایهی دانش بیرونی یا embeddingها بدون نیاز به دادهی خاص همان وظیفه عمل میکند. نمونههای عملی شامل تشخیص بیماریهای نادر در تصاویر پزشکی یا ترجمه زبانهای کممنبع است.
دستهی دوم، شخصیسازی (Personalization) است که بهویژه در سیستمهای توصیهگر، پلتفرمهای آموزشی و ابزارهای پایش سلامت کاربرد دارد. متا لرنینگ این امکان را فراهم میکند که مدلها با کمترین داده از رفتار کاربران، به سرعت خود را تطبیق دهند؛ مثلاً ساعتهای هوشمند که بر اساس دادههای بیومتریک هر فرد الگوریتم پایش سلامت را شخصیسازی میکنند.
یکی دیگر از حوزههای مهم، بهینهسازی هایپرپارامترهاست. در این زمینه متالرنینگ با استفاده از نتایج تجربیات گذشته، فرآیند انتخاب هایپرپارامترها را در AutoML تسهیل کرده و موجب صرفهجویی در زمان و منابع محاسباتی میشود. مشابه همین، در جستجوی معماری شبکههای عصبی (NAS) نیز با تکیه بر تجربههای پیشین، فضای جستجو محدود شده و مدلها بهصورت خودکار به سمت معماریهای کاراتر هدایت میشوند؛ رویکردی که در وظایفی مانند بازشناسی گفتار یا پردازش زبان طبیعی بسیار مؤثر است.
در یادگیری فدره (Federated Learning) نیز متالرنینگ اهمیت زیادی دارد؛ زیرا امکان انطباق مدلها با دادههای محلی کاربران، بدون نقض حریم خصوصی، را فراهم میسازد. بهعنوان نمونه، تلفنهای همراه میتوانند بدون ارسال مستقیم دادههای کاربر به سرور مرکزی، مدلهای زبانی یا پیشبینیکننده را تقویت کنند.
در نهایت، حوزهی سلامت و کشف دارو از جمله کاربردهای کلیدی متالرنینگ محسوب میشود. در این بخش، الگوریتمها با استفاده از دادههای محدود پزشکی و مولکولی میتوانند پیشبینیهای دقیقی برای بیماریهای نادر انجام دهند یا طرحهای درمانی شخصیسازی شده ارائه دهند. علاوه بر آن، در فرآیند کشف دارو نیز متا لرنینگ توانایی شناسایی ترکیبات جدید و ارزیابی کارایی آنها را با هزینه و زمان کمتر فراهم میسازد.
۱.حفظ حریم خصوصی
یکی از چالشهای متالرنینگ، حفظ حریم خصوصی دادههاست. در الگوریتمهایی مانند MAML، اشتراکگذاری گرادیانها و سیگنالهای خطا بین مدلهای یادگیرنده و مدل متا میتواند منجر به افشای اطلاعات حساس شود، حتی بدون دسترسی مستقیم به دادههای خام. این مسأله، مدل را نسبت به حملات استنتاج عضویت (MembershipInference Attacks) آسیبپذیر میکند و نیاز به روشهای محافظت از حریم خصوصی، مانند تزریق نویز یا محدودسازی دسترسی به گرادیانها، ایجاد میکند.
۲.ریسک بیشبرازش در یادگیری با دادههای کم
یکی از چالشهای مهم در متالرنینگ، انتخاب وظایف (tasks) و دادههای آموزشی مناسب برای آموزش مدل است. در بسیاری از روشهای سنتی، تمام دادهها و وظایف به یک شکل و بدون اولویت در آموزش استفاده میشوند که میتواند باعث یادگیری ناکارآمد و اتلاف منابع شود، بهویژه وقتی دادهها محدود هستند. بهعنوان مثال، در رویکرد «یادگیری متا فعال با آگاهی از عدم قطعیت» (UA-AML) برای طبقهبندی متنی با داده کم، مشخص شده که مدلها باید بتوانند وظایفی را انتخاب کنند که بیشترین اطلاعات را برای بهبود عملکرد فراهم میکنند، نه وظایفی که تکراری یا کماثر هستند. این رویکرد با کمیسازی عدم قطعیت پیشبینی مدل، به شناسایی دادهها و وظایف مهم کمک میکند و باعث میشود فرایند یادگیری متا کارآمدتر، دقیقتر و با قابلیت تعمیمپذیری بالاتر انجام شود.
۳.فراموشی فاجعه بار
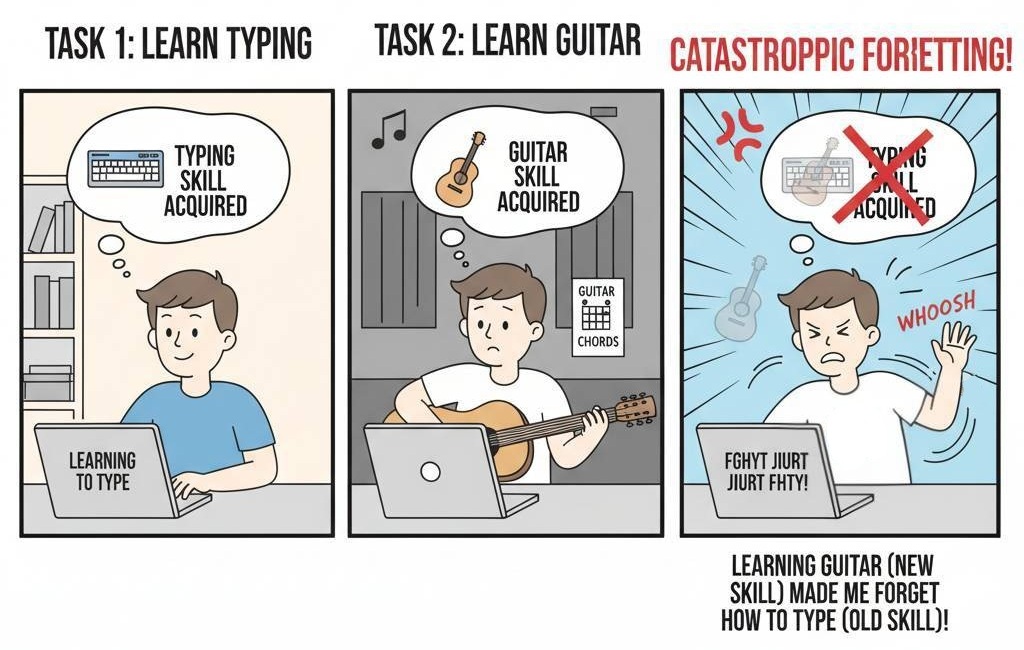
یکی از چالشهای مهم در متالرنینگ، یادگیری مداوم از جریان تسکها است که با مشکل فراموشی فاجعهبار (catastrophic forgetting) همراه است. وقتی مدل در معرض تسکهای پیوسته قرار میگیرد، یادگیری تسکهای جدید میتواند موجب بازنویسی پارامترهای قبلی شود و عملکرد مدل روی تسکهای گذشته کاهش یابد. برای مقابله با این مسئله، از روشهایی مانند شبکههای حافظهدار (Memory-Augmented Networks)، بازنماییهای مشترک بین تسکها و تکنیکهای منظمسازی (regularization) استفاده میشود. هدف این روشها حفظ دانش عمومی و متا-دانش کسبشده از تسکهای قبلی و همزمان امکان تطبیق سریع با تسکهای جدید است. این چالش در محیطهایی که دادهها بهصورت تدریجی و مداوم وارد میشوند، مانند سیستمهای تشخیص تقلب یا پلتفرمهای توصیهگر آنلاین، اهمیت ویژهای دارد. بهعبارت دیگر، مدل باید توانایی یادگیری جدید را داشته باشد و در عین حال حافظهٔ دانش گذشته را نیز حفظ کند، مشابه توانایی انسان در یادگیری مستمر بدون فراموشی مهارتهای قبلی.
۴. انطباق با تغییرات توزیع دادهها
یکی از مشکلات متالرنینگ در کاربردهای واقعی، مواجهه با تغییرات توزیع دادهها (distribution shifts) است. مدلها باید توانایی سازگاری سریع با دادههای جدیدی داشته باشند که ممکن است از نظر ویژگیها یا ساختار با دادههای آموزش متفاوت باشند. این مسئله بهویژه در حوزههایی مانند پردازش زبان طبیعی، بینایی ماشین و سیستمهای پزشکی که دادهها پیوسته تغییر میکنند، اهمیت پیدا میکند. متالرنینگ با استخراج دانش متا از تسکهای قبلی تلاش میکند تا مدل بتواند این تغییرات را پیشبینی کرده و با حداقل دادههای جدید به سرعت سازگار شود، اما هنوز چالشهای قابل توجهی در بهبود دقت و پایداری در مواجهه با تغییرات شدید توزیع وجود دارد.
متالرنینگ با روشهایی مانند MAML، Reptile و MTL، توانسته عملکرد بهینهسازی هایپرپارامتر و یادگیری سریع در شرایط داده محدود را بهبود دهد. با این حال، چالشهایی مانند ناپایداری آموزش، انفجار گرادیان، و نیاز به دادههای همزمان از چند تسک هنوز باقی است. این حوزه همچنان یک گرایش پژوهشی فعال برای بهینهسازی خودکار هایپرپارامتر و کاربرد در تشخیص اشیاء و وظایف زمان واقعی است و گامی مهم به سوی الگوریتمهایی با توانایی یادگیریِ یادگیری محسوب میشود. این ویژگی، متالرنینگ را به یکی از بنیانهای مسیر دستیابی به هوش مصنوعی عمومی (AGI) تبدیل میکند.

