
پس از انتشار جیبای ۵، اکنون نسخهٔ جیبای ۵.۱ (Jibay 5.1) را معرفی میکنیم؛ نسخهای که با تمرکز بر پیروی دقیقتر از دستورها، استفادهٔ هوشمندانهتر از ابزارها، ایمنی بیشتر و بهبود تجربهٔ کاربری توسعه یافته است. جیبای ۵.۱ ادامهٔ مسیر توسعهٔ جیبای است و هدف آن ارائهٔ پاسخهایی قابلاتکاتر و اجرای منظمتر وظایف پیچیده در شرایط واقعی استفاده است.
در این بهروزرسانی، تغییرات فقط به کیفیت متن محدود نیستند. نحوهٔ تصمیمگیری برای جستوجوی وب، امکان اجرای مفسر کد خارج از فرایند تفکر، سازوکار بررسی امنیتی ورودی و خروجی، و مسیر تازهٔ پردازش تصاویر نیز تغییر کردهاند. در ادامه، جزئیات این تغییرات و نتایج بنچمارکهای اعلامشده برای جیبای ۵.۱ را مرور میکنیم.
خلاصهٔ انتشار: جیبای ۵.۱ با تمرکز بر ایمنی، پیروی از دستورها، فراخوانی ابزارها، پردازش تصویر و قابلیتهای استدلالی عرضه شده است. اعداد بنچمارک این مقاله، نتایج اعلامشده برای این نسخه در شرایط آزمون ذکرشده هستند.
۱. ایمنی بیشتر با Jibay Moderation 3
همزمان با انتشار جیبای ۵.۱، نسخهٔ سوم Jibay Moderation نیز معرفی میشود. این مدل امنیتی برای بررسی ورودیها و خروجیها در نظر گرفته شده است؛ یعنی محتوا پیش از رسیدن به مدل و همچنین پیش از ارائهٔ پاسخ نهایی، از مسیر بررسی امنیتی عبور میکند. هدف این طراحی، شناسایی بهتر درخواستها یا پاسخهای مسئلهدار و کاهش احتمال عبور محتوای نامناسب از فرایند پاسخگویی است.
بر اساس ارزیابی داخلی اعلامشده، قدرت Jibay Moderation 3 نسبت به نسخهٔ دوم حدوداً بیش از ۱۰۰ برابر بیشتر گزارش شده است. این عدد بیانگر ادعای بهبود در معیارهای ارزیابی داخلی جیبای است و نباید بدون انتشار روش آزمون، مجموعهداده و تعریف دقیق «قدرت» بهعنوان مقایسهای مستقل و عمومی تفسیر شود. با این حال، هدف توسعه روشن است: بررسی امنیتی دقیقتر و پوشش بهتر سناریوهای ورودی و خروجی.
بررسی در دو مرحله
بررسی ورودی: درخواست کاربر پیش از ورود به فرایند تولید پاسخ ارزیابی میشود.
بررسی خروجی: پاسخ تولیدشده نیز پیش از تحویل به کاربر بررسی میشود.
هدف: افزایش پایداری لایهٔ ایمنی و کمک به ارائهٔ پاسخهایی سازگارتر با سیاستهای استفادهٔ ایمن.
۲. ابزارها؛ تصمیمگیری هوشمندانهتر و اجرای منعطفتر
یکی از تغییرات مهم جیبای ۵.۱ به نحوهٔ استفاده از ابزارها مربوط است. جستوجوی وب اکنون بهصورت خودکار مدیریت میشود: مدل باید بر اساس نوع پرسش تشخیص دهد که آیا پاسخگویی به دانش موجود کافی است یا برای رسیدن به پاسخ دقیقتر، تازهتر یا قابلبررسی به جستوجوی وب نیاز دارد. کاربر نیز میتواند مستقیماً درخواست جستوجوی وب بدهد.
این رویکرد برای پرسشهایی که به اطلاعات روز، منابع بیرونی، بررسی چند منبع یا راستیآزمایی نیاز دارند اهمیت ویژهای دارد. در مقابل، برای درخواستهای ساده، محاسباتی یا توضیح مفاهیم پایدار، استفادهٔ غیرضروری از جستوجو میتواند کنار گذاشته شود تا مسیر پاسخگویی بیدلیل پیچیده نشود. تصمیم درست، انتخاب ابزار متناسب با وظیفه است؛ نه فراخوانی ابزار در همهٔ پیامها.
مفسر کد نیز دیگر صرفاً به مرحلهٔ تفکر وابسته نیست. جیبای ۵.۱ میتواند در صورت نیاز، خارج از فرایند تفکر نیز مفسر کد را اجرا کند. این تغییر، اجرای محاسبات، بررسی دادهها و انجام وظایف برنامهنویسی را منعطفتر میکند و وابستگی اجرای ابزار به یک مرحلهٔ خاص از تولید پاسخ را کاهش میدهد.
۳. پیروی از دستورها و فراخوانی ابزارها
در جیبای ۵.۱، پیروی از دستورها نسبت به جیبای ۵ بهبود یافته است. این بهبود به معنای توجه دقیقتر به خواستهٔ اصلی کاربر، حفظ محدودیتهای تعیینشده، انجام مراحل موردنیاز و کاهش انحراف از قالب یا هدف درخواست است. در وظایف چندمرحلهای، پیروی از دستور تنها به فهم جمله محدود نمیشود؛ مدل باید ترتیب عملیات، شرایط استفاده از ابزار و قالب خروجی مورد انتظار را نیز رعایت کند.
فراخوانی ابزارها نیز بخشی از همین مسیر است. مدل باید بتواند تشخیص دهد چه زمانی ابزار واقعاً لازم است، کدام ابزار با هدف درخواست تناسب دارد و چه زمانی میتوان بدون ابزار پاسخ داد. بهبود این بخش برای تجربهٔ ایجنتی اهمیت دارد؛ زیرا یک مدلِ مجهز به ابزار تنها زمانی مفید است که ابزار را درست و در زمان مناسب فراخوانی کند و نتیجهٔ آن را در پاسخ نهایی بهکار بگیرد.
۴. پنج سطح تلاش استدلالی (Reasoning Effort)
جیبای ۵.۱ دارای پنج سطح تلاش استدلالی است. این سطوح امکان تنظیم میزان تلاش اختصاصیافته به مسئله را فراهم میکنند؛ از پاسخگویی سبکتر برای کارهای معمول تا تلاش بیشتر برای وظایف پیچیده. در این نسخه، نام سطحها عبارتاند از Low، Medium، High، xHigh و Max.
سطح کاربرد کلی دسترسی
Low درخواستهای ساده و پاسخهای سریع در دسترس
Medium کارهای روزمره با نیاز متعادل به تحلیل در دسترس
High مسائل پیچیدهتر و وظایف چندمرحلهای در دسترس
xHigh تلاش استدلالی بسیار بالا برای کاربران و API عمومی ارائه نشده است
Max بالاترین سطح تلاش در آزمونهای داخلی اعلامشده برای کاربران و API عمومی ارائه نشده است
در نتیجه، اگرچه xHigh و Max در فهرست سطوح مدل وجود دارند و در آزمونهای بنچمارک اعلامشده از سطح Max استفاده شده است، این دو سطح مانند گذشته در اختیار کاربران عمومی و API قرار ندارند. نمرههای بنچمارک این مقاله باید با توجه به همین تفاوت شرایط خوانده شوند.
۵. تحلیل سریعتر تصاویر با مسیر پردازش ترکیبی
با توجه به محدودیت منابع سرورهای جیبای در ایران، تحلیل مستقیم تصویر توسط خود مدل اصلی حذف شده است. بهجای آن، جیبای ۵.۱ از یک مسیر پردازش ترکیبی استفاده میکند: ابتدا متن موجود در تصویر استخراج میشود و سپس یک مدل اختصاصی دیگر، اشیا و اطلاعات قابلشناسایی تصویر را استخراج میکند. زمان اعلامشده برای مجموع این دو مرحله، در شرایط فعلی کمتر از دو ثانیه است.
پس از آمادهشدن این اطلاعات، مدل اصلی آنها را میخواند و بر اساس متن استخراجشده و اطلاعات تصویری، پاسخ کاربر را تولید میکند. این معماری بهجای سپردن تمام پردازش تصویری به مدل اصلی، از مدلهای تخصصیتر برای مراحل مقدماتی استفاده میکند؛ رویکردی که با محدودیت منابع محاسباتی موجود سازگارتر است.
زمان کمتر از دو ثانیه به مراحل استخراج متن و اطلاعات تصویر اشاره دارد و زمان کامل پاسخگویی میتواند با توجه به طول درخواست، پیچیدگی تحلیل و تولید پاسخ تغییر کند. بنابراین این عدد را نباید با زمان کل دریافت تصویر تا پایان پاسخ یکی دانست.
۶. سرعت تولید و خواندن توکنها
سرعت تولید توکن و پردازش توکنهای ورودی در جیبای ۵.۱ تقریباً مشابه جیبای ۵ است. بهبود اعلامشده در این بخش حدود کمتر از ۱۰ درصد است؛ بنابراین تغییر سرعت، جهشی بزرگ محسوب نمیشود و احتمالاً در استفادهٔ روزمره برای همهٔ درخواستها بهوضوح محسوس نخواهد بود. تمرکز اصلی این انتشار بر استفادهٔ دقیقتر از ابزارها، پیروی از دستورها و سازوکارهای ایمنی بوده است، نه افزایش چشمگیر سرعت خام تولید متن.
۷. پایان اجرای جیبای ۵ و انتقال کاربران
پس از آمادهشدن جیبای ۵.۱، اجرای نسخهٔ جیبای ۵ متوقف شده است. از آنجا که ظرفیت سرورهای جیبای در ایران محدود است، اجرای همزمان هر دو نسخه امکانپذیر نبود؛ به همین دلیل، جیبای ۵ خاموش و جیبای ۵.۱ جایگزین آن شده است.
کاربرانی که پیشتر از جیبای ۵ استفاده میکردند، بهطور موقت به جیبای ۵.۱ هدایت میشوند. هدف از این انتقال، حفظ دسترسی کاربران به سرویس در زمان جایگزینی نسخه است. در صورت اعمال تغییرات بعدی در دسترسی یا شیوهٔ ارائهٔ مدل، جزئیات آن از مسیرهای رسمی جیبای اعلام خواهد شد.
۸. عملکرد و نتایج بنچمارکها
جدول زیر نتایج اعلامشده برای جیبای ۵.۱ را در مجموعهای از بنچمارکهای استدلال، پیروی از دستور، تواناییهای برنامهنویسی، کار با محیطهای نرمافزاری و ارزیابی چندزبانه نشان میدهد. طبق اطلاعات این انتشار، آزمونها در سطح Max، با ابزارهای فعال و تفکر فعال انجام شدهاند.
نام بنچمارک و نمره:
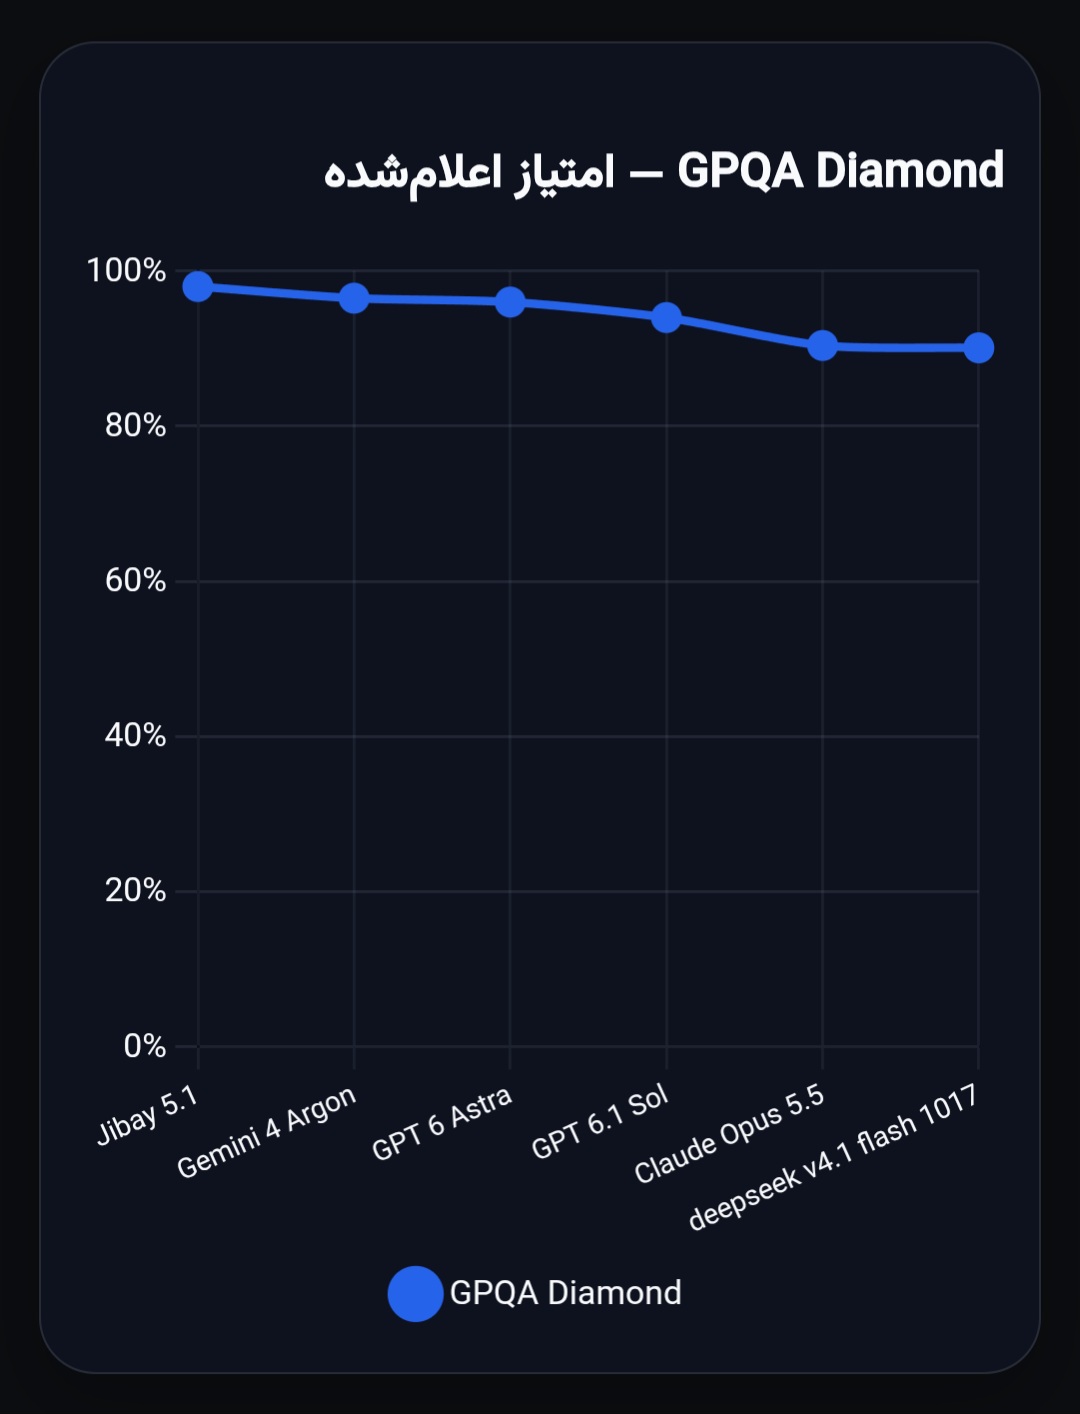
GPQA Diamond - 98%
IFEval - 96%
IFBench - 80%
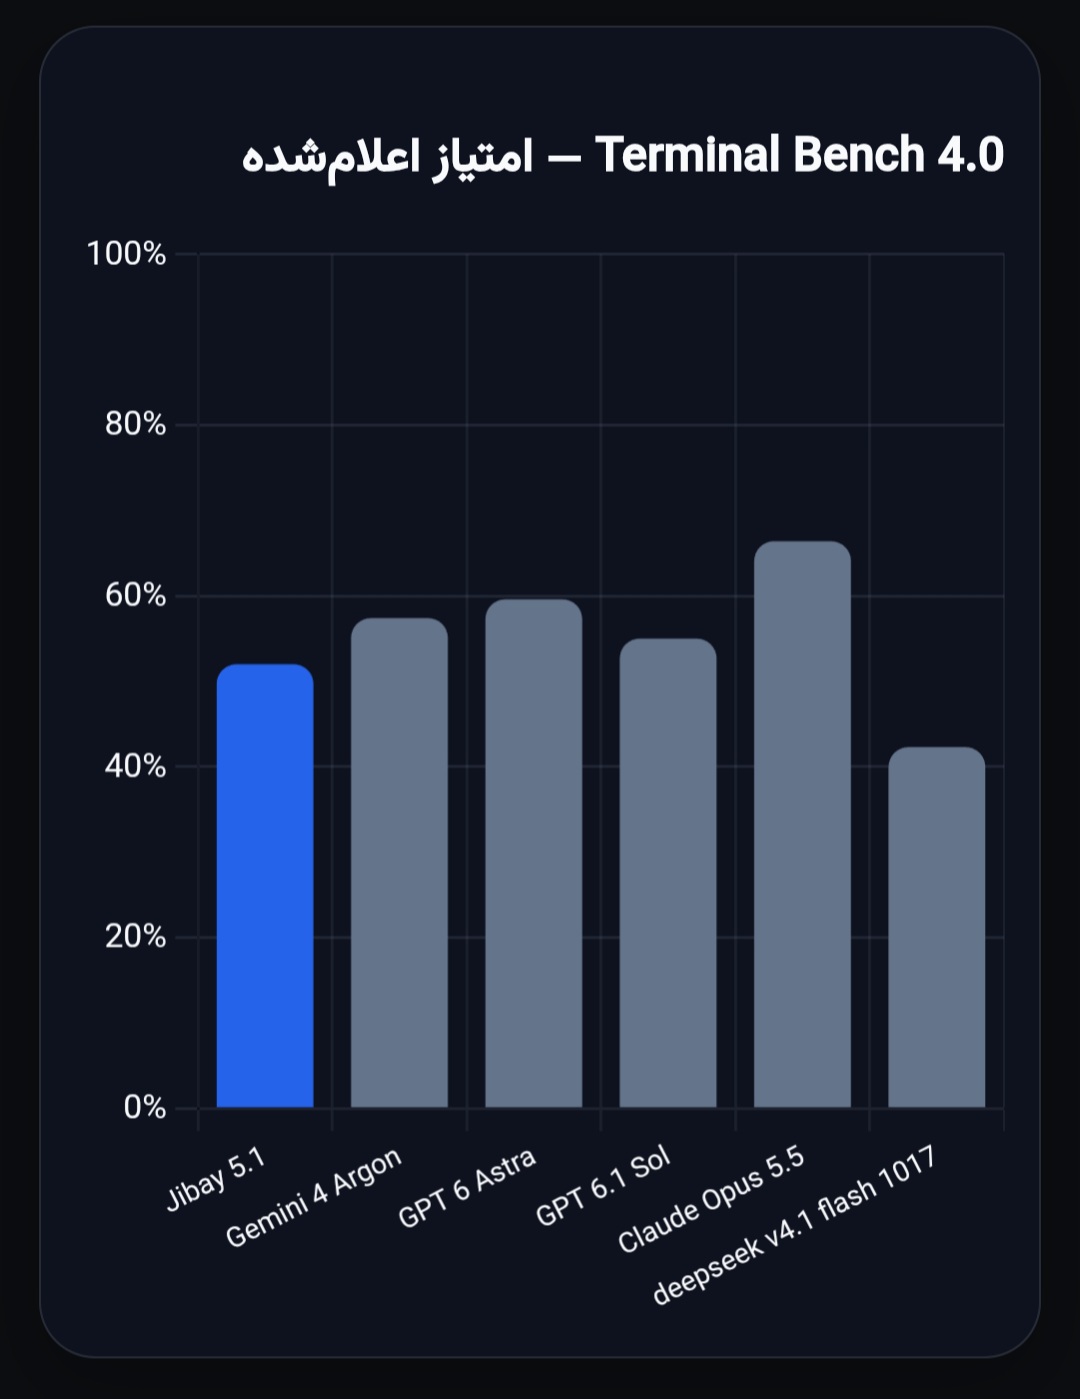
Terminal Bench 4.0 - 52%
ARC-AGI 3 - 50%
MMLU-Pro - 90%
MMMLU - 87%
OSWorld-2.0 - 51%
HumanEval - 86%
GDP.pdf - 5%
نتایج این جدول، تصویری چندبعدی از عملکرد مدل ارائه میکنند. امتیاز بالا در یک آزمون لزوماً به معنای برتری در تمام وظایف نیست؛ برای مثال، پاسخگویی به پرسشهای علمی با اجرای موفق وظایف ترمینال یا کنترل محیط دسکتاپ تفاوت دارد. به همین دلیل، نتایج هر بنچمارک باید در چارچوب هدف و روش ارزیابی همان آزمون تفسیر شوند.
مقایسهٔ GPQA Diamond
در مقایسهٔ ارائهشده برای GPQA Diamond، جیبای ۵.۱ امتیاز ۹۸ درصدی دارد. این بنچمارک برای سنجش پاسخگویی به پرسشهای علمی دشوار طراحی شده است. نمودار زیر اعداد اعلامشده برای مدلهای فهرستشده را نشان میدهد؛ این مقایسه بر مبنای دادههای ارائهشده در همین اطلاعیه است و بهتنهایی اثباتکنندهٔ برتری عمومی در همهٔ زمینهها نیست.
مقایسهٔ Terminal Bench 4.0
در Terminal Bench 4.0، جیبای ۵.۱ امتیاز ۵۲ درصدی ثبت کرده است. این آزمون بیشتر بر انجام وظایف عملی در محیط ترمینال و توانایی اجرای مراحل لازم برای رسیدن به نتیجه تمرکز دارد؛ بنابراین با بنچمارکهای دانشمحور یکسان نیست. طبق اعداد ارائهشده، چند مدل در این آزمون امتیاز بالاتری دارند و این نتیجه نشان میدهد که بهبود عملکرد عاملمحور و اجرای وظایف ترمینالی همچنان حوزهای مهم برای توسعهٔ آیندهٔ جیبای است.
مقایسهٔ نسخههای جیبای در بنچمارکهای منتخب
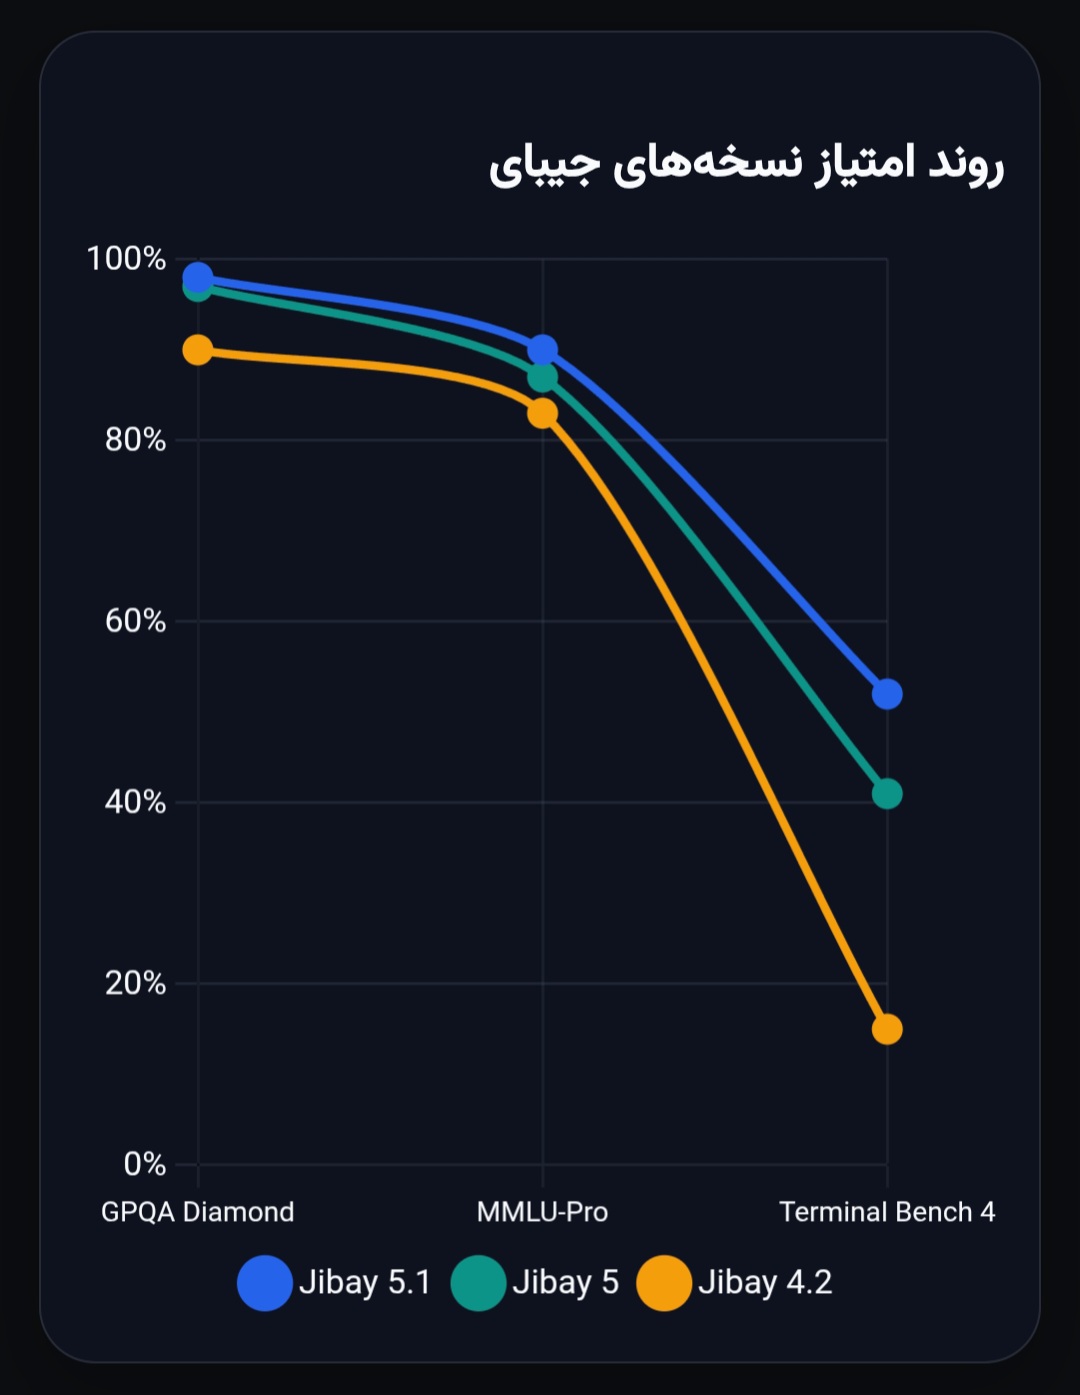
برای نمایش روند تغییر امتیازها در نسخههای مختلف، جدول زیر نتایج اعلامشدهٔ جیبای ۵.۱، جیبای ۵ و جیبای ۴.۲ را در سه بنچمارک منتخب کنار هم قرار میدهد. این مقایسه روی سه محور متمرکز است: استدلال علمی دشوار در GPQA Diamond، دانش و استدلال در MMLU-Pro و اجرای وظایف ترمینالی در Terminal Bench 4.
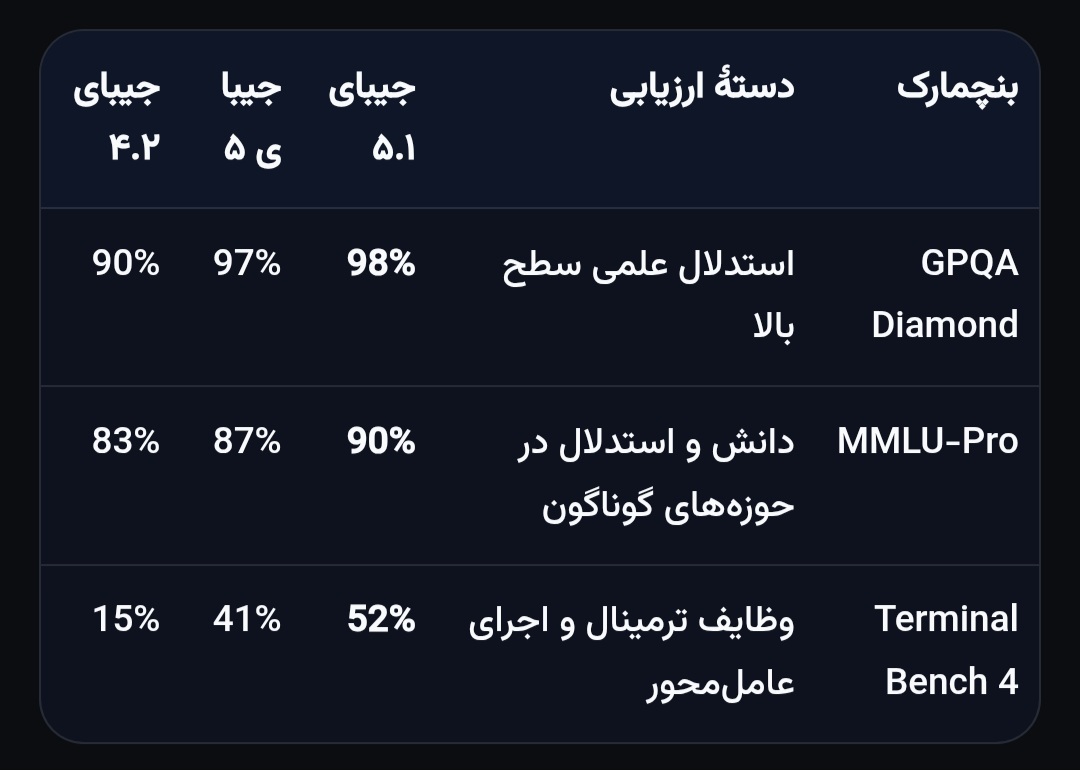
بر اساس اعداد ارائهشده، جیبای ۵.۱ در هر سه بنچمارک این جدول بالاترین امتیاز را دارد. بیشترین فاصلهٔ عددی میان نسخهها در Terminal Bench 4 دیده میشود؛ امتیاز اعلامشده از ۱۵ درصد برای جیبای ۴.۲ به ۴۱ درصد برای جیبای ۵ و سپس به ۵۲ درصد برای جیبای ۵.۱ رسیده است. در GPQA Diamond نیز امتیاز از ۹۰ درصد در نسخهٔ ۴.۲ به ۹۷ و سپس ۹۸ درصد افزایش یافته است.
جمعبندی
جیبای ۵.۱ با مجموعهای از تغییرات در ایمنی، تصمیمگیری برای استفاده از ابزارها، پیروی از دستورها و پردازش تصویر منتشر شده است. در این نسخه، جستوجوی وب میتواند بر اساس نیاز پرسش انتخاب شود، مفسر کد امکان اجرا خارج از فرایند تفکر را دارد و بررسی امنیتی ورودی و خروجی با Jibay Moderation 3 انجام میشود. پردازش تصویر نیز با استفاده از استخراج متن و یک مدل تخصصی دیگر انجام میشود تا با منابع سرور موجود سازگار باشد.
نتایج بنچمارکهای اعلامشده نقاط قوت و زمینههای قابلبهبود را در کنار هم نشان میدهند. هدف از انتشار این نسخه، تنها تغییر شمارهٔ نسخه نیست؛ بلکه فراهمکردن تجربهای منظمتر، ایمنتر و کارآمدتر برای استفادهٔ روزمره و وظایف چندمرحلهای است.
https://jibay.ir/Jibay-5.1/
| تمامی حقوق برای جیبای محفوظ است.

