
وقتی فهمیدم ساختن یک مدل AI تازه اول ماجراست و این رشته سر دراز دارد!😃
من این کتاب رو با این تصور شروع کردم که خب، قراره یک کتاب دربارهی مهندسی سیستمهای هوش مصنوعی بخونم و احتمالاً با کلی مدل، الگوریتم و اصطلاحات مربوط به AI سر و کله بزنم.(یکی نیست بگه شما تصور نکن، اونم با این حجم از Accuracy 😁)
ولی زهی خیال باطل!
هرچی جلوتر رفتم، بیشتر متوجه شدم ماجرا اصلاً این نیست! 😅
کتاب بیشتر از اینکه فقط دربارهی هوش مصنوعی باشه، دربارهی اینه که وقتی یک مدل AI قرار شد که وارد یک سیستم نرمافزاری واقعی بشه، حالا باید باهاش طوری تا کنیم؟
چون ساختن یک مدل که روی یک Dataset خوب Accuracy قابل قبولی بده، با ساختن یک سیستم واقعی که قرار باشه هزاران کاربر ازش استفاده کنن، زمین تا آسمون فرق داره.
اینجا دیگه فقط مدل مهم نیست؛
داده مهمه، معماری مهمه، زیرساخت مهمه، Deployment مهمه، Monitoring مهمه، Security مهمه، Privacy مهمه، حتی Fairness همه چی خلاصه. همه چی مهمه.
اینکه اصلاً چطور بفهمیم چی مهمه و سیستممون داره چه غلطی میکنه هم مهمه! 😂
و به نظرم دقیقاً همین نگاه، جذابترین بخش کتابه.
خب حالا بریم تو دل ماجرا ببینیم چرا و چه خبره؟
اول به این سوال جواب بدیم که اصلاً AI System یعنی چی؟
یکی از اولین چیزهایی که کتاب سعی میکنه از هم تفکیک کنه، تفاوت بین AI Model و AI System هست.
چیزی که شاید در نگاه اول خیلی بدیهی به نظر برسه، ولی اگر یکم دقیقتر بشیم، میبینیم اتفاقاً خیلی از مشکلات از همینجا شروع میشن.
مدل فقط یک بخش از سیستم محسوب میشه.
اما ما در یک سیستم AI با مجموعهای از اجزا طرفیم:
AI Systems= Data + Model + Software + Infrastructure + Dev + Ops
یعنی اگر یک مدل فوقالعاده دقیق داشته باشیم ولی دادهی مناسبی نداشته باشیم، سیستم خوبی نداریم.
اگر مدل خوب باشه ولی سیستم کند و پرهزینه باشه، باز هم مشکل داریم.
اگر همهچیز خوب باشه ولی نتونیم بفهمیم چرا مدل بعضی وقتها تصمیمهای عجیب میگیره، باز مشکل داریم.
و اگر همهی اینها خوب باشه ولی دادههای حساس کاربران رو بیهوا وسط سیستم پخش کنیم... خب دیگه اینجا واقعاً شاهکار کردیم و لایق کاپ قهرمانی هستیم😌
کتاب دقیقاً از همین نگاه شروع میکنه که باید کل سیستم رو مهندسی کنیم، نه فقط مدل رو.
و اینجاست که پای مهندسی نرمافزار و معماری میاد وسط.
یکی از چیزهایی که در طول مطالعهی کتاب برام جالب بود اینه که نویسندهها AI مهندسی سیستمهای هوش مصنوعی رو یک دنیای کاملاً جدا از Software مهندسی نرمافزار نمیبینن.
اتفاقاً برعکس.
خیلی از مفاهیمی که در مهندسی نرمافزار داریم، هنوز سر جاشون هستن؛ فقط وقتی AI وارد سیستم میشه، گل به سبزه آراسته میشه🌱🌸 و بعضی از مسائل پیچیدهتر میشن.
مثلاً ما همچنان Architecture داریم، Lifecycle داریم، Deployment داریم، Testing داریم، Monitoring داریم و باید به Quality Attributes فکر کنیم.
اما حالا یک موجود جدید هم وسط ماجرا داریم به اسم Model که رفتار اون همیشه کاملاً قابل پیشبینی نیست.
و همین عدم قطعیت داستان رو جالبتر میکنه.
در یک نرمافزار معمولی، اگر یک تابع مشخصی رو با ورودی مشخص صدا بزنیم، انتظار داریم خروجی مشخصی بگیریم.
اما وقتی پای مدلهای AI وسط میاد، رفتار سیستم میتونه به داده، Training، تغییرات محیط، تغییر توزیع داده و خیلی چیزهای دیگه وابسته باشه.
پس مهندسی AI یعنی باید یاد بگیریم چطور این موجود کمی غیرقابلپیشبینی رو داخل یک سیستم مهندسیشده قرار بدیم.
اینطوری بگم که تو سیستمهای نرمافزاری ما معمولا یک مسیر داریم:
حالا در سیستمهای AI، علاوه بر نرمافزار و مسیر بالا، باید حواسمون به Data و Model هم باشه.
چرا؟ چون:
ممکنه دادههای جدید وارد سیستم بشن.
ممکنه رفتار کاربران تغییر کنه.
ممکنه عملکرد مدل به مرور افت کنه.
ممکنه Data Drift اتفاق بیفته.
ممکنه مدل نیاز به Retraining داشته باشه.
و بنابراین برخلاف یک نگاه ساده که میگه:
خب مدل رو Train کردیم، Deploy هم کردیم، و صدق الله علی عظیم!
تازه باید آستین بالا بزنی و بگی بسم الله الرحمن و رحیم
چون وقتی که فکر کردی تموم شده، تازه اینجاست که MLOps وارد بازی میشه.
MLOps کمک میکنه چرخهی حیات مدل، داده و سیستم رو تا حد امکان قابل تکرار، قابل مدیریت و قابل پایش کنیم.
در واقع، اگر DevOps تلاش میکنه فرآیند توسعه و عملیات نرمافزار رو منسجمتر و خودکارتر کنه، MLOps همین نگاه رو با پیچیدگیهای خاص سیستمهای یادگیری ماشین ترکیب میکنه.
این شاید یکی از مهمترین چیزهایی باشه که کتاب روی اون تأکید داره.
ما خیلی وقتها وقتی دربارهی یک مدل AI حرف میزنیم، سریع میریم سراغ Accuracy.
مثلاً:
مدل ۹۵ درصد Accuracy داره!
خب... خیلی هم عالی! دمش گرم👏🏻
ولی بعدش چی؟
اگر مدل برای پاسخ دادن ۳۰ ثانیه زمان نیاز داشته باشه چی؟
اگر هزینهی اجرای اون خیلی زیاد باشه چی؟
اگر در برابر یک حمله آسیبپذیر باشه چی؟
اگر اطلاعات خصوصی کاربران رو لو بده چی؟
اگر برای بعضی گروهها عملکرد ناعادلانهای داشته باشه چی؟
اگر بعد از مدتی عملکردش افت کنه و ما اصلاً متوجهش نشیم چی؟
اینجاست که کتاب وارد بحث Quality Attributes میشه و نشون میده کیفیت یک سیستم AI خیلی بزرگتر از Accuracy مدلشه.
یکی از اولین ویژگیهایی که کتاب جدی بررسی میکنه، Reliability یا قابلیت اطمینانه.
و منظور فقط این نیست که سیستم معمولاً کار کنه.
سؤال اینه:
وقتی یک چیزی خراب شد، چی میشه؟
آیا کل سیستم میخوابه؟
آیا میتونیم Failure رو تشخیص بدیم؟
آیا سیستم میتونه Recovery انجام بده؟
آیا Failure یک جزء باعث از کار افتادن کل سیستم میشه؟
اینجا مفاهیمی مثل Fault Tolerance، Recovery، Redundancy و مدیریت Failure اهمیت پیدا میکنن.
و این دقیقاً همون جاییه که معماری نرمافزار خودش رو نشون میده.
چون خیلی از تصمیمهای مربوط به اینکه سیستم در شرایط خراب شدن چطور رفتار کنه، باید قبل از اینکه سیستم خراب بشه در معماری دیده شده باشن.
Performance؛ سریعتر همیشه بهتر نیست!
Performance هم فقط سرعت نیست.
در یک سیستم AI ممکنه با مفاهیمی مثل:
Latency (تاخیر)
Throughput (توان عملیاتی)
Efficiency (کارایی)
Resource Usage (مصرف منابع)
Accuracy (دقت)
سر و کار داشته باشیم.
و اینجا یک مسئلهی جالب داریم: معمولاً نمیتونیم همهچیز رو همزمان تا بینهایت زیاد کنیم هم خرمالو بخوایم و هم خرما رو!
مثلاً یک مدل پیچیدهتر ممکنه Accuracy بیشتری بده، ولی در عوض منابع بیشتری مصرف کنه و Latency رو بالا ببره.
پس معماری باید یک Trade-off منطقی ایجاد کنه.
گاهی بهترین مدل، دقیقترین مدل نیست.
گاهی بهترین راهحل، پیچیدهترین راهحل نیست.
و گاهی یک مدل ساده که سریع، ارزان و قابلاعتماد کار میکنه، خیلی بیشتر از یک مدل خفن و پرهزینه به درد سیستم واقعی میخوره.
که خب این قسمت برای ما مهندسها خیلی آشناست:
پیچیدهتر الزاماً به معنی بهتر نیست.
وقتی AI وارد یک سیستم واقعی میشه، دیگه با یک مدل بیگناه گوشهی لپتاپ طرف نیستیم!
سیستم AI هم باید در برابر تهدیدها محافظت بشه.
کتاب در این بخش به مفاهیمی مثل Threat Modeling، Authentication، Authorization، Least Privilege و Zero Trust میپردازه.
که تقریبا با همهشون آشنایید اما شاید مفهوم Zero Trust جدیدتر و جالبتر باشه. این مفهوم میگه که:
قرار نیست فقط چون یک کاربر یا یک سرویس داخل محیط ما قرار داره، بهش اعتماد کنیم.
باید هویت و مجوز بررسی بشه و دسترسی فقط در حد نیاز داده بشه.
از طرف دیگه، سیستمهای AI تهدیدهای خاص خودشون رو هم دارن؛ چون اینجا علاوه بر نرمافزار و زیرساخت، داده و مدل هم بخشی از سطح حمله هستن.
یعنی من فرض رو بر این میذارم که آقا شما بدی، تا وقتی که خلافش رو ثابت کنی. همینم که هست😌
وقتی یک سیستم AI با دادههای واقعی آدمها کار میکنه، Privacy دیگه یک گزینهی دکوری و برای کلاس گذاشتن نیست!(در نظر بگیر اون لامصب رو😂)
باید بدونیم چه دادهای جمع میکنیم، کجا ذخیره میکنیم، چه کسی بهش دسترسی داره و مدل از این دادهها چه چیزهایی میتونه یاد بگیره یا حتی آشکار کنه.
تاااازه از اون طرف، Fairness هم مطرحه.
اگر دادههای آموزشی سوگیری داشته باشن، مدل هم ممکنه این سوگیری رو یاد بگیره.
و این یعنی ممکنه یک سیستم از نظر فنی خیلی خوب کار کنه، ولی برای بعضی گروهها رفتار مناسبی نداشته باشه.(همینطوری الکی با تیپشون حال نکنه😌)
پس Fairness هم مثل Security و Privacy چیزی نیست که آخر پروژه یک چکلیست بذاریم کنارش و بگیم:
✅️ انجام شد خداحافظ!
باید از همون مراحل طراحی و جمعآوری داده بهش فکر کنیم.
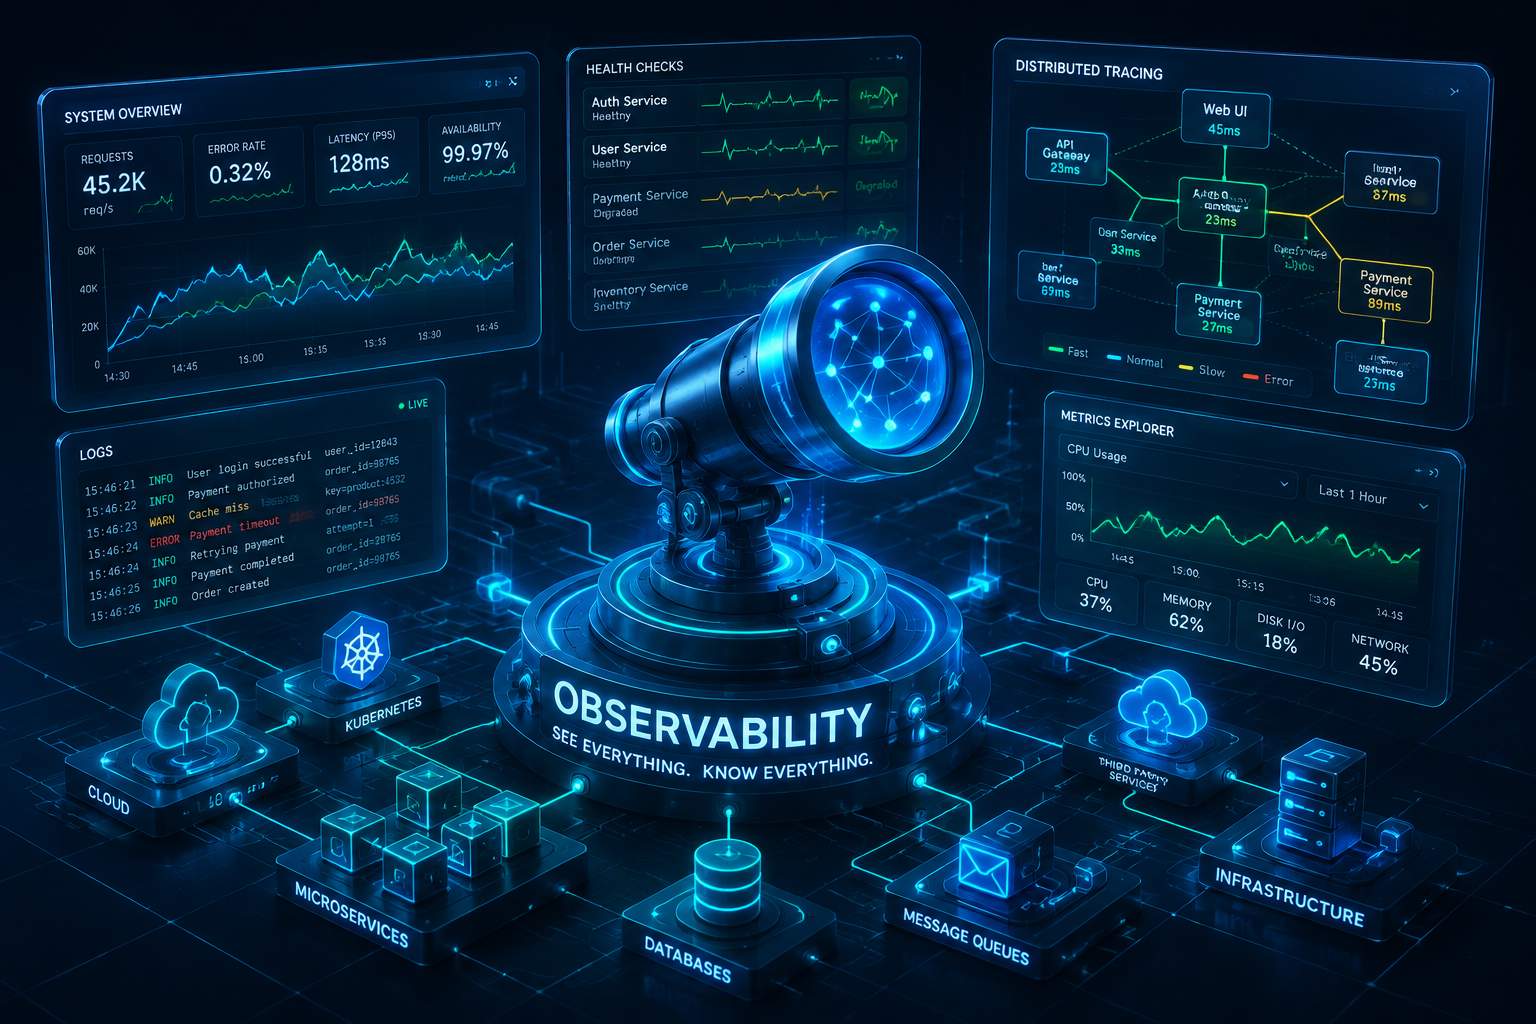
یکی از مفاهیمی که شخصاً برای من خیلی جذاب بود Observability بود.
Monitoring معمولاً به ما میگه:
چه اتفاقی افتاده؟
ولی Observability کمک میکنه بفهمیم:
چرا این اتفاق افتاده؟
و این تفاوت کوچیکی نیست.
در یک سیستم AI، ممکنه ببینیم Accuracy پایین اومده.
خب چرا؟
داده تغییر کرده؟
مدل Drift کرده؟
یک سرویس Down شده؟
Pipeline مشکل داشته؟
ورودیها تغییر کردن؟
یا اصلاً یک تغییر کوچک در یکی از اجزای سیستم باعث این اتفاق شده؟
اینجاست که Logs، Metrics، Traces، Events و Feedback اهمیت پیدا میکنن.
و به نظرم این یکی از جاهایی بود که ارتباط AI و معماری نرمافزار خیلی واضح خودش رو نشون میده.
چون وقتی سیستم پیچیدهتر میشه، فقط ساختنش مهم نیست؛ باید بتونیم بفهمیم داخلش چه خبره.
اینجا کتاب وارد چند Case Study میشه و به نظرم این بخش خیلی کمک میکنه که همهی بحثهای قبلی رو کنار هم بذاریم.
مثلاً در Case Study مربوط به Fraunhofer، یک سیستم Machine Learning از مرحلهی PoC تا Production بررس
ی میشه.
و نکته جالب اینه که در Production، صرفاً داشتن یک مدل خوب کافی نیست.
Monitoring، Feedback، Retraining و حتی ترکیب مدل با Rules و Heuristics وارد معماری میشن.
یعنی دوباره برمیگردیم به همون حرف اول:
مدل، کل سیستم نیست. مدل یک بخشی از سیستمه.
در Case Study مربوط به ARM Hub، کتاب سراغ یک RAG-based Chatbot میره.
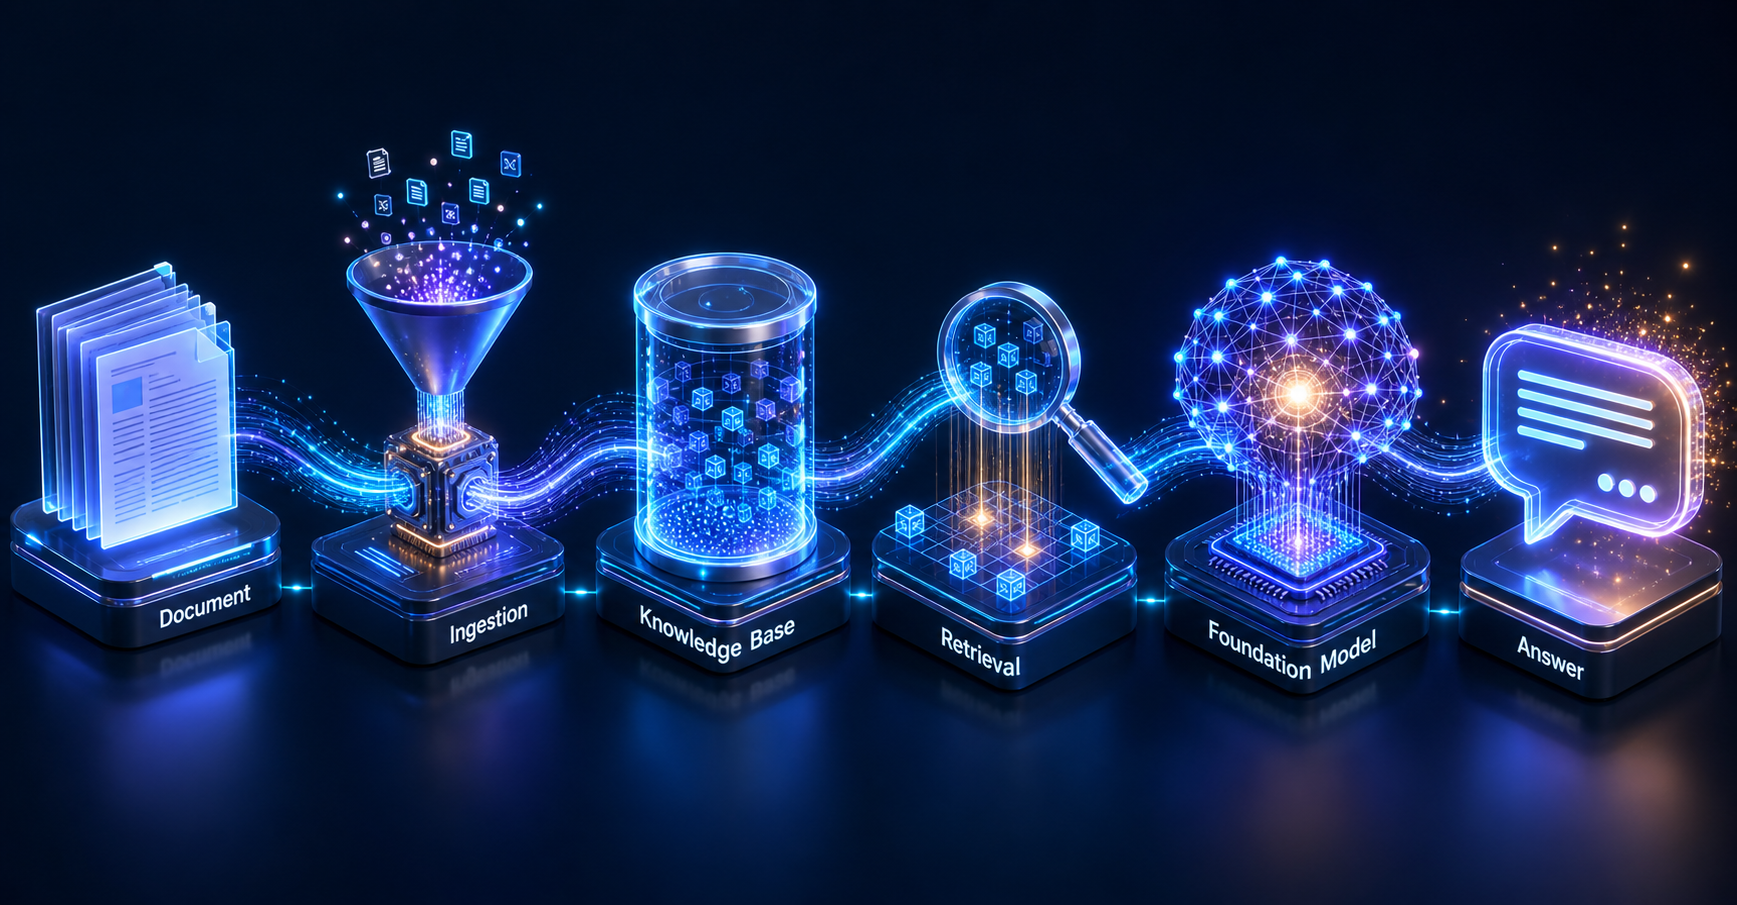
اینجا به جای اینکه انتظار داشته باشیم LLM همهی اطلاعات تخصصی سازمان رو از قبل بدونه، یک Knowledg Base داریم و اطلاعات مرتبط از طریق Retrieval پیدا میشن و در اختیار مدل قرار میگیرن.
اگر بخوام خیلی ساده بگم، روندش اینطوریه:
و باز هم میبینیم که LLM فقط یکی از اجزای ماجراست.
ETL داریم، Ingestion داریم، Knowledge Base داریم، Retrieval داریم، Model داریم و در نهایت MLOps و فرآیندهای نگهداری سیستم هم داریم.(بیا اینور بازار، همه چی داریم😌❤️)
یعنی حتی وقتی از یکی از داغترین تکنولوژیهای AI یعنی RAG حرف میزنیم، باز هم بدون معماری نرمافزار نمیتونیم یک سیستم واقعی و قابل اتکا داشته باشیم.
Case Study مربوط به بانکداری هم از همین زاویه جالبه.
مثلاً در Customer Churn Prediction هدف اینه که احتمال ترک مشتری پیشبینی بشه تا قبل از اینکه مشتری واقعاً بانک رو ترک کنه، اقدامات لازم انجام بشه.(پیشگیری بهتر از درمانه خلاصه)
ولی باز هم فقط Accuracy مدل مطرح نیست.
Data Quality، Model Calibration، Privacy، Security، Compliance و MLOps هم وارد بازی میشن.
چون وقتی داریم دربارهی دادههای حساس بانکی و تصمیمهایی صحبت میکنیم که ممکنه روی مشتری واقعی تأثیر بذارن، یک مدل نسبتاً دقیق به تنهایی کافی نیست.
اینجا دیگه واقعاً با یک سیستم مهندسیشده طرفیم و باید بدونیم چطوری باهاش تا کنیم.
بعد از اینکه کتاب از مبانی شروع میکنه، از AI و مدلها عبور میکنه، چرخهی حیات و Quality Attributes رو بررسی میکنه و چند Case Study واقعی رو نشونمون میده، در فصل آخر میرسه به یک سؤال:
حالا آیندهی AI Engineering چی میشه؟
بحثهایی مثل DevOps 2.0، AI-as-Software و نقش انسان در سیستمهای AI مطرح میشن.
یکی از ایدههای جالب اینه که ممکنه در آینده بخش بیشتری از منطق نرمافزار به جای اینکه به شکل Code سنتی نوشته بشه، در مدلهای AI قرار بگیره.
ولی این به معنی حذف مهندس نرمافزار نیست.
اتفاقاً شاید برعکس.
هرچی سیستمها پیچیدهتر بشن، نیاز به آدمهایی که بتونن این سیستمها رو طراحی، معماری، کنترل، پایش و قابل اعتماد کنن بیشتر میشه.
پس شاید آینده این نباشه که:
AI جای مهندس رو میگیره.
بلکه بیشتر شبیه این باشه که:
مهندس + AI → یک مدل جدید از مهندسی نرمافزار
خلاصه مهندسین نرمافزار عزیز فعلا نگران نباشین، حالا فعلا امنه
ادامهش هم خدا بزرگه، چو آینده شود فکر آینده کنیم.😅
و در نهایت چیزی که از این کتاب با من موند...
اگر بخوام کل این کتاب رو در یک جمله خلاصه کنم، احتمالاً میگم:
ساختن یک مدل AI، پایان کار نیست؛ تازه شروع مهندسی یک سیستم AI هست.
چیزی که این کتاب برای من جالب کرد این بود که AI رو از حالت یک مدل هوشمند بیرون میاره و میذاره وسط دنیای واقعی نرمافزار.
دنیایی که در اون باید با Failure کنار بیای.
باید Performance رو مدیریت کنی.
باید حواست به Security و Privacy باشه.
باید مراقب Fairness باشی.
باید بفهمی سیستم چرا خراب شده.
باید Data و Model رو در طول زمان مدیریت کنی.
و در نهایت باید کاری کنی که همهی این قطعات کنار هم، تبدیل به یک سیستم قابل اعتماد بشن.
به نظرم جذابترین بخش ماجرا هم همینجاست.
چون وقتی دربارهی AI حرف میزنیم، خیلی راحت جذب خود مدل میشیم؛ اینکه چند میلیارد پارامتر داره، چقدر Accuracy داره، چه Benchmarkی رو زده و چه کار عجیب و غریبی میتونه انجام بده.(آواز دهل از دور خوش است😶)
ولی وقتی از زاویهی مهندسی نرمافزار نگاه میکنی، سؤال عوض میشه.
دیگه فقط نمیپرسی:
این مدل چقدر باهوشه؟
میپرسی:
میتونیم باهاش یک سیستم بسازیم که واقعاً بشه بهش اعتماد کرد؟
و فکر میکنم دقیقاً همین سؤال، هستهی اصلی کتاب Engineering AI Systems باشه.
در نهایت، برای من این کتاب بیشتر از اینکه یک کتاب دربارهی AI باشه، یک یادآوری بود که:
هر تکنولوژی قدرتمندی، وقتی وارد دنیای واقعی میشه، به مهندسی خوب نیاز داره.
حتی اگر اون تکنولوژی خودش قرار باشه روزی بخشی از کار مهندسها رو انجام بده. 😄
ولی فعلا نترسید، ما همه با هم هستیم 😁❤️
خب خب خیلی ممنونم بابت وقتی که برای خوندنش گذاشتید، امیدوارم براتون مفید بوده باشه و انگیزهای بشه برای مطالعه این کتاب خوب
و همچنین یک تشکر ویژه از استاد عزیزم، دکتر صادق علیاکبری هیات علمی گروه نرمافزار دانشکده مهندسی کامپیوتر دانشگاه شهید بهشتی تهران که طبق معمول بانی خیر شدن و باعث شدن با این کتاب جذاب آشنا بشم
چون مطالعه این کتاب بخشی از تمرینهای درس معماری نرمافزار دانشگاه شهید بهشتی هست.
ممنونم از توجهتون
تنتون سالم و دلتون گرم و آروم🧡

