
اگر قسمت اول و دوم این مقاله را مطالعه نکرده اید بهتر است ابتدا به آن نگاهی بیاندازید.
اگر کسی بخواهد مثالی از برنامه NLP بیاورد، یکی از بهترین نمونه ها، ویژگی پیش بینی کلمه بعدی صفحه کلید تلفن هوشمند است. ویژگیای که میلیاردها نفر هر روز صدها بار از آن استفاده می کنند.
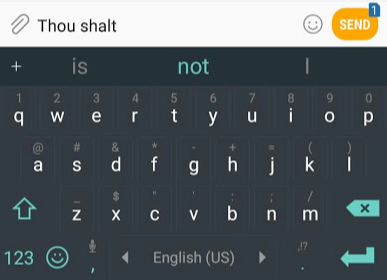
پیش بینی کلمه بعدی کاری است که می تواند توسط یک مدل زبان انجام شود. یک مدل زبان می تواند لیستی از کلمات را به عنوان ورودی بگیرد (اجازه دهید فقط دو کلمه را بگوییم) و سعی در پیش بینی کلمه ای دارد که به دنبال آن میآید.
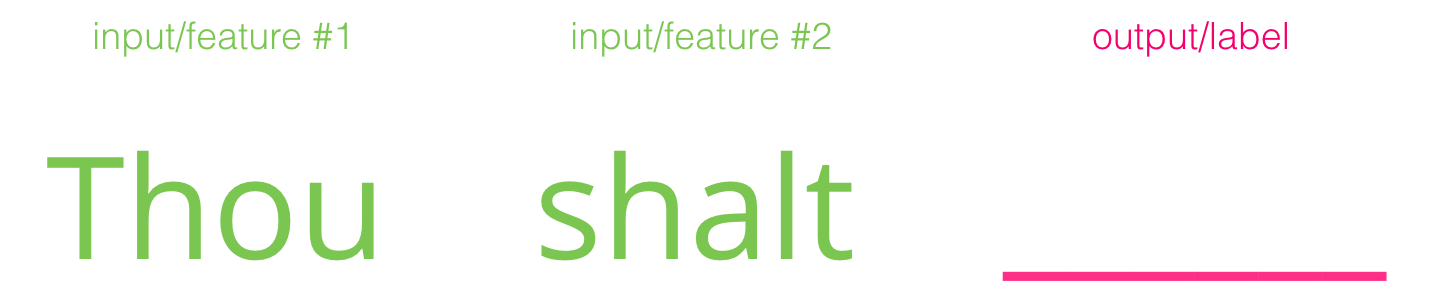
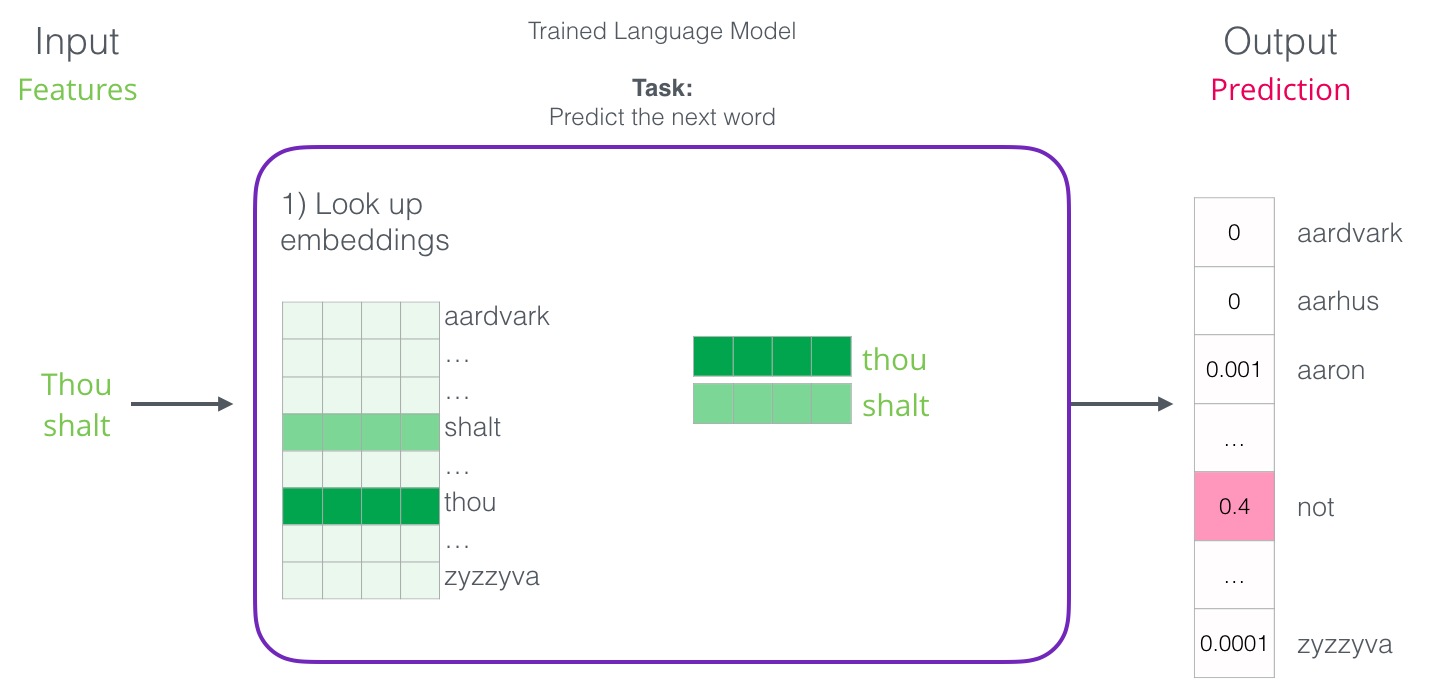
در تصویر زیر، به دنبال مدلی هستیم که این دو کلمه سبز را گرفته است (thou shalt) (به معنی تو باید) و لیستی از پیشنهادات را برگردانده است (نه فقط بالاترین احتمال را):
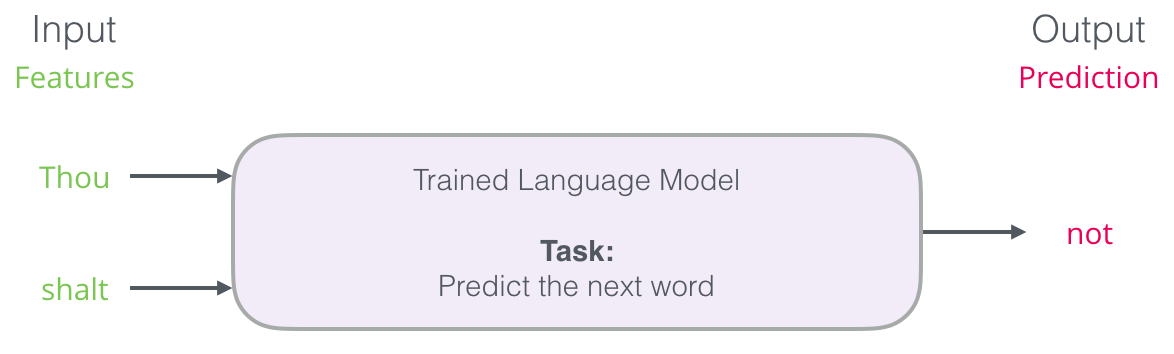
می توانیم مدل را شبیه این جعبه سیاه بدانیم:
اما در عمل ، این مدل فقط یک کلمه تولید نمی کند. در واقع برای همه واژگانی که بلد است یک امتیاز احتمالی ارائه می دهد ("واژه نامه" مدل که می تواند از چند هزار تا بیش از یک میلیون کلمه باشد) سپس برنامه "صفحه کلید" باید کلماتی را که بالاترین امتیاز را دارد را پیدا کند و آن را به کاربر ارائه دهد.
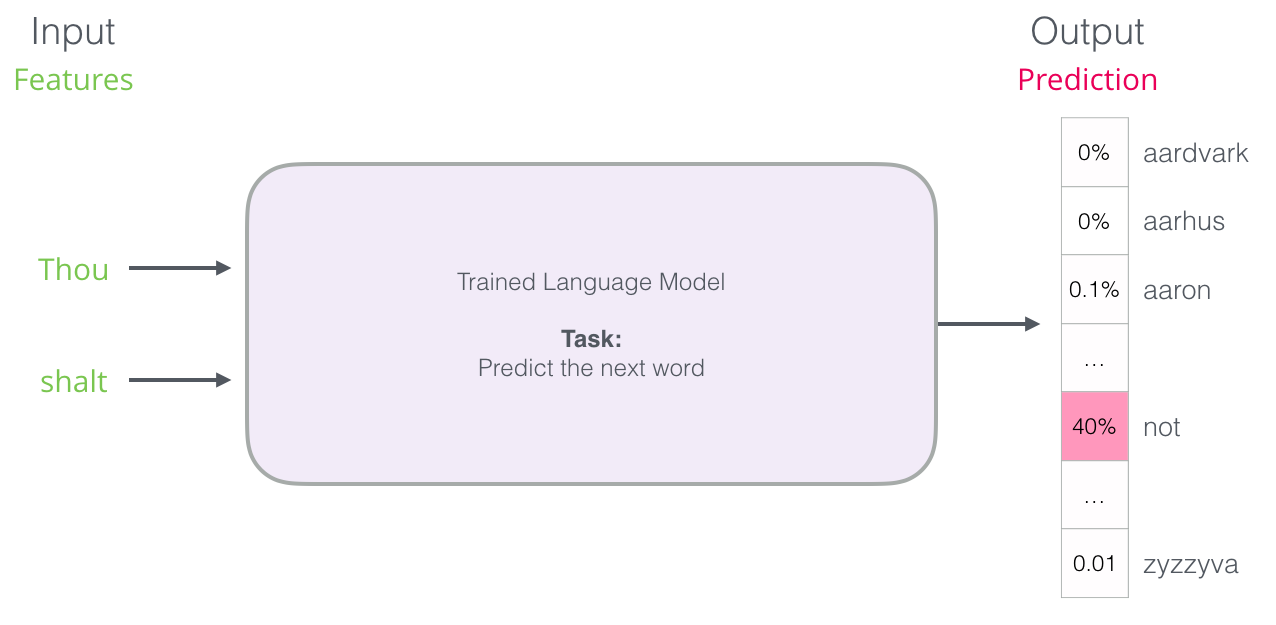
اولین قدم، جاسازی کلمات است. در فرآیند آموزش، ماتریسی که شامل جاسازی هر کلمه در واژه نامه است به دست آید. در زمان پیش بینی، ما از ماتریس جاسازی، کلمات ورودی را جستجو می کنیم و از آن برای محاسبه امتیاز پیش بینی استفاده می کنیم:
بیایید اکنون به فرایند آموزش برگردیم تا در مورد چگونگی توسعه ماتریس جاسازی کلمات، اطلاعات بیشتری کسب کنیم.
"با متوقف كردن فرآیند نمی توان آن را فهمید. درک باید با روند حرکت کند، به آن بپیوندد و با آن جریان یابد." ~Dune
مدلهای زبان نسبت به اکثر مدلهای یادگیری ماشین یک مزیت بزرگ دارند. مزیت آنها اینست که ما می توانیم آنها را با متن آموزش دهیم و از طرف دیگر متن هم زیاد در اختیار داریم. به همه کتابها، مقالات، محتوای ویکی پدیا و سایر فرمهای داده های متنی که در اطراف ماست فکر کنید. حالا این را با مدلهای یادگیری ماشین که به ویژگی دهی دستی و جمع آوری داده های مخصوص نیاز دارد ، مقایسه کنید.
جاسازی کلمات توسط ما انجام میشود و ما هستیم که می خواهیم کدام کلمه در کنار کدام کلمات ظاهر شوند. مکانیزم آن به این صورت است که:
1- ما داده های متنی زیادی را میگیریم (مثلاً تمام مقالات ویکی پدیا). سپس
2- ما یک پنجره داریم (مثلاً پنجره سه کلمه ای) که بر روی همه متن می لغزانیم.
3-پنجره کشویی نمونه های آموزشی را برای مدل ما ایجاد می کند.
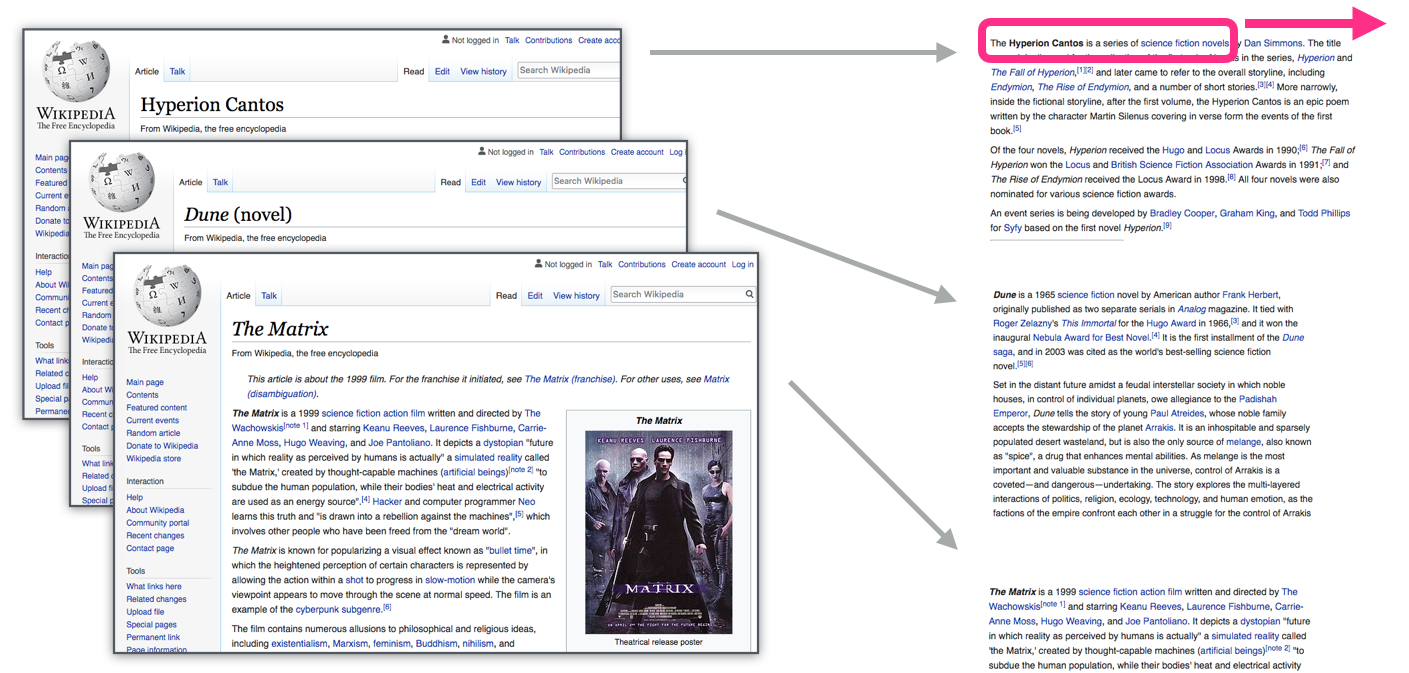
وقتی این پنجره در برابر متن قرار می گیرد ، ما عملا یک مجموعه داده تولید می کنیم که برای آموزش مدل استفاده می شود. برای بررسی دقیق نحوه انجام این کار ، بیایید ببینیم که پنجره کشویی چگونه این عبارت را پردازش می کند:
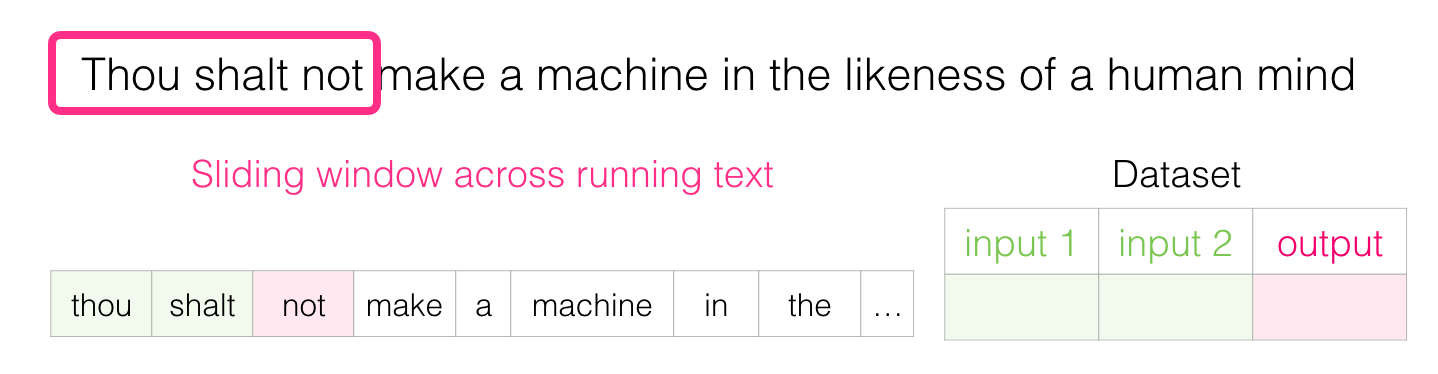
ما دو کلمه اول را به عنوان ویژگی می گیریم و کلمه سوم را برچسب می زنیم:
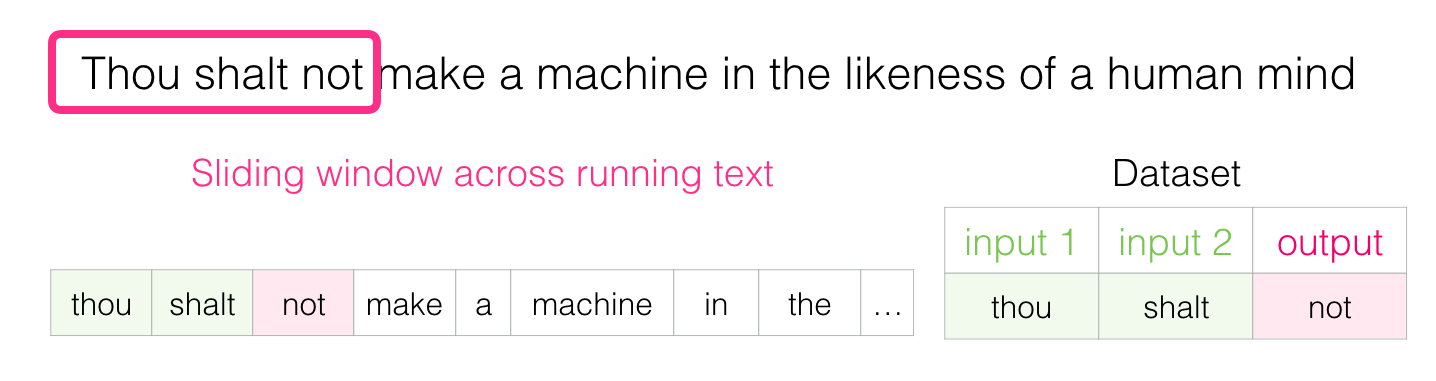
سپس پنجره خود را به موقعیت بعدی می کشیم و نمونه دوم را ایجاد می کنیم:
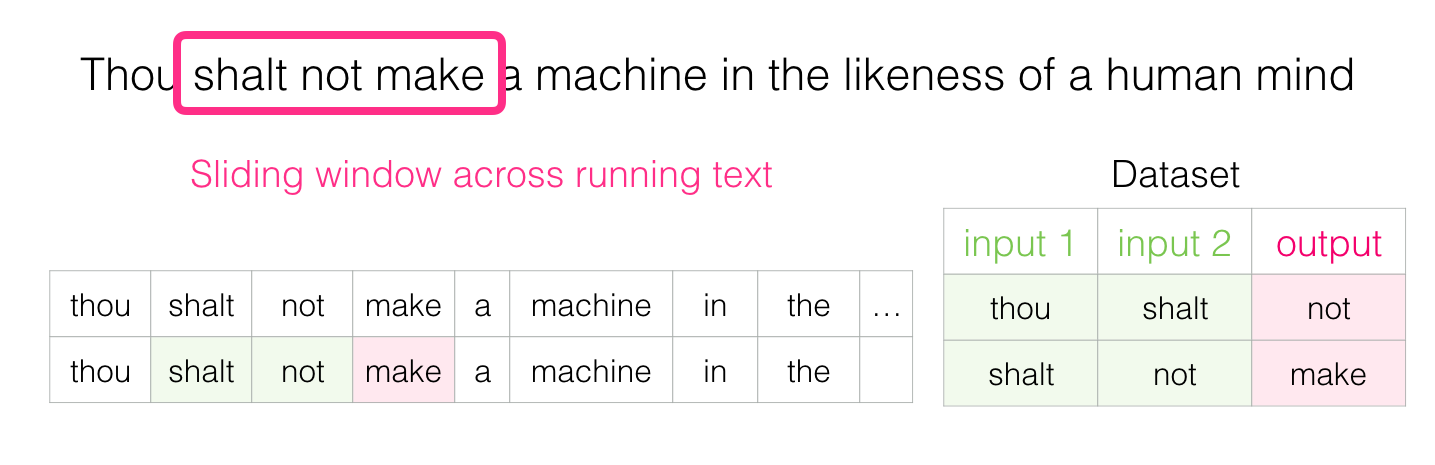
و خیلی زود یک مجموعه داده بزرگ داریم که در آن تمایل پدیداری کلمات بعد از جفت کلمات مختلف مشخص شده است:
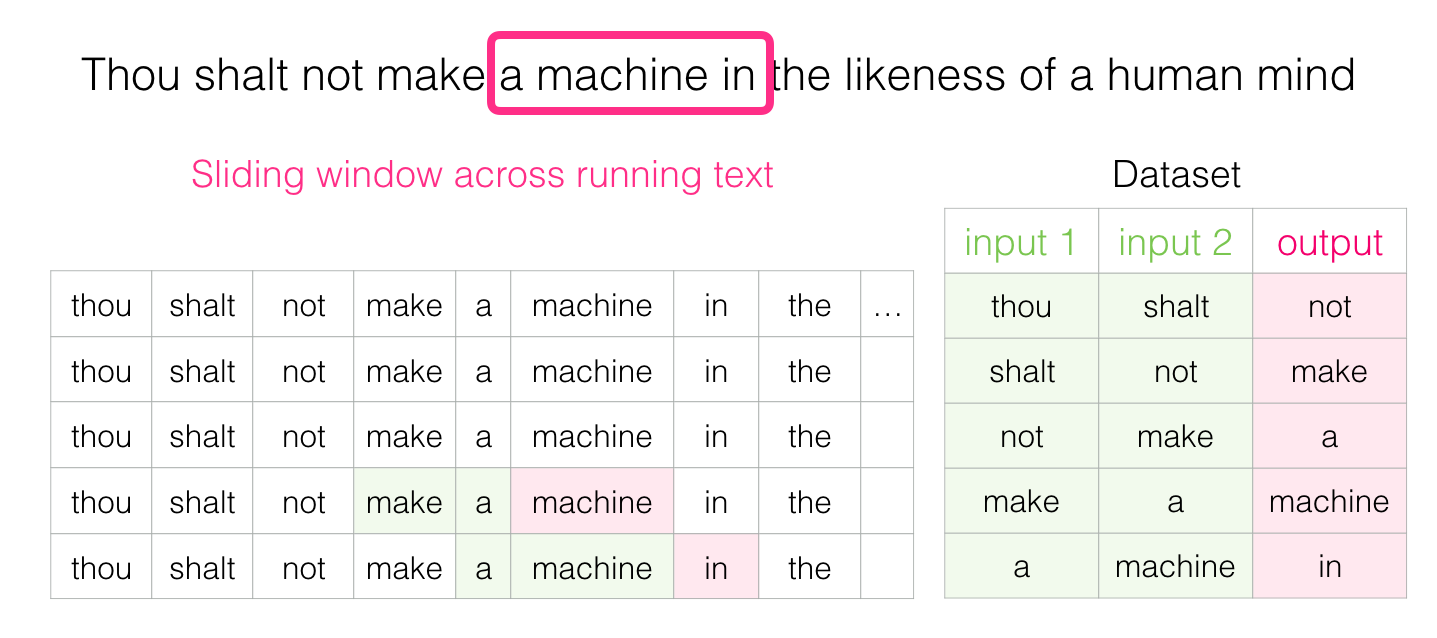
در عمل ، وقتی ما پنجره را حرکت میدهیم ، مدل ما آموزش می بیند. البته تفکیک مرحله "تولید مجموعه داده" از مرحله "آموزش" مشخص است. گذشته از رویکردهای مبتنی بر شبکه عصبی در مدل سازی زبان ، معمولاً از روشی به نام N-gram برای آموزش مدل های زبان استفاده می شود (نگاه کنید به: فصل 3 پردازش گفتار و زبان). برای مشاهده چگونگی تغییرات مدل از N-gram به مدل عصبی بر روی محصولات دنیای واقعی ، در اینجا یک پست 2015 وبلاگ از Swiftkey ، صفحه کلید Android، که در آن مدل زبان عصبی خود را معرفی کرده و آن را با مدل قبلی N-gram مقایسه می کند را بررسی میکنیم. این مثال را دوست دارم چون به شما نشان می دهد چگونه می توان ویژگیهای الگوریتمی جاسازی کلمه در مباحث تجاری نشان داد.
"پارادوکس نوعی اشاره گر است که به شما می گوید فراتر از آن نگاه کنید. اگر پارادوکس شما را آزار می دهد ، تمایل شما برای مطلق بودن را نشان میدهد. نسبی گرایی با یک پارادوکس به عنوان یک تفکر جالب یا شاید سرگرم کننده یا حتی ترسناک برخورد می کند." ~ God Emperor of Dune
با دانستن آنچه که از اوایل پست می دانید ، جای خالی را پر کنید:
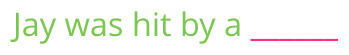
متنی که در اینجا داریم پنج کلمه قبل از کلمه خالی است (و نزدیک ترین کلمه که به آن اشاره میکند "اتوبوس" است). من مطمئنم که اکثر مردم کلمه اتوبوس در جای خالی حدس می زنند. اما اگر من یک اطلاعات دیگر به شما بدهم - یک کلمه بعد از جای خالی ، آیا این پاسخ شما را تغییر می دهد؟
این عبارت کاملا آنچه را که باید در جای خالی باشد عوض می کند. اکنون کلمه "قرمز" به احتمال زیاد جای خالی را پر میکند. پس ما یاد گرفتیم کلمات قبل و بعد از یک کلمه خاص دارای ارزش اطلاعاتی هستند. پس به نظر می رسد که محاسبات از هر دو جهت (کلمات سمت چپ و راست کلمه ای که حدس می زنیم) منجر به جاسازی بهتر کلمه می شود. بیایید ببینیم که چگونه می توانیم روش آموزش مدل را متناسب با این مورد تنظیم کنیم.

