از زمان انتشار ChatGPT،مدل های زبان بزرگ (LLM) محبوبیت زیادی به دست آورده اند. مدلهای زبان بزرگ (LLM) مدلهای یادگیری ماشینی قدرتمندی هستند که برای طیف گستردهای از کاربردها میتوانند استفاده شوند، مثل:
LLM ها از پیش آموزش دیده هستند، یعنی بر روی مجموعه دادههای عظیم متنی آموزش دیدهاند. این یعنی که میتوانند الگوهای زبانی را درک کنند و از آنها برای تولید متن استفاده کنند.
با این حال، LLMها به تنهایی برای ساخت برنامههای قدرتمند کافی نیستند. قدرت واقعی زمانی ظاهر می شود که بتوانید آنها را با منابع محاسباتی یا اطلاعات دیگر ترکیب کنید.
در این آموزش، Langchain را بررسی میکنیم، یک کتابخانه که به ما امکان میدهد برنامه های AI را با ترکیب اجزای مختلف مانند Model Wrappers، Chains، Agents و غیره توسعه دهیم.
کتابخانه LangChain هم به صورت پایتون و هم به صورت جاوا اسکریپت در دسترس است، ولی ما برای این آموزش از کتابخانه پایتون استفاده می کنیم.
LangChain یک فریمورک متنباز (مخزن گیتهاب) است که به شما کمک میکند تا برنامههای مبتنی بر مدلهای زبان بزرگ (LLM) را آسانتر بسازید:
از آنجایی که LangChain دارای قابلیتهای مختلفی است، ممکن است در ابتدا درک آن دشوار باشد. به همین دلیل در این پست به بررسی شش ماژول کلیدی LangChain خواهیم پرداخت تا درک بهتری از تواناییهای آن به دست آوریم.
برای نصب بسته LangChain پایتون، می توانید آن را با pip نصب کنید.
pip install langchain
پس از نصب، بسته LangChain پایتون را import کنید.
import langchain
برای ساخت یک برنامه با LLM، به کلیدهای API برای بعضی از خدماتی که می خواهید استفاده کنید نیاز دارید. برای استفاده از برخی از این APIها بایستی هزینه آن را پرداخت کنید.
مدلهای اختصاصی، مدلهای قدرتمندی هستند که توسط شرکتهای بزرگ با منابع مالی و متخصصان فراوان توسعه داده میشوند. این مدلها معمولاً از مدلهای متنباز بزرگتر هستند و بنابراین عملکرد بهتری دارند. با این حال، APIهای آنها نیز گرانتر هستند. نمونه هایی از ارائه دهندگان مدل اختصاصی OpenAI، co:here، AI21 Labs یا Anthropic هستند.
بیشتر آموزش های موجود LangChain از OpenAI استفاده میکنند، اما توجه داشته باشید که OpenAI API برای تست گران نیست اما رایگان هم نیست. برای دریافت کلید OpenAI API، به یک حساب OpenAI و سپس «Create new secret key» در بخش API keys نیاز دارید.
import os
os.environ["OPENAI_API_KEY"] = ... # insert your API_TOKEN here
مدلهای متنباز معمولاً مدلهای کوچکتر با قابلیتهای کمتر نسبت به مدلهای اختصاصی هستند، اما مقرون به صرفهتر از مدلهای اختصاصی هستند. نمونههایی از مدلهای منبع باز عبارتند از:
بسیاری از مدلهای متنباز در Hugging Face میزبانی میشوند. برای به دست آوردن کلید API Hugging Face، به یک حساب کاربری Hugging Face نیاز دارید و «New token» در زیر Access Tokens ایجاد کنید.
import os
os.environ["HUGGINGFACEHUB_API_TOKEN"] = ... # insert your API_TOKEN here
میتوانید از Hugging Face به صورت رایگان برای LLMهای متنباز استفاده کنید، اما محدود به LLMهای کوچکتر با عملکرد کمتر خواهید شد.
راهنمای شخصی: برای اکثر مثالها میتوان مدلهای متنباز را استفاده کرد که در اکثر موارد کار میکند، اما استفاده از آن در چند مورد دردسرساز میشود. پیشنهاد میکنم یک حساب برای OpenAI بسازید و با خرید یک شماره مجازی (مثلا از این سایت) به توکن API آن دسترسی داشته باشید. به نظر میرسد اکثر مثالهای LangChain برای API OpenAI بهینه شدهاند.
دیتابیس برداری
اگر میخواهید از یک پایگاه داده برداری خاص مانند Pinecone، Weaviate یا Milvus استفاده کنید، باید برای آنها ثبتنام کنید تا یک کلید API دریافت کنید که باید قیمت آنها را هم بررسی کنید. در این آموزش از Faiss استفاده میکنیم که نیازی به ثبتنام ندارد.
بسته به ابزارهایی که میخواهید LLM با آنها تعامل داشته باشد مانند اطلاعات آب و هوا OpenWeatherMap یا SerpAPI، ممکن است لازم باشد برای آنها ثبتنام کنید تا یک کلید API دریافت کنید. در این آموزش، ما فقط از ابزارهایی استفاده می کنیم که نیازی به کلید API ندارند.
LangChain (نسخه 0.0.147) شش ماژول زیر را پوشش میدهد:
کدهای نمونه در بخشهای بعدی از مستندات LangChain کپی و اصلاح شدهاند.
در حال حاضر، LLM های بسیاری در حال ظهور هستند. LangChain یکپارچهسازی با طیف گستردهای از مدلها و ایجاد یک رابط کاربری کارآمد برای آنها را ارائه میدهد.
LangChain بین سه نوع مدل که در ورودی و خروجی متفاوت هستند تفاوت قائل میشود:
# Proprietary LLM from e.g. OpenAI
# pip install openai
from langchain.llms import OpenAI
llm = OpenAI(model_name="text-davinci-003")

# Alternatively, open-source LLM hosted on Hugging Face
# pip install huggingface_hub
from langchain import HuggingFaceHub
llm = HuggingFaceHub(repo_id = "google/flan-t5-xl")

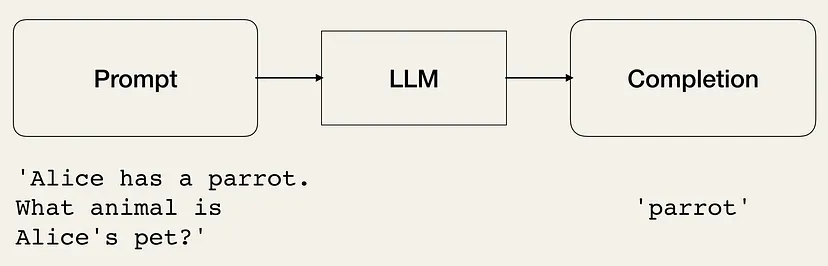
# The LLM takes a prompt as an input and outputs a completion
prompt = "Alice has a parrot. What animal is Alice's pet?"
completion = llm(prompt)
# Proprietary text embedding model from e.g. OpenAI
# pip install tiktoken
from langchain.embeddings import OpenAIEmbeddings
embeddings = OpenAIEmbeddings()

# Alternatively, open-source text embedding model hosted on Hugging Face
# pip install sentence_transformers
from langchain.embeddings import HuggingFaceEmbeddings
embeddings = HuggingFaceEmbeddings(model_name = "sentence-transformers/all-MiniLM-L6-v2")

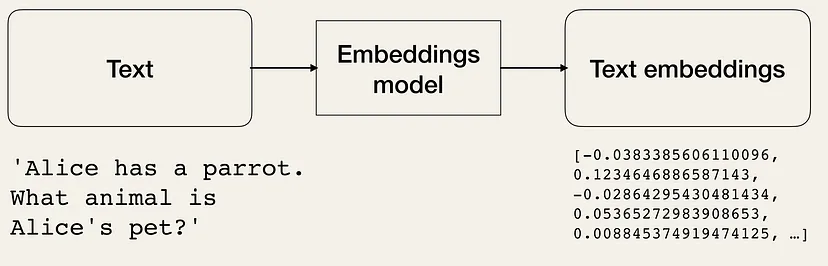
# The embeddings model takes a text as an input and outputs a list of floats
text = "Alice has a parrot. What animal is Alice's pet?"
text_embedding = embeddings.embed_query(text)
LLM ها دارای ویژگیهای عجیب و غریب هستند. اگرچه وارد کردن پرامپتها به زبان طبیعی نباید پیچیدگی خاصی داشته باشد، اما تا زمانی که خروجی دلخواه را از LLM دریافت کنید، نیاز به مقداری تنظیم پرامپت دارید. این فرایند به نام مهندسی پرامپت (prompt engineering) خوانده می شود.
هنگامی که یک پرامپت خوب دارید، ممکن است بخواهید از آن به عنوان یک قالب برای سایر موارد استفاده کنید. بنابراین، LangChain به شما PromptTemplates را ارائه میدهد که به شما کمک میکند تا پرامپتهای خود را از چند مؤلفه تشکیل دهید.
from langchain import PromptTemplate

template = "What is a good name for a company that makes {product}?"

prompt = PromptTemplate(
    input_variables=["product"],
    template=template,
)

prompt.format(product="colorful socks")
پرامپت بالا را می توان به عنوان یک تنظیم zero-shot در نظر گرفت که در آن امیدوارید LLM بر روی دادههای مرتبط به اندازه کافی برای ارائه پاسخ رضایتبخش، آموزش دیده باشد.
یکی دیگر از ترفندها برای گرفتن خروجی بهتر اضافه کردن چند مثال در پرامپت و تبدیل آن به یک تنظیم few-shot است.
from langchain import PromptTemplate, FewShotPromptTemplate

examples = [
    {"word": "happy", "antonym": "sad"},
    {"word": "tall", "antonym": "short"},
]

example_template = """
Word: {word}
Antonym: {antonym}\n
"""

example_prompt = PromptTemplate(
    input_variables=["word", "antonym"],
    template=example_template,
)

few_shot_prompt = FewShotPromptTemplate(
    examples=examples,
    example_prompt=example_prompt,
    prefix="Give the antonym of every input",
    suffix="Word: {input}\nAntonym:",
    input_variables=["input"],
    example_separator="\n",
)

few_shot_prompt.format(input="big")
کد بالا یک قالب پرامپت ایجاد میکند و بر اساس مثالها و ورودیها، دستور زیر را می نویسد:
Give the antonym of every input

Word: happy
Antonym: sad

Word: tall
Antonym: short

Word: big
Antonym:
Chaining در LangChain به سادگی فرآیند ترکیب LLMها با اجزای دیگر برای ایجاد یک برنامه کاربردی را توصیف میکند. چند نمونه عبارتند از:
در قسمت قبل یک قالب پرامپت ایجاد کردیم. هنگامی که می خواهیم از آن برای LLM خودمان استفاده کنیم، می توانیم از یک LLMChainبه صورت زیر استفاده کنیم:
from langchain.chains import LLMChain

chain = LLMChain(llm = llm,
                  prompt = prompt)

# Run the chain only specifying the input variable.
chain.run("colorful socks")
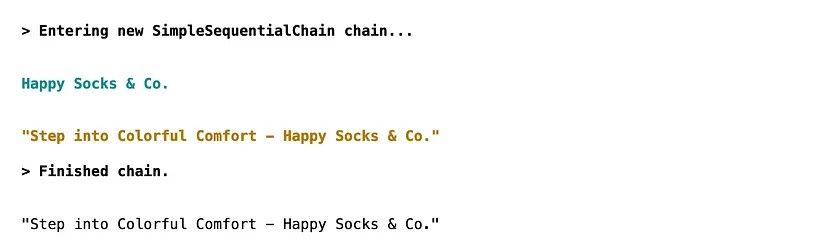
اگر بخواهیم از خروجی این LLM اول به عنوان ورودی برای LLM دوم استفاده کنیم، میتوانیم از SimpleSequentialChain استفاده کنیم:
from langchain.chains import LLMChain, SimpleSequentialChain

# Define the first chain as in the previous code example
# ...

# Create a second chain with a prompt template and an LLM
second_prompt = PromptTemplate(
    input_variables=["company_name"],
    template="Write a catchphrase for the following company: {company_name}",
)

chain_two = LLMChain(llm=llm, prompt=second_prompt)

# Combine the first and the second chain
overall_chain = SimpleSequentialChain(chains=[chain, chain_two], verbose=True)

# Run the chain specifying only the input variable for the first chain.
catchphrase = overall_chain.run("colorful socks")
یکی از محدودیتهای LLMها فقدان اطلاعاتی مانند دسترسی به برخی اسناد یا ایمیلهای خاص است. شما میتوانید با دادن دسترسی LLMها به دادههای خارجی با این موضوع مبارزه کنید.
برای این کار ابتدا باید دادههای خارجی را با یک بارگذار سند بارگیری کنید. LangChain انواع لودرها را برای انواع مختلف اسناد اعم از PDF و ایمیل گرفته تا وب سایتها و ویدیوهای YouTube ارائه میدهد.
بیایید برخی از داده های خارجی را از یک ویدیوی YouTube بارگیری کنیم. اگر می خواهید یک سند متنی بزرگ را بارگیری کنید و آن را با یک تقسیم کننده متن تقسیم کنید، می توانید به داکیومنت LangChain مراجعه کنید.
# pip install youtube-transcript-api
# pip install pytube

from langchain.document_loaders import YoutubeLoader

loader = YoutubeLoader.from_youtube_url("https://www.youtube.com/watch?v=dQw4w9WgXcQ")

documents = loader.load()
در اینجا دادهها را آماده ارسال با اسم documentsدارید، می توانید آن را با یک مدل امبدینگ متن در یک دیتابیس برداری (یک VectorStore) فهرست کنید. دیتابیس برداری محبوب شامل Pinecone، Weaviate و Milvus است. در این پست، ما از Faiss استفاده میکنیم چون به کلید API نیاز ندارد.
# pip install faiss-cpu
from langchain.vectorstores import FAISS

# create the vectorestore to use as the index
db = FAISS.from_documents(documents, embeddings)
سند شما (در اینجا، یک ویدیو) به عنوان امبدینگ در یک دیتابیس برداری ذخیره می شود.
حالا میتوانید کارهای مختلفی را با این دادههای خارجی انجام دهید. بیایید از آن برای پاسخگویی به سؤال با بازیابی اطلاعات استفاده کنیم:
from langchain.chains import RetrievalQA

retriever = db.as_retriever()

qa = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=retriever,
    return_source_documents=True)

query = "What am I never going to do?"
result = qa({"query": query})

print(result['result'])
خروجی RetrievalQA:
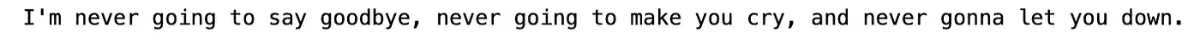
برای برنامه هایی مانند ربات های چت، ضروری است که آنها بتوانند مکالمات قبلی را به خاطر بسپارند. اما به طور پیشفرض، LLMها هیچ حافظه بلندمدتی ندارند مگر اینکه تاریخچه چت را وارد کنید.
LangChain این مشکل را با ارائه چند گزینه مختلف برای مقابله با تاریخچه چت حل می کند:
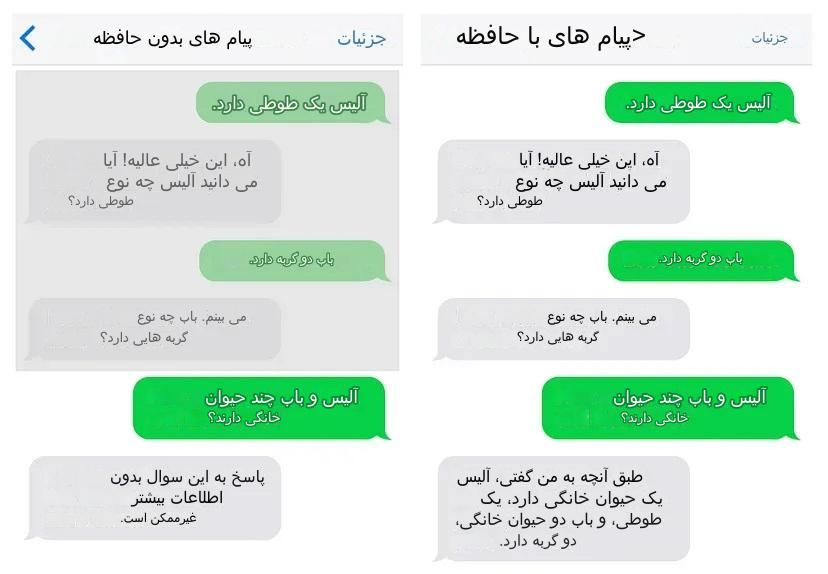
در این مثال، ما از یک ConversationChainبرای دادن حافظه مکالمه به این برنامه استفاده خواهیم کرد.
from langchain import ConversationChain

conversation = ConversationChain(llm=llm, verbose=True)

conversation.predict(input="Alice has a parrot.")

conversation.predict(input="Bob has two cats.")

conversation.predict(input="How many pets do Alice and Bob have?")
این منجر به مکالمه سمت راست در تصویر زیر می شود. بدون ConversationChainبرای حفظ یک حافظه مکالمه، مکالمه مانند مکالمه سمت چپ خواهد بود.
علیرغم قدرتمند بودن، LLM ها محدودیتهایی هم دارند: آنها فاقد اطلاعات زمینهای هستند (مانند دسترسی به دانش خاصی که در دادههای آموزش موجود نبوده) یا اطلاعاتی که میتوانند به سرعت منسوخ شوند (به عنوان مثال، GPT-4 بر روی دادههای قبل از سپتامبر 2021 آموزش داده شده است) و یا اینکه آنها در ریاضی واقعا بد هستند.
از آنجایی که LLMها میتوانند در مورد کارهایی که به تنهایی نمی توانند انجام دهند توهم بزنند ما باید به آنها دسترسی به ابزارهای تکمیلی مانند جستجو (به عنوان مثال جستجوی گوگل)، ماشین حساب (مانند Python REPL یا Wolfram Alpha) بدهیم.
علاوه بر این، ما به عاملهایی نیاز داریم که در مورد استفاده از ابزارها برای انجام یک کار بر اساس خروجی LLM تصمیم بگیرند.
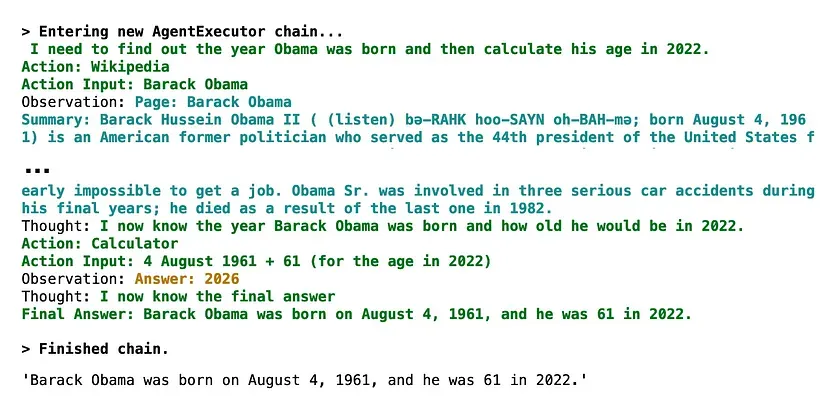
در زیر مثالی وجود دارد که در آن ایجنت ابتدا تاریخ تولد باراک اوباما را با ویکیپدیا جستجو میکند و سپس سن او را در سال 2022 با ماشین حساب محاسبه میکند.
# pip install wikipedia
from langchain.agents import load_tools
from langchain.agents import initialize_agent
from langchain.agents import AgentType

tools = load_tools(["wikipedia", "llm-math"], llm=llm)
agent = initialize_agent(tools,
                         llm,
                         agent=AgentType.ZERO_SHOT_REACT_DESCRIPTION,
                         verbose=True)


agent.run("When was Barack Obama born? How old was he in 2022?")