
اگر قسمت اول و دوم و سوم این مقاله را مطالعه نکرده اید بهتر است ابتدا به آن نگاهی بیاندازید.
به جای اینکه فقط دو کلمه قبل از کلمه مورد نظر جستجو کنیم ، می توانیم به دو کلمه بعد از آن هم نگاه کنیم.
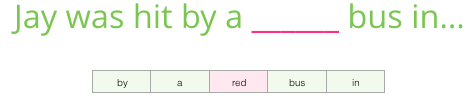
با انجام این کار مجموعه داده ای که ما در حال ساخت و آموزش مدل ارائه می دهیم به این شکل خواهد بود:
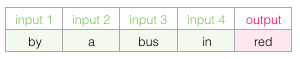
این معماری Bag of Words پیوسته نامیده می شود و در یکی از مقالات word2vec شرح داده شده است.
معماری دیگر به جای حدس یک کلمه بر اساس زمینه آن (کلمات قبل و بعد از آن) ، سعی می کند کلمات همسایه را با استفاده از کلمه فعلی حدس بزند. می توانیم پنجره ای را که در برابر متن آموزشی قرار می گیرد به این شکل بدانیم:
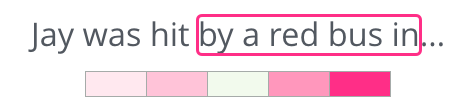
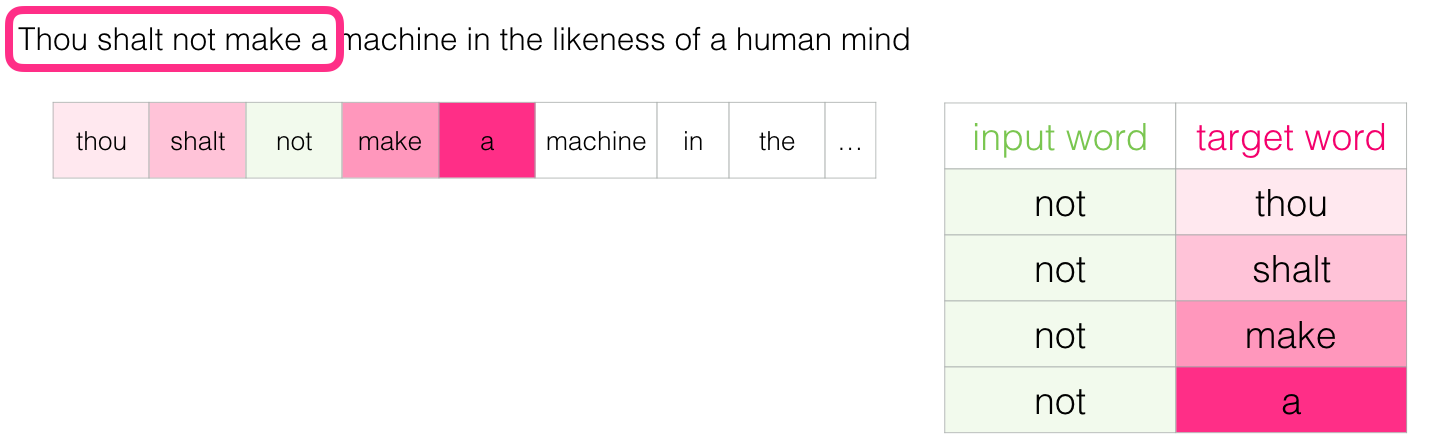
باکس صورتی در زیر جمله با سایه های مختلف ترسیم شده است چون این پنجره کشویی در واقع چهار نمونه جداگانه در مجموعه آموزش ما ایجاد می کند:
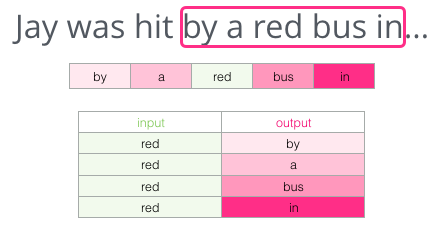
این روش معماری skipgram نامیده می شود. ما می توانیم با پنجره کشویی بصورت زیر عمل کنیم:
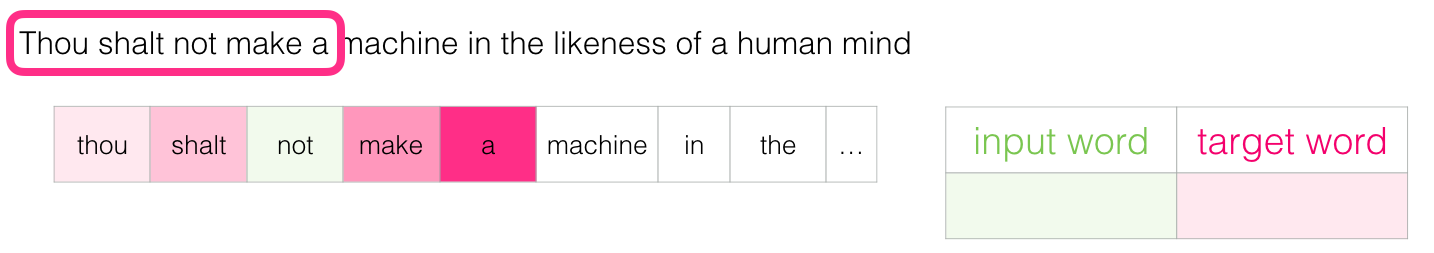
این عبارت چهار نمونه را به مجموعه آموزش ما اضافه می کند:
سپس پنجره خود را به موقعیت بعدی می کشیم:
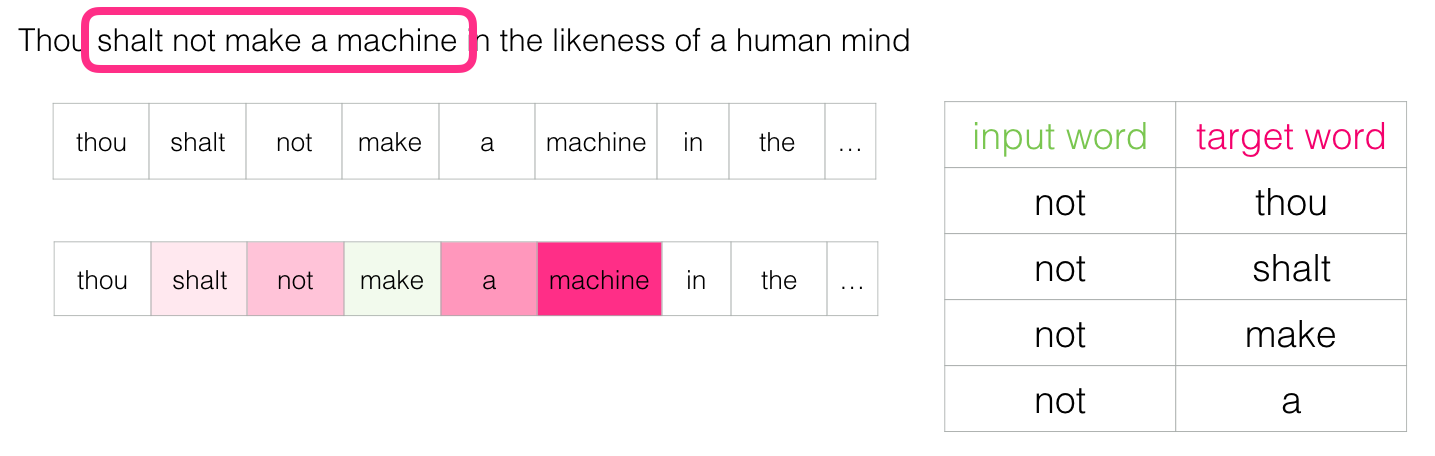
که چهار مثال بعدی ما را ایجاد می کند:
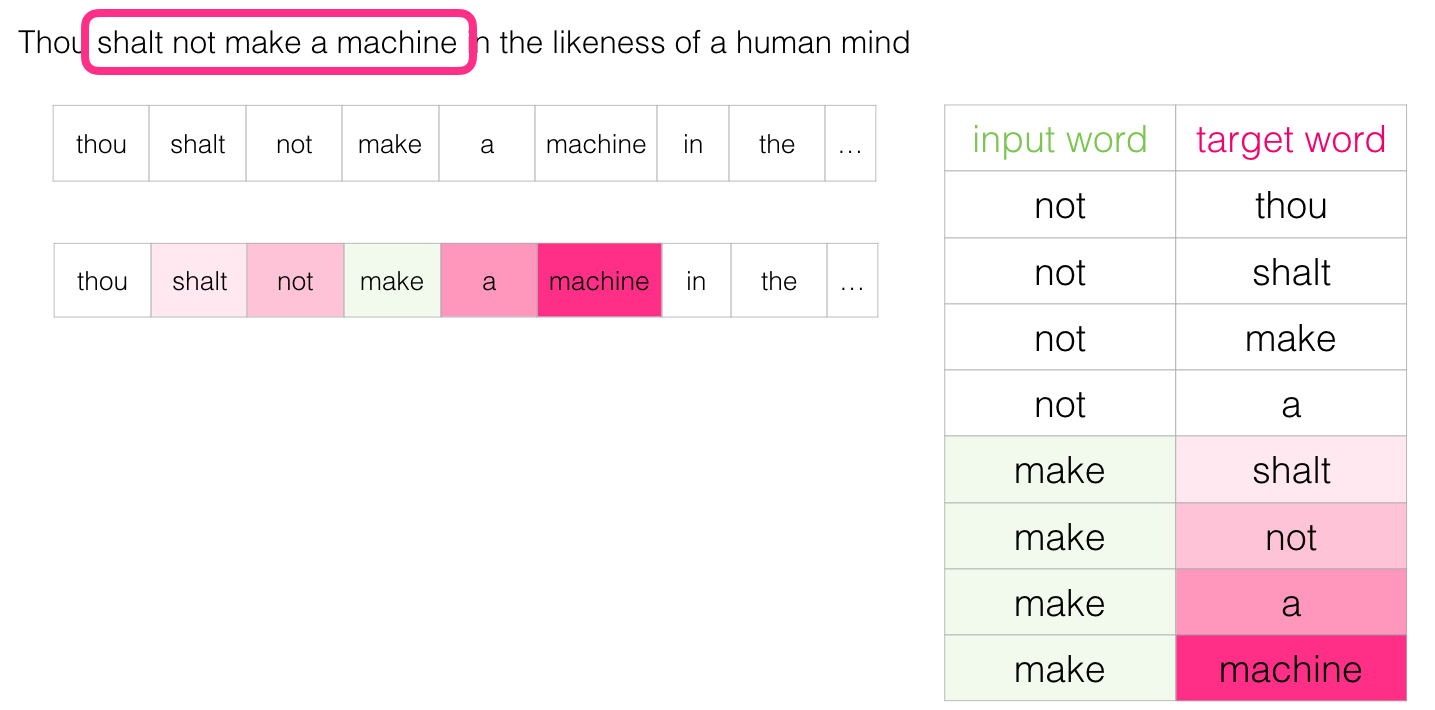
چند موقعیت بعد ، ما نمونه های بسیار بیشتری داریم:
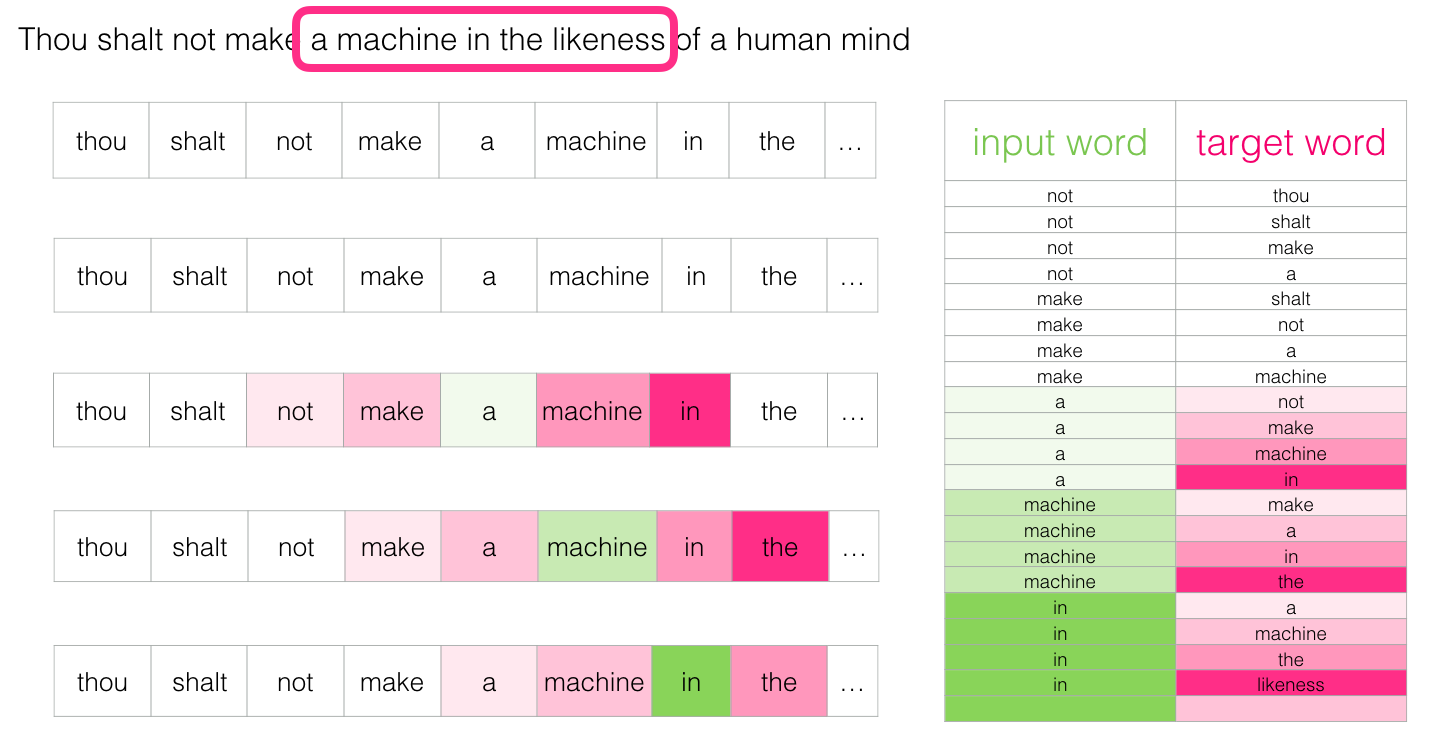
اکنون که مجموعه داده های آموزش اسکیپگرام را که از متن موجود موجود استخراج کرده ایم را داریم، بیایید نگاهی به نحوه استفاده از آن برای آموزش یک مدل اساسی زبان عصبی که کلمه همسایه را پیش بینی می کند ، بیاندازیم.
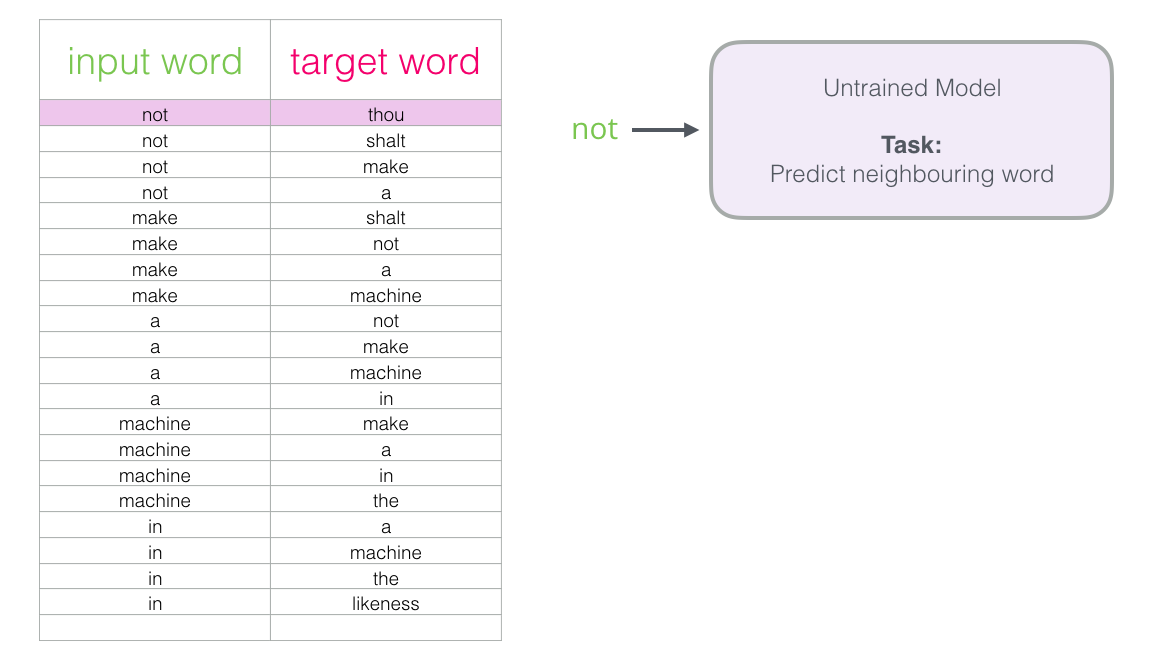
با اولین نمونه در مجموعه داده خود شروع می کنیم. این ویژگی را می گیریم و به مدل آموزش ندیده می خورانیم که از آن می خواهد یک کلمه همسایه مناسب را پیش بینی کند.
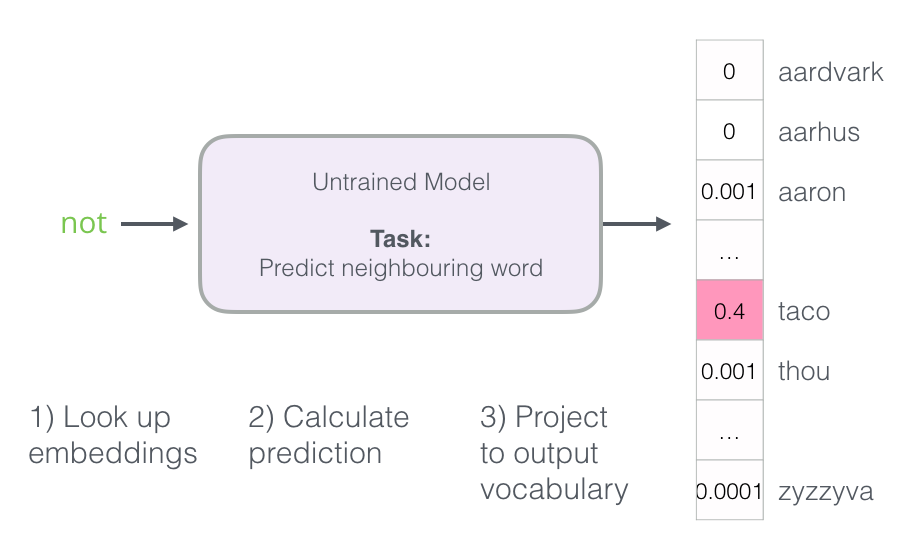
این مدل سه مرحله را انجام می دهد و یک بردار پیش بینی (با احتمال اختصاص داده شده به هر کلمه در واژگان آن) را خارج می کند. از آنجا که این مدل آموزش ندیده است ، مطمئناً پیش بینی آن در این مرحله اشتباه است. اما مشکلی نیست ما می دانیم که چه کلمه ای باید حدس زده باشد - ستون برچسب/خروجی در ردیفی که در حال حاضر برای آموزش مدل استفاده می کنیم:
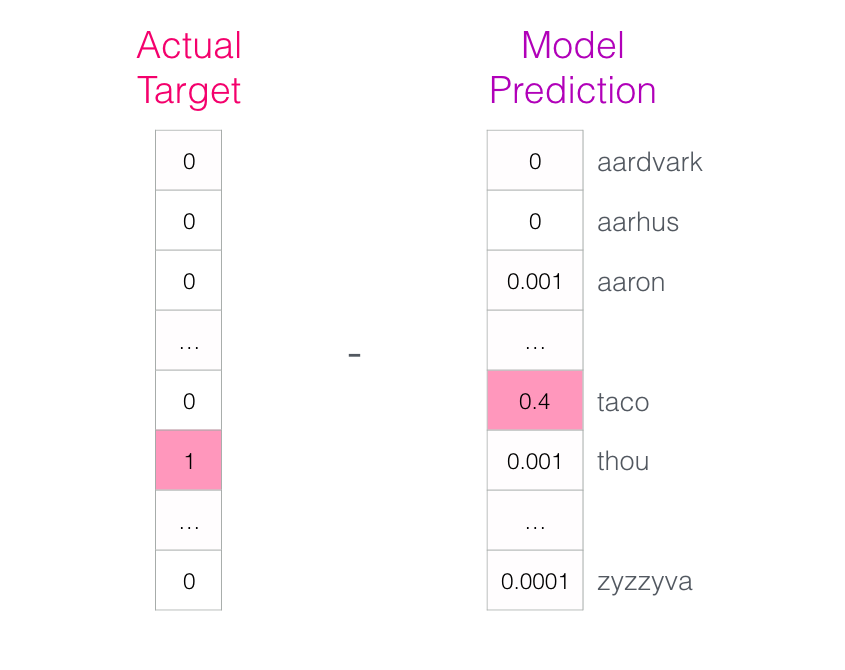
مدل چقدر فاصله داشت؟ ما دو بردار را از هم کم میکنیم و یک بردار خطا به عنوان نتیجه داریم:
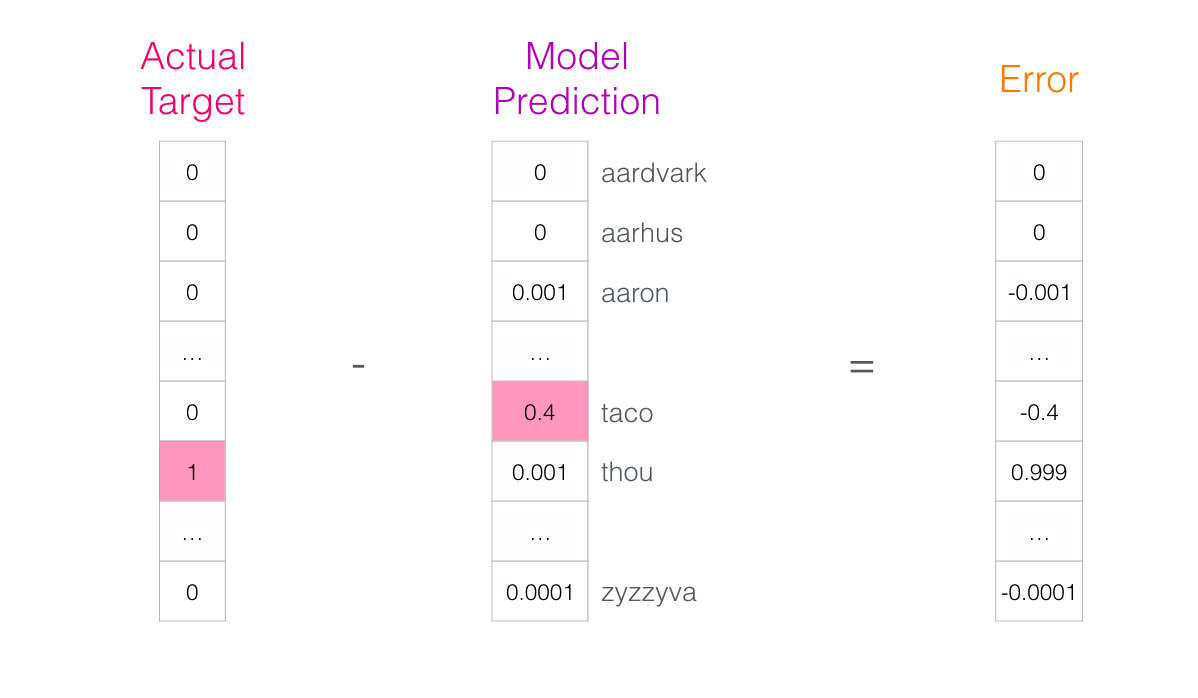
این بردار خطا اکنون می تواند برای به روزرسانی مدل مورد استفاده قرار گیرد ، بنابراین دفعه بعدی ، احتمال اینکه کلمه thou را حدس بزنید وقتی ورودی not است کمی بیشتر است.
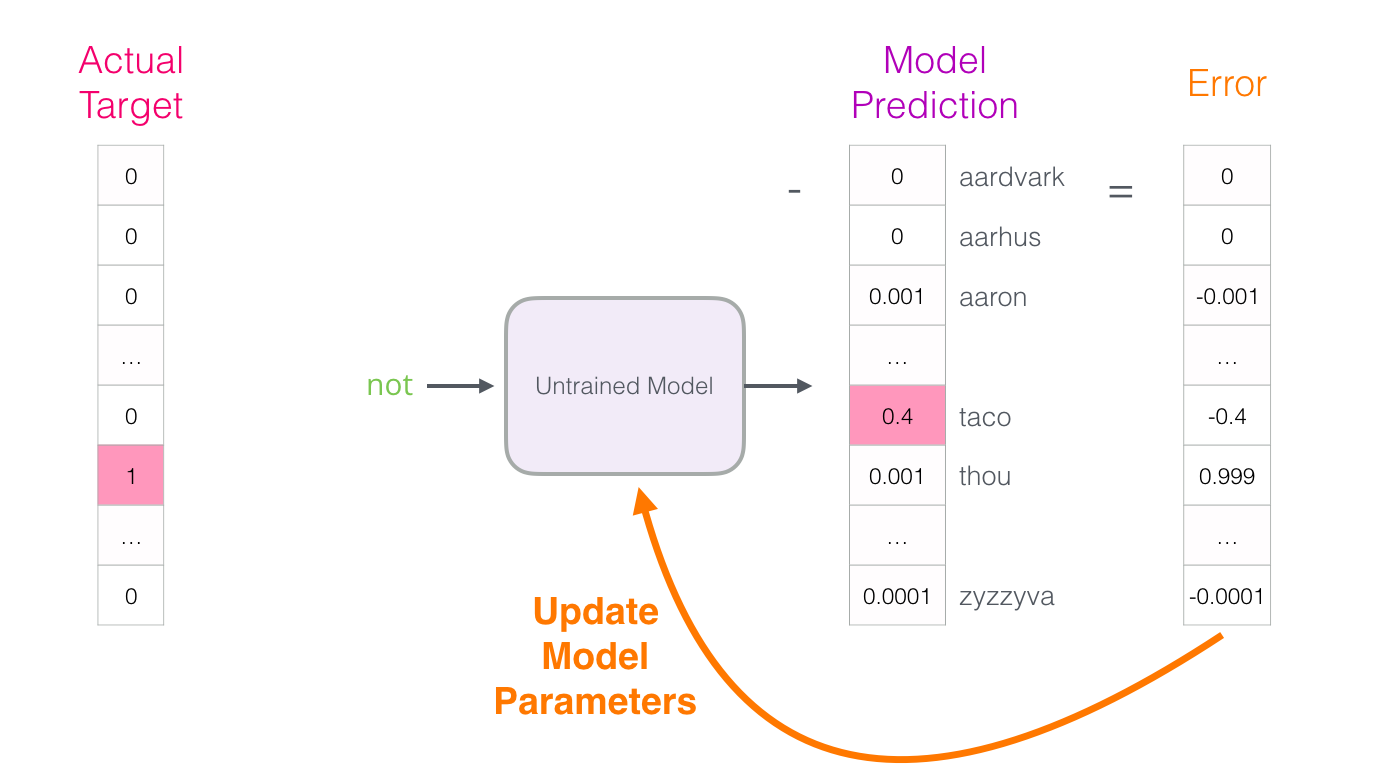
و اولین مرحله آموزش به پایان می رسد. همین کار را با نمونه بعدی در مجموعه داده خود انجام می دهیم و سپس سراغ نمونه بعد میرویم تا زمانی که همه نمونه های مجموعه داده را پوشش دهیم و این، نتیجه یک دوره (epoch) آموزش است. ما این کار را برای چندین دوره دوباره انجام می دهیم و سپس مدل آموزش دیده را داریم و می توانیم ماتریس جاسازی را از آن استخراج کرده و برای هر کاربرد دیگری از آن استفاده کنیم.
اگرچه آنچه یاد گرفتیم درک ما از روند کار گسترش می دهد، اما هنوز نحوه آموزش word2vec نیست. ما چند ایده اصلی را از دست داده ایم.
سه مرحله چگونگی محاسبه پیش بینی این مدل زبان عصبی را به یاد بیاورید:
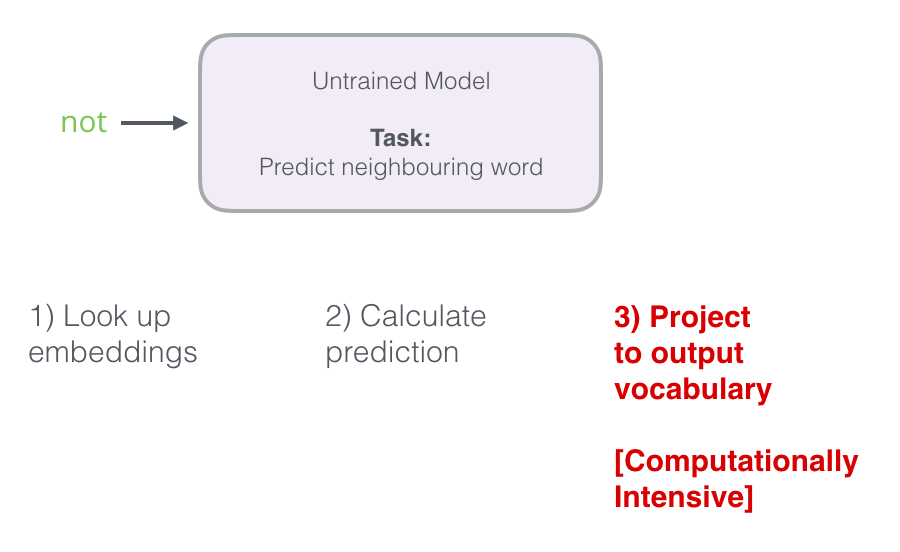
مرحله سوم از نظر محاسباتی بسیار پرهزینه است - خصوصاً اینکه بدانید ما این کار را فقط یک بار برای هر نمونه آموزش در مجموعه داده خود انجام نخواهیم داد (به راحتی ده ها میلیون بار). برای بهبود عملکرد باید کاری انجام دهیم.
یک راه تقسیم هدف به دو مرحله است:
بیایید روی مرحله 1 تمرکز خواهیم کنیم. در این مقاله همانطور که روی جاسازیها تمرکز داریم برای تولید جاسازیهای با کیفیت بالا برای استفاده در یک مدل با عملکرد بالا، ما می توانیم وظیفه مدل را از پیش بینی یک کلمه همسایه تغییر دهیم:
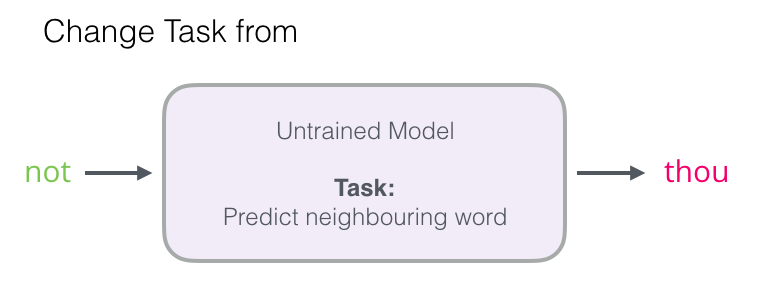
و آن را به مدلی تغییر دهید که کلمه ورودی و خروجی را می گیرد و نمره ای را به شما نشان می دهد که مشخص میکند همسایه هستند یا نه (0 برای "همسایه نیست" ، 1 برای "همسایه").
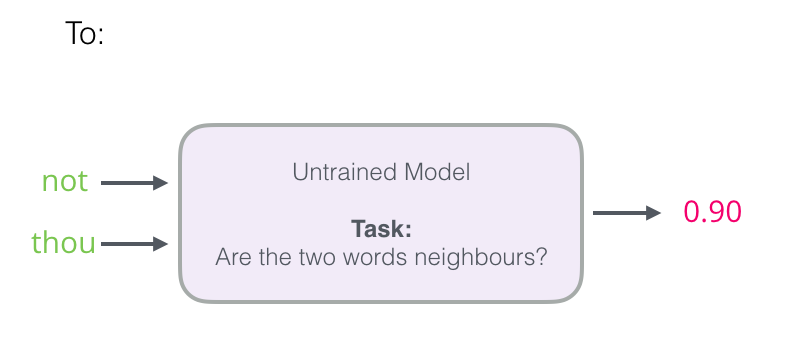
این تغییر ساده، مدل مورد نیاز ما را از یک شبکه عصبی به یک مدل رگرسیون لجستیک تغییر می دهد - بنابراین محاسبه آن بسیار ساده و سریعتر می شود.
این تغییر مستلزم آن است که ما ساختار مجموعه داده خود را تغییر دهیم - برچسب کنونی یک ستون جدید با مقادیر 0 یا 1 است که همه 1 خواهند بود زیرا تمام کلماتی که اضافه کردیم همسایه هستند.
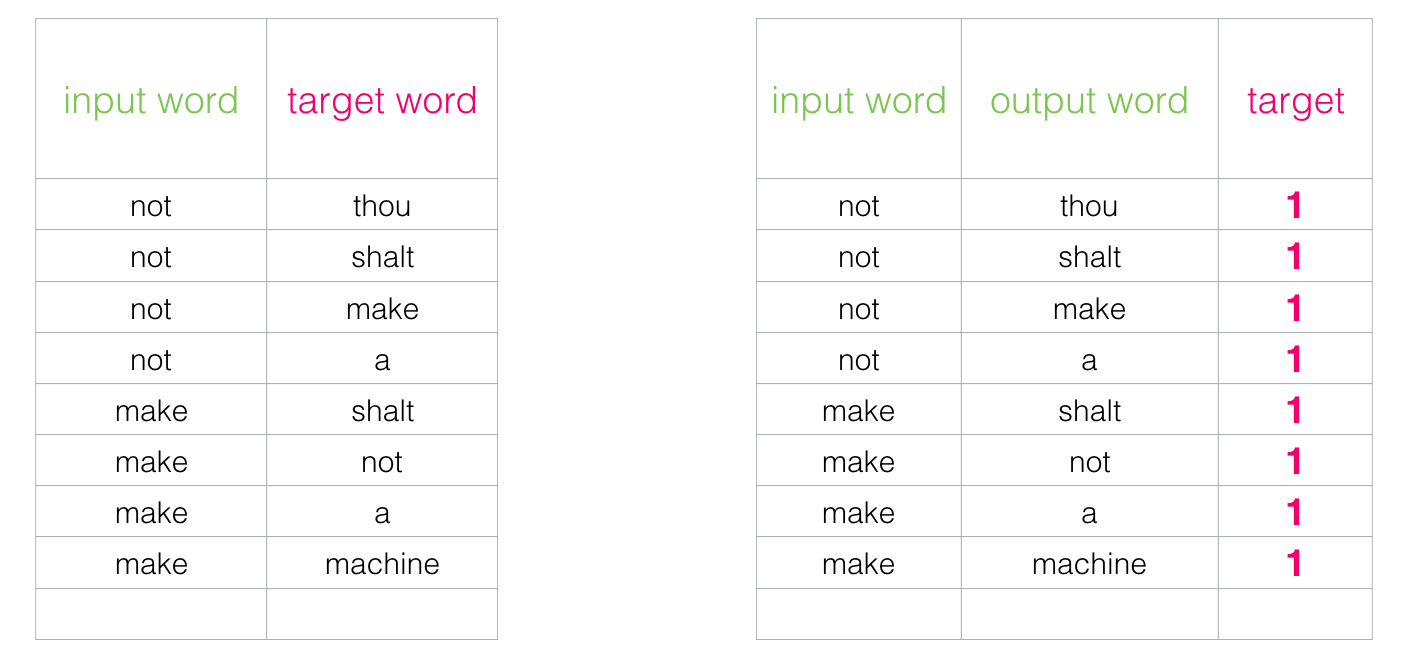
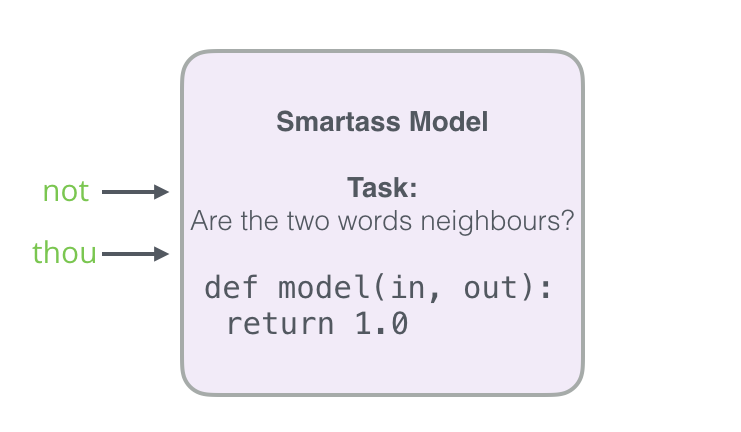
اکنون می توان محاسبات را با سرعت بسیار زیاد انجام داد و میلیون ها نمونه را در عرض چند دقیقه پردازش کرد. اما یک حفره وجود دارد که باید آن را ببندیم. اگر همه مثال ها مثبت باشند (هدف: 1) ، ما با مدل زرنگی روبرو هستیم که احتمالا همیشه 1 را برمی گرداند - دستیابی به 100٪ دقت ، اما چیزی یاد نگرفته و جاسازیهای آشغال ایجاد می کند.
برای حل این مشکل، باید نمونه های منفی را به مجموعه داده خود بخورانیم - نمونه کلماتی که همسایه نیستند و مدل ما برای آن نمونه ها باید مقدار 0 برگرداند. اکنون مدل با چالشی روبرو است که برای حل آن باید سخت تلاش کند اما هنوز هم با سرعت زیاد.
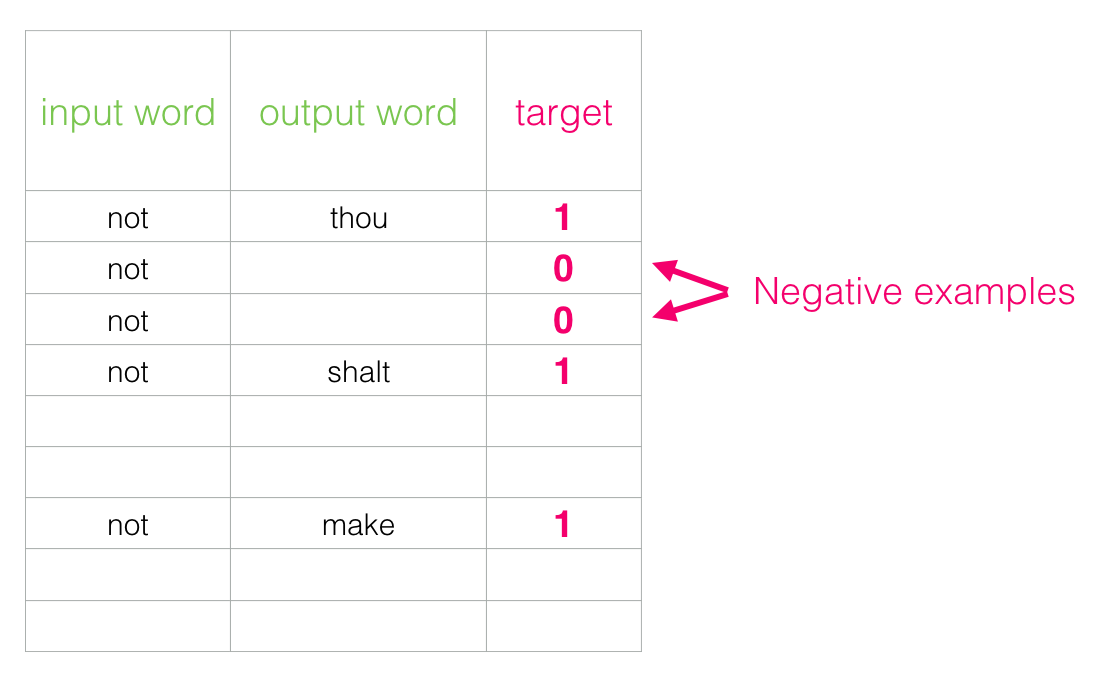
اما کلمات خروجی با چه چیزهایی پر می کنیم؟ ما کلمات را به طور تصادفی از واژگان خود انتخاب می کنیم
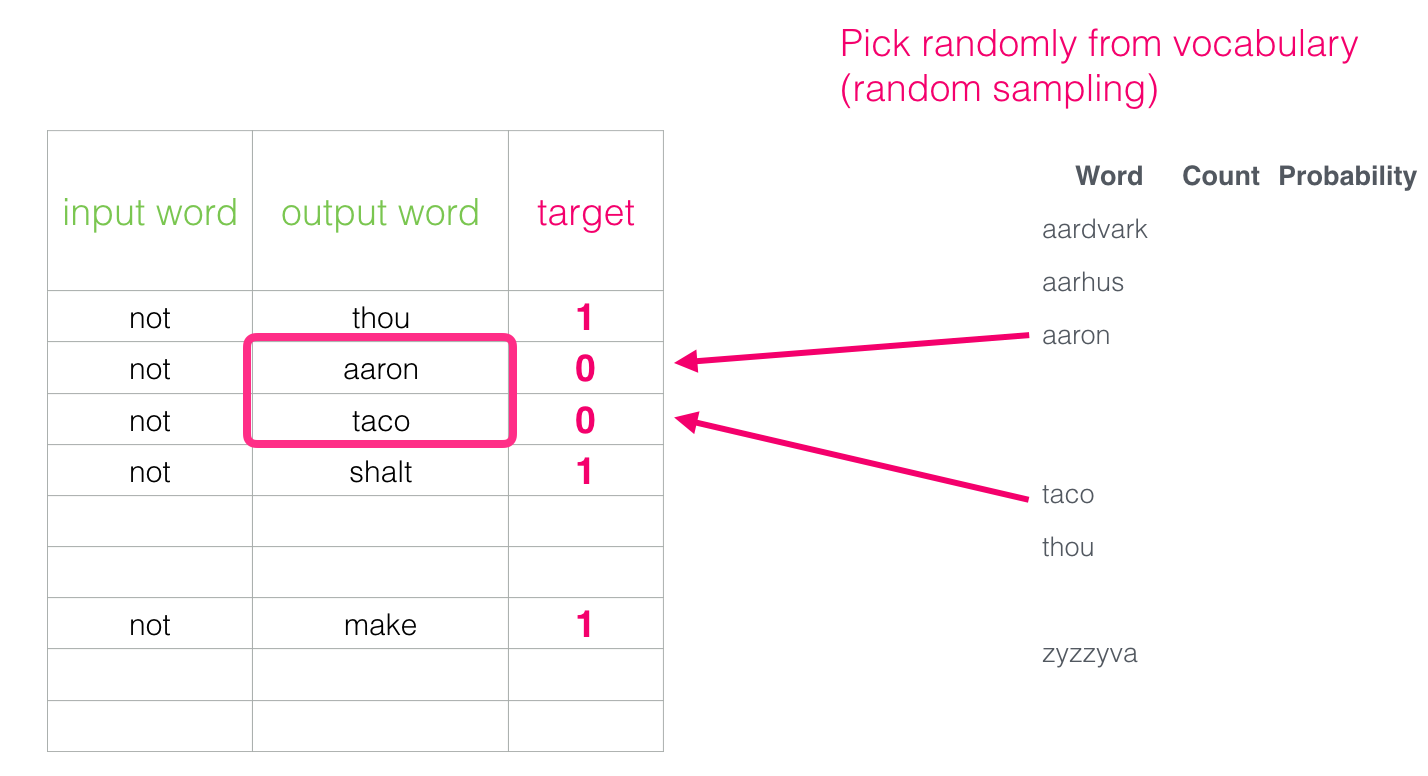
این ایده از برآورد انقباضی نویز الهام گرفته شده است. ما سیگنال واقعی (نمونه های مثبت کلمات همسایه) را با نویز (کلمات تصادفی انتخاب شده که همسایه نیستند) مقایسه می کنیم. این امر منجر به کارایی محاسباتی و آماری بالایی می شود.
اکنون این دو ایده را در word2vec می آوریم که به آنها skipgram با نمونه گیری منفی گفته می شود.
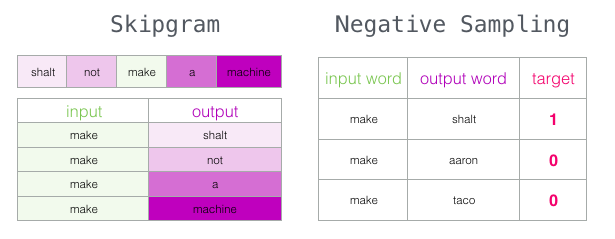
اکنون که دو ایده اصلی skipgram و نمونه گیری منفی را تثبیت کردیم ، می توانیم به روند آموزش word2vec نزدیک تر نگاه کنیم.
قبل از شروع فرایند آموزش ،متنی را که با آن در حال آموزش مدل هستیم، پیش پردازش می کنیم. در این مرحله ، ما اندازه واژه نامه را تعیین می کنیم (به این vocab_size می گوییم ، مثلاً 10000 واژه) و چه کلماتی به آن تعلق دارند.
در شروع مرحله آموزش ، ما دو ماتریس ایجاد می کنیم - یک ماتریس Embedding و یک ماتریس Context. این دو ماتریس برای هر کلمه در واژه نامه ما یک جاسازی دارد. (پس یکی از ابعاد آنها vocab_size است). بعد دوم به آن بستگی دارد که ابعاد جاسازی ما چقدر است(embedding_size = 300 یک مقدار معمول است ، اما ما قبلاً در این پست مقدار 50 داشتیم).
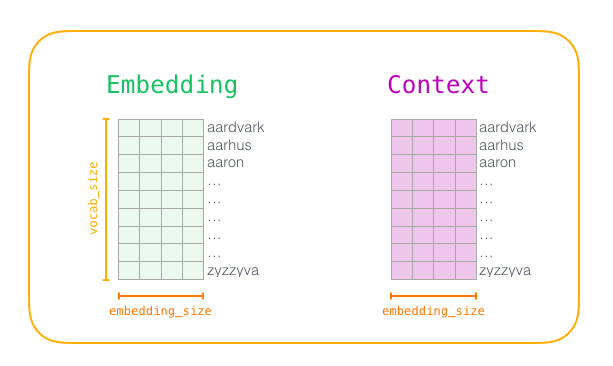
در آغاز فرایند آموزش ، ماتریس ها را با مقادیر تصادفی مقداردهی اولیه می کنیم. سپس مراحل آموزش را شروع می کنیم. در هر مرحله آموزش ، یک مثال مثبت و مثالهای منفی مرتبط با آن را در نظر می گیریم. بیایید اولین گروه را ببینیم:
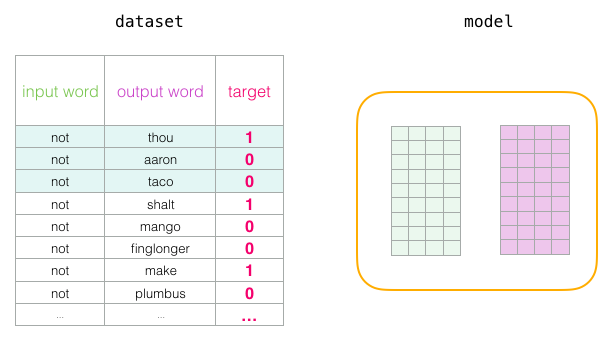
سپس ، ما ضرب داخلی از جاسازی کلمه ورودی با هر یک از جاسازیهای context را محاسبه می کنیم. در هر حالت ، این امر منجر به یک عدد می شود که نشان دهنده شباهت ورودی و متن جاسازی شده است.
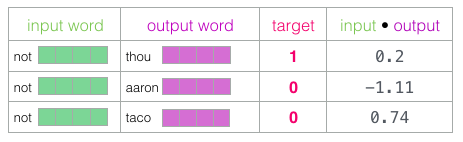
اکنون ما به روشی نیاز داریم که بتوانیم این امتیاز را به چیزی شبیه احتمالات تبدیل کنیم - باید همه مقادیر مثبت باشند و مقداری بین صفر تا یک داشته باشند. برای این یک کار تابع سیگموئید عالی است.
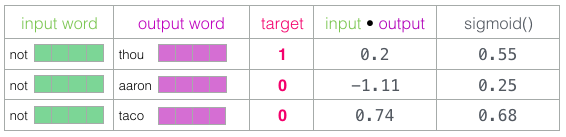
اکنون می توانیم خروجی تابع سیگموئید را به عنوان خروجی مدل برای این نمونه ها در نظر بگیریم. می بینید که taco بالاترین امتیاز را دارد و aaron هم قبل و هم بعد از عمل سیگموئید همچنان کمترین امتیاز را دارد.
اکنون که مدل آموزش ندیده پیش بینی کرده و با دیدن اینکه یک برچسب هدف واقعی برای مقایسه داریم ، بیایید محاسبه کنیم که خطای پیش بینی مدل چقدر است. برای انجام این کار ، ما فقط نمرات سیگموئید را از برچسب های هدف کم می کنیم.
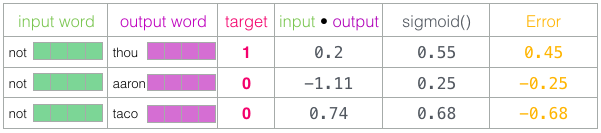
در اینجا دیگر بخش "یادگیری" از "یادگیری ماشین" است. اکنون می توانیم از این نمره خطا برای تنظیم جاسازیهای (not, thou, aaron, taco) استفاده کنیم تا دفعه بعد که این محاسبه را انجام دادیم ، نتیجه به امتیازات هدف نزدیکتر شود.
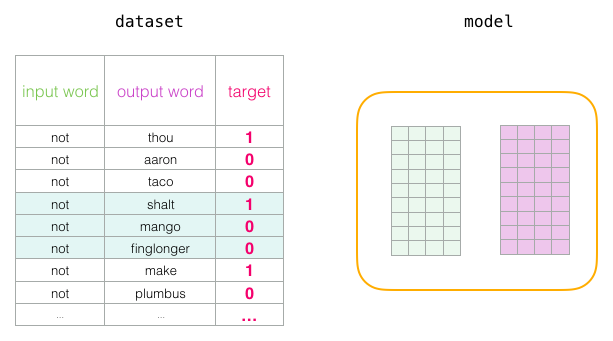
حال چندین بار در کل مجموعه داده حرکت میکنیم تا جاسازی ها بهبود یابند. سپس می توانیم روند آموزش را متوقف کنیم ، ماتریس Context را کنار بگذاریم و از ماتریس Embeddings به عنوان جاسازیهای آموزش دیده خود برای کار بعدی استفاده کنیم.
دو پارامتر اصلی در فرایند آموزش word2vec، اندازه پنجره و تعداد نمونه های منفی است.
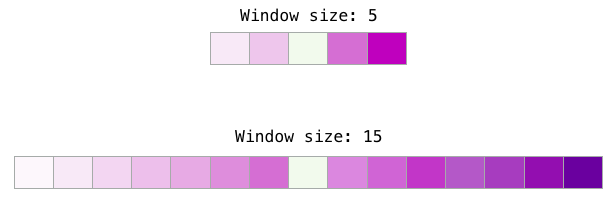
فعالیتهای مختلف با اندازه های مختلف پنجره بهتر انجام می شوند. یک ایده ابتکاری این است که اندازه پنجره های کوچکتر (2 تا 15) منجر به جاسازی هایی می شود که شباهت زیاد بین دو جاسازی نشان دهنده این است که کلمات در آن قابل تعویض هستند (توجه داشته باشید که کلمات متضاد اغلب قابل تعویض با یکدیگرند - اگر فقط به کلمات اطراف آنها نگاه کنیم - به عنوان مثال خوب و بد اغلب در متن های مشابه ظاهر می شوند). اندازه پنجره های بزرگتر (15تا 50 یا حتی بیشتر) منجر به جاسازیهایی می شود که در آن شباهت بیشتر نشان دهنده رابطه بین کلمات است. در عمل ،اغلب باید دلایلی ارائه دهید که روند جاسازی را هدایت کند و منجر به کارایی مفید برای کار شما شود. اندازه پنجره پیش فرض Gensim مقدار 5 است (دو کلمه قبل و دو کلمه بعد از کلمه ورودی ، علاوه بر خود کلمه ورودی).
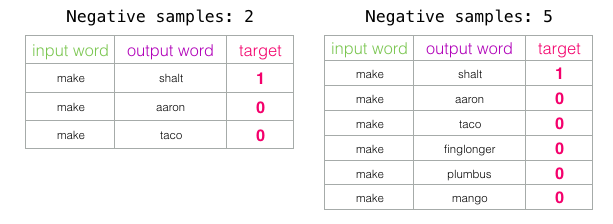
تعداد نمونه های منفی عامل دیگری در روند آموزش است. مقاله اصلی 5 تا 20 را به عنوان تعداد خوبی از نمونه های منفی تجویز می کند. همچنین بیان می کند که به نظر تعداد 2 تا 5 وقتی مجموعه دادهی کافی در اختیار داشته باشید کفایت میکند. پیش فرض Gensim تعداد 5 نمونه منفی است.
https://jalammar.github.io/illustrated-word2vec/

